Simuler la dynamique de Bose-Hubbard avec un choix d'encodage
Ce guide construit un circuit pour la dynamique temporelle du modèle de Bose-Hubbard unidimensionnel, depuis l'écriture de l'hamiltonien jusqu'à la vérification des densités de sites évoluées par rapport à une référence exacte. Ce qui rend cette approche intéressante tient en une seule idée :
Ne choisis pas d'encodage boson-vers-qubit lorsque tu construis le circuit. Construis le circuit sur des modes bosoniques, et laisse le transpileur décider comment ces modes deviennent des qubits.
Pour les bosons, il faut presque toujours différer l'encodage. Un mode bosonique peut contenir un nombre arbitraire de particules, son espace de Fock est donc de dimension infinie et aucun encodage n'existe tant que tu n'as pas choisi une troncature (le nombre de niveaux d'occupation que tu conserves). Dans le code, la troncature est donnée par la plus grande occupation qu'un mode peut contenir, max_occupation ; ainsi, un mode qui conserve les niveaux a max_occupation = 2 et .
La troncature devient ainsi un paramètre de l'encodage, et non de la physique, et c'est un paramètre que tu veux faire varier : trop petit et la réponse est fausse, trop grand et le circuit est inutilement large. Si tu différes l'encodage au moment de la transpilation, tu peux balayer la troncature sans changer le circuit, l'hamiltonien ni le regroupement.
Le guide des opérateurs pour la structure de données des opérateurs, le guide des mappeurs pour les encodages et la recette d'écriture d'un mappeur personnalisé, et le guide de transpilation pour les étapes du transpileur mentionnées tout au long du texte.
La troncature, et ce qu'elle coûte
Lorsque tu tronques un mode à niveaux, tu brises le commutateur canonique sur le plus haut niveau conservé [1], de sorte qu'aucun encodage n'est un isomorphisme d'algèbres : un encodage bosonique envoie des états, et des opérateurs agissant dans le sous-espace tronqué. Deux conséquences comptent pour tout ce qui suit :
-
doit borner l'occupation atteignable par la dynamique, et pas seulement celle de l'état initial.
-
Le mappage ne commute pas avec l'ordre normal ; décide donc une fois pour toutes si ton hamiltonien est défini sous forme ordonnée normalement, et reste cohérent.
Le guide des mappeurs dérive le défaut et montre les deux conséquences sur du code exécutable.
1. L'hamiltonien
Le modèle de Bose-Hubbard sur un réseau de liens est
avec . L'interaction compte les paires de bosons sur un site ; elle exige donc qu'un site puisse contenir deux particules à la fois. Sous ordre normal, , qui est la forme utilisée dans la suite.
La géométrie n'intervient que par la liste d'arêtes ; rien n'est donc spécifique à une chaîne :
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
Deux propriétés méritent d'être vérifiées en premier. L'hamiltonien doit être hermitien pour que soit unitaire, et il conserve le nombre total de bosons :
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
Passons maintenant à la question bosonique : combien de niveaux cet opérateur exige-t-il ?
>>> hamiltonian.max_occupation()
2
Le terme d'interaction applique deux opérateurs de création à un même mode ; un mode doit donc pouvoir contenir deux bosons pour que le terme agisse. Cela correspond à une occupation maximale de 2, qui est le nombre que LevelSpec prend comme max_occupation. Un mode qui conserve les occupations a niveaux ; max_occupation >= 2 est donc la même exigence que .
Il ne s'agit que d'une borne inférieure : elle provient d'une seule application de l'opérateur, et des applications répétées au cours d'une évolution temporelle peuvent aller plus loin. Elle écarte les coupures qui sont certainement trop petites, et l'étape 6 établit, pour ce modèle et cet état, quelle doit être la taille de la coupure. mode_occupations() indique la borne pour chaque mode séparément, ce à quoi on compare une coupure par mode.
2. Regrouper avant de mapper
L'évolution est trotterisée, et la façon dont l'hamiltonien est partitionné détermine ce qui est transmis à la synthèse. Deux considérations vont dans le même sens.
D'abord, une raison physique : le terme de saut individuel n'est pas hermitien. Seule la paire l'est. Si tu évolues sous un seul terme non hermitien, l'opération n'est pas unitaire, et l'opérateur mappé porterait des coefficients complexes que PauliEvolutionGate rejette. Les deux termes de saut de chaque lien doivent donc rester ensemble.
Ensuite, une raison d'efficacité : tous les termes d'interaction sur site sont diagonaux dans la base d'occupation et commutent entre eux ; ils peuvent donc partager un même groupe et être synthétisés ensemble. Il en va de même pour les liens qui ne touchent aucun site commun. Sur une chaîne, un lien sur deux forme un tel ensemble : les liens 0 et 2 agissent sur des paires de modes disjointes, leurs termes de saut commutent donc et peuvent partager un groupe, et le lien 1 forme un groupe à lui seul. Si tu regroupes les liens pairs et impairs, il te faut donc trois groupes, là où un groupe par lien en demande quatre. Moins de groupes signifie moins de facteurs, et aussi un circuit moins profond : avec le code de Gray à max_occupation = 2, la profondeur à deux qubits est de 95 contre 139. Le réseau décide quels liens peuvent partager un groupe, c'est pourquoi la partition est choisie ici.
L'attribut groups transporte cette décision jusque dans le circuit : une porte Evolution sur un opérateur groupé se décompose en une sous-évolution par groupe. La partition est choisie au niveau bosonique, tant que la structure du réseau est encore visible, et elle survit intacte au mappage. Le guide du regroupement couvre les vérifications qu'un regroupement doit passer.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
Chaque groupe doit lui-même être hermitien, ce que l'appariement précédent garantit. groups_are_hermitian() vérifie tous les groupes en un seul appel :
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Pour voir ce que contient chaque groupe, sépare les groupes :
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
Le regroupement pair-impair est un choix, et l'alternative est facile à mesurer. Si tu donnes à chaque lien son propre groupe, il te faut quatre groupes, et le même circuit coûte alors plus de profondeur à deux qubits. La profondeur est comptée après abaissement du circuit avec le code de Gray à max_occupation = 2, ce que l'étape 4 explique :
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. Le circuit bosonique
Remarque ce qui est absent du circuit : il n'y a ni troncature, ni encodage, ni nombre de qubits. Il agit sur quatre modes bosoniques :
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

Les fils sont des modes bosoniques, pas des qubits. Note que InitializeModes prend des entiers, et non des indicateurs : un mode peut contenir un nombre quelconque de bosons, un état de Fock est donc une liste de nombres d'occupation.
Un seul appel à decompose() transforme le regroupement de l'étape 2 en une porte par groupe :
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
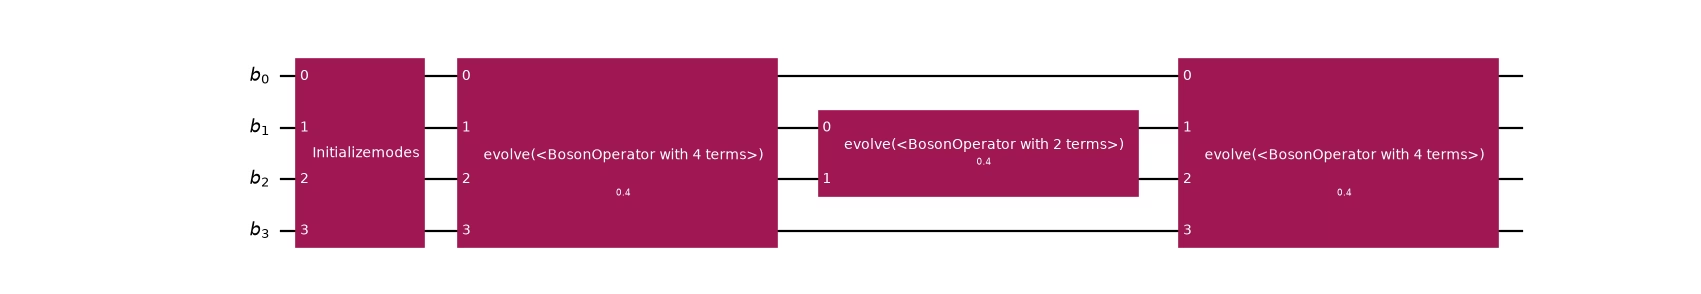
Le premier groupe contient les liens sur les modes 0 et 1 et sur les modes 2 et 3 ; sa porte couvre donc les quatre modes, tout comme le groupe sur site. Le lien du milieu a sa propre porte sur les modes 1 et 2.
Si tu sautes cette décomposition, le regroupement est simplement ignoré. La méthode qui effectue le découpage est la synthesis de la porte, avec BosonicLieTrotter par défaut ; Synthétiser une porte Evolution dans l'espace bosonique présente les alternatives.
4. Choisir l'encodage au moment de la transpilation
Voici le bénéfice. Le même circuit est abaissé quatre fois, sous quatre valeurs différentes de LevelEncoding, en changeant un seul argument. Un LevelSpec associe l'encodage à la troncature de chaque mode, et le preset suivant dérive la disposition, la préparation d'état et le mappage des opérateurs de cette seule spécification (voir Décrire la troncature avec un LevelSpec). Une chaîne telle que "gray" est acceptée partout où un LevelEncoding l'est.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
Ces chiffres contredisent une intuition naturelle. Les encodages unaires utilisent qubits par mode contre pour les codes compacts, et à les codes compacts gagnent sur les deux tableaux à la fois : moins de qubits et bien moins de portes intriquantes. Les deux variantes unaires diffèrent par l'opérateur qu'elles émettent, pas par leur disposition : LevelEncoding.UNARY_PROJECTED porte un projecteur sur un qubit sur deux d'un mode, ce qui en fait le plus coûteux des quatre à évoluer, et LevelEncoding.UNARY_UNPROJECTED omet les projecteurs et s'accorde avec lui sur le sous-espace one-hot. Le guide des mappeurs montre les deux opérateurs côte à côte, et explique pourquoi le code de Gray bat le binaire standard (SB) sur les termes de saut.
Sawaya et al. rapportent le même classement [2] :
bien que le code unaire tende à nécessiter plus de qubits mais moins d'opérations, il arrive souvent que le code SB ou de Gray soit plus efficace à la fois en nombre de qubits et en nombre d'opérations
Leur conclusion est que le meilleur code dépend de l'hamiltonien et de , ce qui est l'argument le plus fort pour ne pas figer ce choix dans le circuit.
Sous un encodage de niveaux, un mode s'étend sur plusieurs qubits ; le registre de qubits est donc plus large que le registre de modes. Le preset utilise OccupationB2QLayout, qui dérive la largeur du registre de LevelSpec. Le guide de transpilation détaille les étapes que le preset exécute.
5. Vérifier par rapport à la dynamique exacte
Aucune des étapes précédentes n'établit que le circuit est correct. Pour cela, compare les densités de sites après évolution à une référence exacte calculée sur l'hamiltonien encodé.
La référence doit être calculée dans le même espace tronqué que celui où travaille le circuit, car la comparer à un calcul non tronqué confondrait l'erreur de Trotter et l'erreur de troncature, qui sont deux choses différentes qu'il vaut mieux séparer (voir Tronquer l'espace de Fock).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
Avec ces éléments en main, voici l'évolution exacte dans l'espace tronqué :
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
Les bosons se répandent de l'extrémité occupée de la chaîne vers l'extrémité vide, et les deux bosons sont conservés :
>>> bool(np.isclose(sum(reference), 2.0))
True
Passons au circuit. Note que la référence précédente a été construite directement à partir de initial ; le circuit comparé à elle ne doit donc contenir que l'évolution, car la porte InitializeModes préparerait de nouveau un état déjà préparé.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
L'erreur est divisée par deux lorsque le nombre de pas double, ce qui est la signature en d'une formule de produit du premier ordre. C'est la preuve que l'écart est une erreur de Trotter et que l'encodage est fidèle.
Les répétitions proviennent de la synthesis de la porte, qui trotterise dans l'espace bosonique où le regroupement existe encore : chaque pas applique chaque groupe une fois, et les pas se suivent. C'est différent de passer un LieTrotter avec reps > 1 au plugin de synthèse au niveau des qubits. Là, chaque groupe est déjà sa propre PauliEvolutionGate ; la formule ne fait donc que subdiviser les termes au sein d'un groupe et n'entrelace jamais les groupes. Les groupes ne commutent pas entre eux, ce qui laisse un seul pas de Trotter externe dont l'erreur ne diminue pas, quelle que soit la valeur de reps. Synthétiser une porte Evolution dans l'espace bosonique compare les deux et traite les ordres supérieurs.
L'appel précédent à decompose() est essentiel. evolve() utilise la définition exacte d'une PauliEvolutionGate et contourne entièrement la formule de produit. Si tu vérifies avec un circuit non décomposé, tu obtiens un accord quasi parfait même pour une synthèse délibérément fausse. Le circuit non décomposé force aussi la construction d'un opérateur dense , alors qu'un circuit décomposé applique les portes une à une. D'autres simulateurs peuvent traiter la porte différemment ; cette vérification dépend donc du simulateur, alors que le matériel exige toujours la forme décomposée.
Enfin, la vérification centrale : la physique ne doit pas dépendre de l'encodage choisi.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
Les nombres de qubits, les structures de Pauli et les profondeurs de circuit diffèrent tous, et la physique concorde à dix décimales. L'encodage est un choix d'implémentation, ce qui explique pourquoi il relève du transpileur. Les deux variantes unaires concordent ici parce que l'état simulé reste dans le sous-espace one-hot ; en dehors de celui-ci, elles différeraient.
6. La troncature est un paramètre de convergence
La dernière étape est propre aux bosons. Jusqu'ici, tout avait fixé max_occupation = 2, c'est-à-dire . Pourtant, la troncature n'est pas un choix libre : c'est un paramètre de convergence, et une réponse n'est fiable qu'une fois qu'elle cesse de bouger (voir Tronquer l'espace de Fock).
Le circuit ne porte aucune troncature ; le circuit lui-même ne change donc pas quand la coupure change : seule la transpilation est répétée. Ce qui change, c'est la taille de ce qui en sort, et un balayage n'est aussi peu coûteux qu'ici que parce que le système est minuscule. La référence suivante est une simulation classique exacte de la dynamique tronquée, ce qui est possible pour quatre sites et croît exponentiellement avec le nombre de qubits. Pour un problème hors de cette portée, il n'existe aucune référence exacte à laquelle comparer, et la convergence doit être jugée par d'autres moyens.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
À max_occupation = 1 (), chaque site contient au plus un boson ; le terme d'interaction, qui en exige deux sur un site, ne peut donc pas agir du tout, et les densités sont fausses d'environ . Quand tu ajoutes le troisième niveau, le résultat capture l'interaction, et à partir de max_occupation = 3 le résultat est stationnaire à la précision machine : convergé.
La raison pour laquelle cela s'arrête à max_occupation = 2 est le nombre de particules. L'hamiltonien conserve le nombre de bosons, et cet état en contient deux ; aucun site ne peut donc jamais en contenir plus de deux, quelle que soit la durée d'évolution et que l'interaction soit répulsive ou attractive. Si tu évolues jusqu'à au lieu de , ou si tu inverses le signe de , les densités à max_occupation = 2 et au-delà restent inchangées à près.
Ce qui relève vraiment l'exigence, c'est le nombre de bosons. Trois bosons sur la même chaîne changent d'environ entre max_occupation = 2 et 3 après la même courte évolution, et d'environ après . C'est un constat sur ce modèle et une quantité conservée, et ce n'est une borne que pour des opérateurs qui conservent le nombre de particules ; ce n'est pas une règle générale, la coupure doit donc être balayée, pas devinée.
Le balayage a aussi un prix côté circuit, que la référence exacte ne montre pas. Le même circuit bosonique, abaissé avec le code de Gray à chaque coupure :
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
Chaque niveau supplémentaire coûte de la profondeur, et le nombre de qubits saute chaque fois que dépasse une puissance de deux. Quand tu converges en , tu échanges donc la précision contre la taille du circuit, et le balayage est donc plus qu'une vérification numérique.
Note aussi que le fait que soit presque correct est une coïncidence de l'observable : les densités de sites bougent à peine, alors que l'état sous-jacent est qualitativement faux (il n'a pas de composante doublement occupée). Si une observable converge, cela ne montre pas qu'une autre a convergé.
Ce qu'il faut retenir
-
L'encodage est une affaire de transpilation. Le circuit bosonique de l'étape 3 ne mentionne ni troncature, ni encodage, ni nombre de qubits. Quatre encodages l'ont ensuite abaissé en quatre circuits différents, qui reproduisent tous la même physique. Rien en amont du transpiler n'a eu à changer.
-
Pour les bosons, ce n'est pas seulement pratique. La troncature est un paramètre de convergence qu'il faut balayer, et elle vit à l'intérieur de l'encodage. Un circuit construit pour un encodage fixe devrait être reconstruit pour chaque valeur de .
-
Groupe avant de mapper, et groupe pour l'hermiticité. Un terme de saut isolé n'est pas hermitien et ne peut pas être exponentié ; la paire de liaison, elle, est hermitienne et peut donc être exponentiée. Décide de la partition au niveau bosonique, là où le réseau est encore visible. C'est physiquement nécessaire, et l'attribut
groupsexiste pour transmettre cette décision plus loin. -
Ne suppose pas que l'encodage à faible poids est le moins coûteux. À , les codes compacts battent les deux variantes unaires à la fois en qubits et en portes, et la variante projetée est la plus coûteuse de toutes. Mesure ; le point de croisement dépend de .
-
La troncature brise l'algèbre, de façon quantifiable. Uniquement sur le plus haut niveau conservé, de . C'est aussi pourquoi le mapping ne commute pas avec l'ordre normal.
Étapes suivantes
Deux directions prolongent cet exemple. Si tu remplaces la liste d'arêtes de la chaîne par les liaisons d'un réseau carré, aucun autre changement n'est nécessaire, car la fonction bose_hubbard définie plus haut est déjà indépendante de la géométrie. Un encodage personnalisé de ton cru (un code par blocs unaires, par exemple, qui interpole entre unaire et compact) s'intègre aussi par le même point d'extension MapperFnEvolutionSynthesis que celui utilisé par le preset.
-
Principes de conception des représentations d'opérateurs explique la structure de données d'opérateur derrière le hamiltonien.
-
Mapper les représentations d'opérateurs présente les encodages et l'écriture de ton propre mapper.
-
Transpiler des circuits bosoniques détaille les étapes que le preset exécute.
-
Synthétiser une porte d'évolution dans l'espace bosonique montre comment réduire l'erreur de Trotter dans l'espace bosonique.
Toutes les profondeurs indiquées sont mesurées sur un registre abstrait entièrement connecté. Le mapping vers la connectivité d'un matériel réel est une étape distincte, et les blocs de qubits par mode d'un encodage d'occupation donnent à un routeur une structure assez différente de celle d'un qubit par mode.
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.