Postsélection avec vérifications d'erreurs non markoviennes
Ce guide explique ce que sont les vérifications d'erreurs non markoviennes et comment les implémenter en logiciel avec qiskit-mitigation. Tu commenceras par un petit exemple à deux qubits pour visualiser les vérifications et discuter de leur fonctionnement. Une fois que tu auras développé une certaine intuition, tu essaieras un exemple à 20 qubits où tu implémenteras des vérifications et compareras diverses stratégies de postsélection.
Que sont les vérifications d'erreurs non markoviennes ?
Les vérifications d'erreurs non markoviennes sont des tests basés sur la mesure qui déterminent si l'état d'un qubit est probablement corrompu par une source d'erreur non markovienne. Ce test consiste à placer une Gate de bit-flip de durée prolongée (xslow ou une série de Gates rx d'angle ) sur chaque qubit au début d'un circuit, suivie d'une XGate ordinaire et d'une mesure pour s'assurer que l'état a bien basculé de . Ce test peut aussi être effectué à la fin du circuit après chaque mesure terminale pour s'assurer que l'appareil peut basculer avec succès l'état mesuré du qubit de . Les échantillons associés à des vérifications échouées peuvent être considérés comme peu fiables, et ne postsélectionner que les échantillons qui passent toutes les vérifications peut améliorer la fidélité de la distribution bruitée.
Stratégies de postsélection fondées sur les vérifications d'erreurs non markoviennes
-
Postsélection par nœud : ne postsélectionne que les échantillons pour lesquels chaque qubit a passé sa ou ses vérifications. C'est la stratégie la plus stricte et elle entraîne généralement le rejet d'un plus grand nombre d'échantillons.
-
Postsélection par arête : pour chaque arête du graphe de couplage des qubits, assure-toi qu'au moins un qubit passe la ou les vérifications. Cette stratégie est plus indulgente ; si un qubit échoue à une vérification, l'échantillon peut tout de même être conservé si tous ses voisins passent leurs vérifications.
Qubits spectateurs
On peut spécifier des qubits ancilla « spectateurs » adjacents aux qubits utilisés pour exécuter le circuit d'origine. Des vérifications d'erreurs non markoviennes peuvent être placées sur ces spectateurs, offrant une meilleure couverture contre le bruit non markovien que ces vérifications sont conçues pour détecter.
Partie 1. Visualiser les vérifications d'erreurs non markoviennes
Avant de démontrer la technique sur un QPU, tu vas créer un petit circuit à deux qubits et y ajouter des vérifications pour visualiser son fonctionnement. Commence par un état de Bell transpilé vers le QPU Backend ibm_kingston.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend("ibm_kingston")

qc = QuantumCircuit(2)
qc.h(0)
qc.cx(0, 1)
qc.measure_all()
qc_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(qc)
qc_isa.draw("mpl")

Ajoute quelques vérifications d'erreurs non markoviennes au début du circuit. Les vérifications ne seront placées que sur les qubits qui se terminent par une mesure. Ces vérifications s'assurent que l'appareil peut basculer avec succès l'état initial du qubit de , et les mesures de ces vérifications sont lues dans un nouveau registre classique appelé meas_pre.
from qiskit.transpiler import PassManager
from qiskit_mitigation.postselection.passes import (
    AddPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPreCircuitNonMarkovianErrorChecks()]).run(
    qc_isa
)
qc_w_checks.draw("mpl", idle_wires=False)

De même, tu peux ajouter des vérifications à la fin du circuit après chaque mesure terminale. Ces vérifications s'assurent que l'appareil peut basculer l'état du qubit de , et leurs mesures sont lues dans un nouveau registre classique appelé meas_ps.
from qiskit_mitigation.postselection.passes import (
    AddPostCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPostCircuitNonMarkovianErrorChecks()]).run(
    qc_w_checks
)
qc_w_checks.draw("mpl", idle_wires=False)

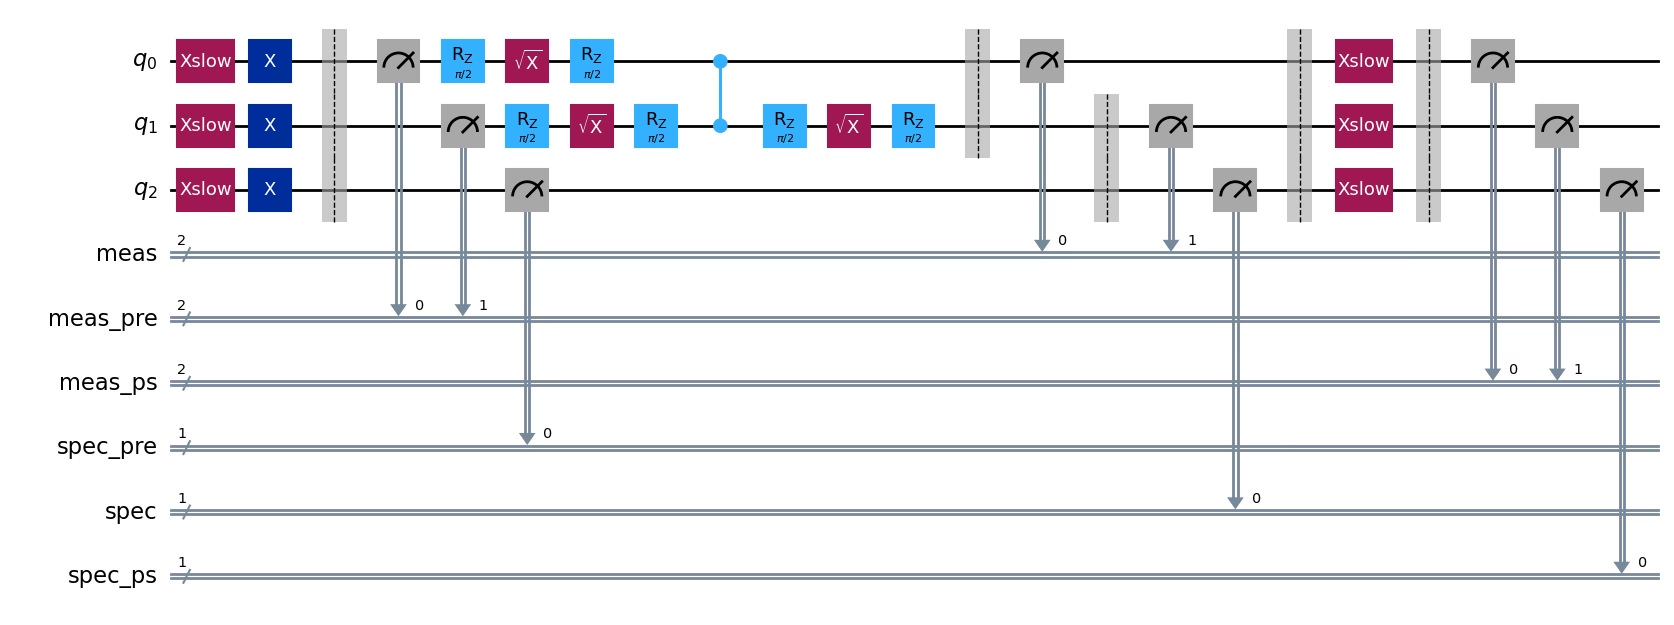
Comme mentionné dans l'introduction, tu peux utiliser des qubits ancilla adjacents aux qubits de données comme « spectateurs » pour offrir une plus grande couverture d'erreurs. Ajoute des vérifications spectatrices avant et après le circuit. Tu peux voir que, puisque le qubit physique 2 de ibm_kingston est adjacent au qubit de données 1, il a été ajouté comme spectateur, et des vérifications avant et après le circuit lui ont été ajoutées. Les mesures des spectateurs ont été ajoutées à de nouveaux registres classiques appelés spec_pre et spec.
Un circuit comme celui-ci contient toutes les vérifications d'erreurs non markoviennes possibles, donc échantillonner à partir de ce circuit permet aux utilisateurs de postsélectionner selon n'importe quelle combinaison de vérifications [avant/après]-circuit et de stratégie de postsélection basée sur les [nœuds/arêtes]. Consulte la partie 2 de ce guide pour voir comment cela fonctionne sur du matériel quantique.
from qiskit_mitigation.postselection.passes import (
    AddSpectatorPostCircuitNonMarkovianErrorChecks,
    AddSpectatorPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager(
    [
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
    ]
).run(qc_w_checks)
qc_w_checks.draw("mpl", idle_wires=False, fold=-1)
Partie 2 : démontrer les vérifications d'erreurs non markoviennes sur un QPU et comparer les stratégies de postsélection
Maintenant que tu comprends ce que sont les vérifications d'erreurs non markoviennes et comment elles sont implémentées dans le logiciel, tu peux exécuter un exemple plus grand sur un QPU et voir comment cela fonctionne. Commence par préparer un circuit. Le choix du circuit n'a pas beaucoup d'importance ; il te faut seulement un circuit dont tu peux vérifier facilement le résultat. Ici, nous choisissons un circuit d'Ising miroir 1D à 20 qubits. Ce circuit n'est pas trivial à exécuter sur du matériel et devrait être affecté par des erreurs non markoviennes, ce qui permet de démontrer l'efficacité des vérifications d'erreurs non markoviennes. De plus, la structure miroir nous permet de comparer trivialement les calculs de valeurs moyennes bruitées aux valeurs exactes.
Dans cette expérience, nous calculons des valeurs moyennes d'observables. Le choix de l'observable n'est pas important non plus, donc nous choisissons simplement l'aimantation moyenne par site .
import numpy as np
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import CouplingMap

num_qubits = 20
initial_layout = initial_layout = [
    124,
    125,
    126,
    127,
    128,
    129,
    130,
    131,
    132,
    133,
    134,
    135,
    139,
    155,
    154,
    153,
    152,
    151,
    150,
    149,
][:num_qubits]
coupling_map = CouplingMap.from_line(num_qubits, bidirectional=False)

# Num Trotter steps and `rx` angle
num_steps = 6
theta_rx = np.pi / 6

# Average single-site magnetization
observable = (
    SparsePauliOp(
        [
            "I" * iq + "Z" + "I" * (num_qubits - iq - 1)
            for iq in range(num_qubits)
        ]
    )
    / num_qubits
)

# Create the Trotter circuit
circuit = QuantumCircuit(num_qubits)
edges = CouplingMap.from_line(num_qubits, bidirectional=False).get_edges()
edges_a = [e for e in edges if e[0] % 2 == 0]
edges_b = [e for e in edges if e[0] % 2 == 1]
for _ in range(num_steps):
    circuit.rx(theta_rx, [i for i in range(num_qubits)])
    for edge in edges_a:
        circuit.cz(edge[0], edge[1])
    for edge in edges_b:
        circuit.cz(edge[0], edge[1])
circuit = circuit.compose(circuit.inverse())
circuit.measure_all()

# Transpile circuit to backend
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=initial_layout
)
isa_circuit = pm.run(circuit)
print(
    f"two-qubit depth: {isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)}"
)
print(f"total depth:     {isa_circuit.depth()}")
isa_circuit.draw("mpl", fold=-1, idle_wires=False)
two-qubit depth: 24
total depth:     85
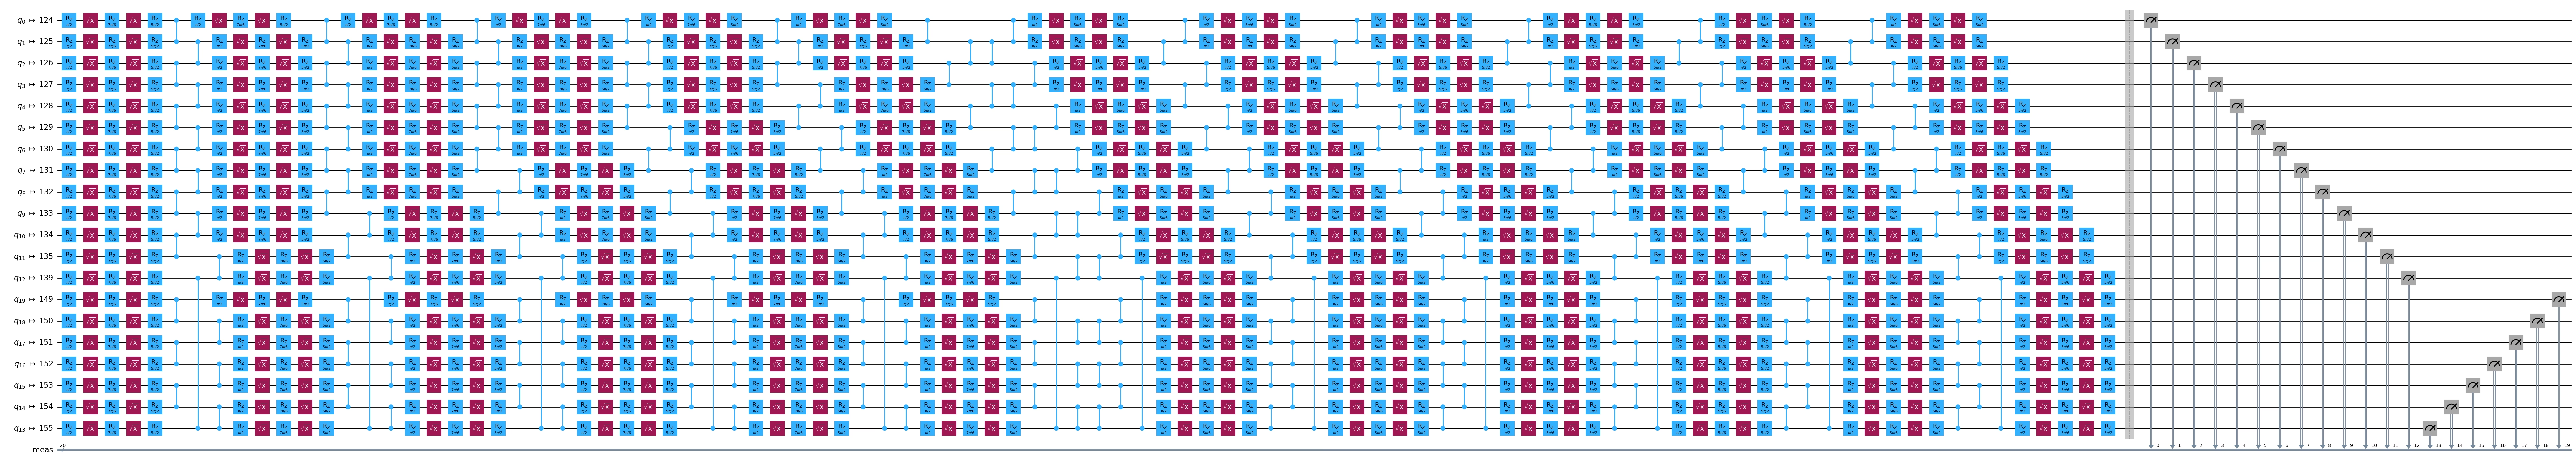
Nous ajoutons maintenant des vérifications avant et après le circuit sur chaque qubit, y compris les sept qubits spectateurs adjacents. Quand tu ajoutes toutes les vérifications possibles à un circuit, tu peux décider quelle stratégie de postsélection utiliser pendant le post-traitement.
# Use all non-Markovian error checks so we can compare all strategies in post-processing.
combined = PassManager(
    [
        AddPreCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
        AddPostCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
    ]
).run(isa_circuit)
combined_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(combined)

print("cregs:", [(c.name, c.size) for c in combined_isa.cregs])
cregs: [('meas', 20), ('meas_pre', 20), ('spec_pre', 7), ('meas_ps', 20), ('spec', 7), ('spec_ps', 7)]
Utilise la primitive Executor pour échantillonner le circuit contenant les vérifications.
from qiskit_ibm_runtime import Executor
from samplomatic.quantum_program import QuantumProgram

# Raw and combined-checks circuits in a single 100k-shot program so they share calibration.
program = QuantumProgram(shots=100_000)
program.append_circuit_item(isa_circuit)  # raw circuit, no checks
program.append_circuit_item(
    combined_isa
)  # combined pre + post non-Markovian error checks
job = Executor(backend).run(program)
print(f"job id: {job.job_id()}")
print(f"status: {job.status()}")
job id: d9badrm6hjac73ffe31g
status: QUEUED
La classe PostSelector connaît la structure creg des vérifications, donc elle peut associer chaque bit des échantillons à la mesure de circuit correspondante. Sa méthode compute_mask peut être utilisée pour créer un masque sur une séquence d'échantillons, étant donné la stratégie de postsélection (nœud ou arête) et le type de vérifications d'erreurs non markoviennes à examiner (avant ou après le circuit). Pour combiner les stratégies avant et après le circuit en un seul masque, leurs masques peuvent être calculés indépendamment puis combinés avec l'opération AND. Ici, nous utilisons le PostSelector pour créer des masques pour toutes les stratégies et examiner les résultats avec chaque permutation de stratégies disponible.
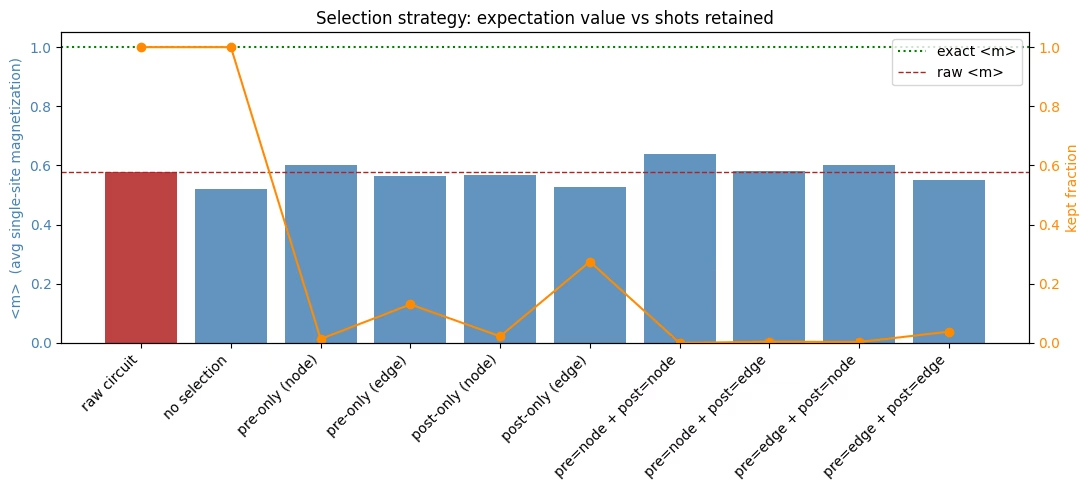
Dans la visualisation ci-dessous, nous voyons comment la stratégie de postsélection affecte le taux de postsélection ainsi que la qualité de la réponse. Comme prévu, les stratégies impliquant une postsélection basée sur les nœuds ont donné les taux de postsélection les plus bas. Les stratégies basées sur les arêtes sont plus indulgentes et tendent à donner des taux de postsélection plus élevés. Les utilisateurs devraient expérimenter les différentes stratégies sur leur problème pour déterminer le bon équilibre entre le taux de postsélection et la qualité de la distribution échantillonnée. Dans cet exemple, l'utilisation de la postsélection basée sur les nœuds avec les vérifications avant et après le circuit a donné la meilleure réponse, avec un taux de postsélection de .028%. Certaines stratégies n'ont pas fait mieux que le circuit brut. Tu peux aussi voir qu'ajouter les vérifications sans en utiliser aucune (barre étiquetée « no selection » dans le graphique ci-dessous) donne les pires résultats.
import matplotlib.pyplot as plt
from qiskit_mitigation.postselection import PostSelector

selector = PostSelector.from_circuit(combined_isa, backend.coupling_map)

exec_results = job.result()
# The Executor returns numpy arrays keyed by classical-register name, so each result item is
# already the {creg_name: ndarray} mapping that compute_mask expects.
raw_bits = exec_results[0]["meas"]  # raw circuit, no checks
bits = exec_results[1]  # combined pre+post circuit

meas_bits = bits["meas"]
total = meas_bits[..., 0].size

def magnetization(b, mask=None):
    """Average single-site magnetization over the (optionally masked) measurement bits."""
    kept = b if mask is None else b[mask]
    return (1 - 2 * kept.astype(int)).mean()  # bit 0 -> +1, bit 1 -> -1

rows = []

def report(label, mask=None, b=meas_bits):
    """Record and print the magnetization and kept fraction for one selection strategy."""
    kept = b[..., 0].size if mask is None else int(mask.sum())
    ev = magnetization(b, mask)
    rows.append((label, ev, kept / total))
    print(f"{label:<24}: <m> = {ev:+.4f}   (kept {kept:>6}/{total})")

# Compare all possible postselection strategies
report("raw circuit", b=raw_bits)
report("no selection")
for s in ("node", "edge"):
    report(f"pre-only ({s})", selector.compute_mask(bits, s, mode="pre"))
for s in ("node", "edge"):
    report(f"post-only ({s})", selector.compute_mask(bits, s, mode="post"))
for pre_s in ("node", "edge"):
    for post_s in ("node", "edge"):
        keep = selector.compute_mask(
            bits, pre_s, mode="pre"
        ) & selector.compute_mask(bits, post_s, mode="post")
        report(f"pre={pre_s} + post={post_s}", keep)

labels = [r[0] for r in rows]
evs = [r[1] for r in rows]
fracs = [r[2] for r in rows]
x = range(len(labels))

fig, ax1 = plt.subplots(figsize=(11, 5))

# Bars: expectation value per selection strategy.
bar_colors = ["firebrick"] + ["steelblue"] * (len(evs) - 1)
ax1.bar(x, evs, color=bar_colors, alpha=0.85)
ax1.axhline(1.0, color="green", ls=":", lw=1.5, label="exact <m>")
ax1.axhline(rows[0][1], color="firebrick", ls="--", lw=1, label="raw <m>")
ax1.set_ylabel("<m>  (avg single-site magnetization)", color="steelblue")
ax1.tick_params(axis="y", labelcolor="steelblue")
ax1.set_xticks(list(x))
ax1.set_xticklabels(labels, rotation=45, ha="right")
ax1.legend(loc="upper right")

# Line: fraction of shots retained (right axis).
ax2 = ax1.twinx()
ax2.plot(x, fracs, "o-", color="darkorange")
ax2.set_ylabel("kept fraction", color="darkorange")
ax2.tick_params(axis="y", labelcolor="darkorange")
ax2.set_ylim(0, 1.05)

ax1.set_title("Selection strategy: expectation value vs shots retained")
fig.tight_layout()
plt.show()
raw circuit             : <m> = +0.5791   (kept 100000/100000)
no selection            : <m> = +0.5211   (kept 100000/100000)
pre-only (node)         : <m> = +0.6026   (kept   1357/100000)
pre-only (edge)         : <m> = +0.5637   (kept  13029/100000)
post-only (node)        : <m> = +0.5682   (kept   2254/100000)
post-only (edge)        : <m> = +0.5265   (kept  27514/100000)
pre=node + post=node    : <m> = +0.6393   (kept     28/100000)
pre=node + post=edge    : <m> = +0.5799   (kept    442/100000)
pre=edge + post=node    : <m> = +0.6006   (kept    317/100000)
pre=edge + post=edge    : <m> = +0.5521   (kept   3836/100000)