Simuler la dynamique de Fermi-Hubbard 1D avec des flow sets
Les fonctions décrites dans ce guide ne sont actuellement disponibles que dans l'API Python. Une fonctionnalité équivalente sera disponible dans l'API C dans une prochaine version.
Ce guide construit un circuit pour la dynamique temporelle du modèle de Fermi-Hubbard unidimensionnel, de l'écriture de l'hamiltonien jusqu'à la vérification des densités de sites évoluées. Ce qui rend cette approche intéressante est une seule idée, tirée du cadre des flow sets de Gandon et al. [1], le travail qui a aussi motivé le TransferVertexOperator de ce package :
Au lieu de regrouper les termes de l'hamiltonien après la correspondance fermion-vers-qubit, regroupe-les avant elle, en flow sets, des sous-ensembles unidimensionnels du graphe d'interaction fermionique orienté dont les opérateurs de transfert commutent mutuellement.
Ce choix commande tout ce qui suit. Il appelle les éléments suivants :
-
Un encodage fermion-vers-qubit personnalisé adapté aux flow sets, qui dépense ici un qubit ancilla afin que le nombre de qubits associé à l'implémentation d'un terme d'hamiltonien donné ne croisse plus avec le nombre de modes fermioniques (comme c'est le cas pour Jordan-Wigner (JW)).
-
Une synthèse personnalisée qui exploite la commutativité au sein de chaque ensemble. Le gain est un circuit dont la profondeur à deux qubits est constante en fonction de la taille du système, contre la croissance linéaire d'une trotterisation terme par terme basée sur JW.
Le mécanisme qui permet d'intégrer ton propre encodage dans le transpileur (CustomF2QLayout et MapperFnEvolutionSynthesis) se transpose à n'importe quel modèle.
Le guide de transpilation pour les étapes du transpileur citées tout au long du document, et le guide des mappers pour la recette générale d'écriture d'un mapper personnalisé.
Opérateurs de transfert et flow sets
Un TransferVertexOperator est construit à partir d'opérateurs de sommet et d'opérateurs de transfert . En termes d'opérateurs fermioniques de création et d'annihilation,
donc mesure l'occupation du mode (il vaut lorsqu'il est vide et lorsqu'il est rempli), tandis que transfère un fermion le long de l'arête orientée . Note que les deux indices de ne sont pas interchangeables. Le premier porte la combinaison moins et le second la combinaison plus, ce qui distingue de et donne son orientation à l'arête.
Ceux-ci satisfont des relations de commutation mixtes. Deux opérateurs de transfert agissant sur des sites disjoints commutent trivialement, puisque chacun est un produit pair d'opérateurs fermioniques. Le cas intéressant est celui d'un site partagé. Là, les deux commutent si les flèches circulent à travers ce site (l'une arrive, l'autre part) et anticommutent si elles se heurtent (les deux arrivent, ou les deux partent).
La règle se voit plus facilement sur une image. Dessiner les sommets comme des nœuds et chaque comme une flèche de vers donne le graphe d'interaction orienté, ici pour la chaîne de quatre sites utilisée dans tout ce guide, qui porte les deux orientations de chaque liaison :

Suis la règle sur la figure. Regarde et , par exemple. Une flèche arrive au site 2 et l'autre en part, donc le fermion circule directement et les deux opérateurs commutent. Regarde plutôt et . Les deux flèches pointent vers le site 2. Elles se heurtent, et ces deux opérateurs anticommutent.
C'est ce qui rend les flow sets possibles. Choisis un ensemble de flèches formant un chemin orienté : chaque paire se rencontre soit bout à bout, soit pas du tout, donc l'ensemble entier commute, même si les opérateurs individuels se recouvrent sur des sites partagés. Évoluer sous un seul flow set n'entraîne donc aucune erreur de Trotter, et comme le montre l'étape 7, cela peut aussi se faire avec une profondeur de circuit constante.
1. L'hamiltonien de Fermi-Hubbard
Le modèle de Fermi-Hubbard 1D sur sites (sans spin, conditions aux limites ouvertes) est
Suivant l'éq. (9) de la réf. [1], le terme de saut est . L'interaction est diagonale, elle s'exprime donc à l'aide d'opérateurs de sommet via :
Les deux parties sont construites directement comme un TransferVertexOperator. Note que est stocké comme l'entrée diagonale (j, j) :
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
Les sites intérieurs récupèrent un coefficient de sur parce qu'ils apparaissent dans deux liaisons, alors que les sites de bord n'apparaissent que dans une. Chaque terme listé ici apparaît dans le graphe dessiné plus haut. Les termes T(j,k) en sont les flèches, et les termes V(j) les nœuds.
2. Partitionner en flow sets
Ensuite, étiquette chaque terme avec le flow set auquel il appartient. L'attribut groups existe dans ce but. Une porte Evolution sur un opérateur groupé se décompose en une porte Evolution par groupe (l'étape 6 met cela en pratique), de sorte que le regroupement décidé ici au niveau fermionique subsiste dans le circuit.
Pour la chaîne 1D, les deux flow sets de saut sont les flèches orientées vers l'est () et celles orientées vers l'ouest (). Les termes d'interaction diagonaux commutent avec tout ce qui est diagonal et forment un troisième groupe :
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
Les groupes 0 et 1 sont les deux flow sets. Chaque ensemble est un chemin orienté le long de la chaîne, donc, par la propriété de flux, tous les termes d'un même groupe commutent.
Chaque groupe doit aussi être hermitien par lui-même, puisqu'une formule de produit exponentie les groupes séparément et que seul un facteur hermitien a une évolution unitaire. groups_are_hermitian() le confirme :
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Cela mérite qu'on s'y arrête, car les deux groupes de saut sont unidirectionnels : le groupe 0 ne contient que des termes orientés vers l'est et le groupe 1 que des termes orientés vers l'ouest. Scinder un hamiltonien de cette façon briserait normalement l'hermiticité, puisque a besoin de son partenaire conjugué à ses côtés. Un TransferVertexOperator évite le problème car est déjà hermitien par lui-même. C'est un produit de deux opérateurs de Majorana (voir sa définition à l'étape 1), et non un simple , donc son image de Jordan-Wigner porte un coefficient réel plutôt qu'imaginaire. Choisir cette représentation d'opérateur est donc ce qui fait d'un flow set unidirectionnel un facteur de Trotter légitime.
Les étiquettes est/ouest utilisées dans tout ce guide sont géométriques, avec la chaîne dessinée de gauche à droite et les indices de modes croissant dans ce sens ; pointe vers l'est et vers l'ouest. La réf. [1] est incohérente en interne sur cette dénomination (son texte et ses figures divergent), donc ce guide ne suit délibérément pas le texte et conserve plutôt les étiquettes de la figure. Lorsque tu croises la lecture avec l'article, fais correspondre les flow sets par leurs poids de Pauli (1 et 3 ci-dessous), et non par les points cardinaux.
3. Écrire l'encodage personnalisé
La section IV B de la réf. [1] classe les formes que peut prendre un encodage fermion-vers-qubit local lorsqu'il est restreint à un flow set. Jordan-Wigner simple utilise qubits et envoie chaque terme de saut sur un Pauli de poids 2. La classification montre que dépenser des qubits supplémentaires achète de la structure dans les opérateurs encodés.
L'encodage implémenté ici est la construction à parité délocalisée de l'annexe B 2 (équations B4 et B5), qui utilise un qubit ancilla, donc . La parité fermionique est délocalisée sur une paire de qubits :
L'indice dans la dernière expression impose le qubit supplémentaire. La dernière liaison de la chaîne a , donc son tombe sur le qubit , un cran après le dernier mode fermionique . Ce qubit final est l'ancilla, et c'est pourquoi plutôt que . La même portée apparaît dans , dont le est sur l'ancilla pour .
Le gain est visible immédiatement ; un flow set entier est envoyé sur une somme de Paulis de poids 1.
Les préfacteurs sont fixés par la normalisation , et le signe moins relatif entre les deux orientations est fixé par l'identité de produit , que les Paulis ci-dessus satisfont. Se tromper sur l'un ou l'autre donne un opérateur qui obéit aux relations de commutation mais ne représente plus le même hamiltonien ; tu dois donc vérifier l'encodage numériquement, comme montré à l'étape 4.
Écrire l'encodage revient à écrire une fonction qui envoie un seul opérateur de transfert généralisé vers une chaîne de Pauli ; map_transfer_vertex_generators() se charge de l'itération sur les termes et de leur composition :
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn attend la signature (operator, num_qubits), et le type de retour doit être un SparseObservable, ce qui rend la fonction directement utilisable comme plugin du transpileur. Voir l'étape 6.
L'appliquer à l'hamiltonien de l'étape 1 donne l'opérateur encodé sur qubits :
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
Il y a 14 termes, de trois formes : le saut est devenu X et ZXZ, l'interaction ZZ, et le [] initial est l'identité, qui ne contribue qu'à une phase globale. Note que les termes ZZ atteignent les voisins les plus proches et les seconds voisins ; couvre les qubits à , ce qui est le coût de la délocalisation de la parité.
Regrouper par flow set révèle l'asymétrie que procure la construction. Liste les poids de Pauli présents dans chaque groupe :
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
Le flow set orienté vers l'est (groupe 0) est constitué entièrement de Paulis de poids 1. Son évolution temporelle est donc une couche de rotations à un qubit et n'a besoin d'aucune porte intriquante, alors que sous Jordan-Wigner chaque terme de saut est de poids 2 et en requiert. C'est le compromis espace-temps de la réf. [1] dans sa forme la plus simple : un qubit supplémentaire convertit la moitié de l'hamiltonien de saut en rotations à un qubit.
Le flow set orienté vers l'ouest (groupe 1) le paie au poids trois, et l'interaction (groupe 2) se situe au poids deux, où l'entrée de poids zéro est l'identité. Rien de tout cela n'est encore une affirmation sur un circuit ; ce qu'une synthèse fait de ces poids est l'objet des étapes 6 et 7.
4. Vérifier l'encodage
Un encodage personnalisé n'est utile que s'il est fidèle, et un encodage écrit à la main doit être vérifié. Comme cet encodage utilise qubits, l'espace de Hilbert des qubits est deux fois plus grand que l'espace fermionique ; l'hamiltonien encodé ne peut donc pas être égal à celui de Jordan-Wigner terme par terme. Les deux sont reliés par une isométrie.
D'où vient l'isométrie : sous Jordan-Wigner, un état de base est la chaîne d'occupation ; le qubit contient . Cet encodage stocke au contraire des parités cumulées. Définis
de sorte que le bit enregistre la parité de toutes les occupations jusqu'au site inclus. Il y a tels bits pour occupations, d'où vient l'ancilla. L'occupation se retrouve comme la différence entre bits voisins, . Un site occupé apparaît donc comme un mur de domaine entre deux bits adjacents, d'où le nom d'encodage à mur de domaine (ou de Kramers-Wannier). C'est aussi pourquoi : le produit de deux voisins lit cette différence.
Écrire cette application pour quelques états rend la structure concrète (note que est fixé, donc seule la moitié des états de qubits se trouve dans l'image, d'où une isométrie plutôt qu'une unitaire) :
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
Un seul fermion sur le site 0 inverse toutes les parités cumulées situées au-dessus, ce qui est la délocalisation à l'œuvre. En rassemblant ces colonnes dans une matrice, on obtient l'isométrie , et l'encodage est fidèle lorsqu'il entrelace les deux hamiltoniens :
Autrement dit, appliquer un état fermionique dans l'espace des qubits puis l'y faire évoluer doit donner le même résultat que de le faire évoluer d'abord dans l'espace fermionique puis de l'appliquer ensuite.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
La relation d'entrelacement est exacte, et vaut séparément pour chaque ensemble de flux. Ce second énoncé, plus fort, est celui sur lequel s'appuient les étapes suivantes : une formule de produit fait évoluer les groupes un par un, et un produit de facteurs entrelacés est lui-même entrelacé, de sorte que toute approximation construite à partir de ces groupes concorde entre les deux encodages bien que les encodages diffèrent. En corollaire, les spectres doivent concorder, chaque valeur propre de Jordan-Wigner apparaissant deux fois dans l'espace plus grand, une fois pour chaque valeur de la parité globale non contrainte :
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. Construire le circuit fermionique
Avant de faire intervenir le moindre qubit, la dynamique est exprimée au niveau fermionique. Un FermionicCircuit agit sur des modes fermioniques plutôt que sur des qubits, et une porte Evolution sur l'hamiltonien constitue tout le circuit :
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

Il y a une boîte opaque sur les quatre modes, et ce qui est intéressant, c'est ce en quoi elle se décompose. L'argument synthesis indique comment : FermionicLieTrotter est la formule de produit du premier ordre, qui scinde l'opérateur selon ses groups et fait évoluer chaque groupe à tour de rôle. Ainsi, le partitionnement en ensembles de flux de l'étape 2 est la trotterisation, et un seul decompose() l'effectue, ce qui donne une porte Evolution par ensemble de flux dans l'ordre des groupes : est, ouest, puis l'interaction diagonale, comportant respectivement 3, 3 et 8 termes.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
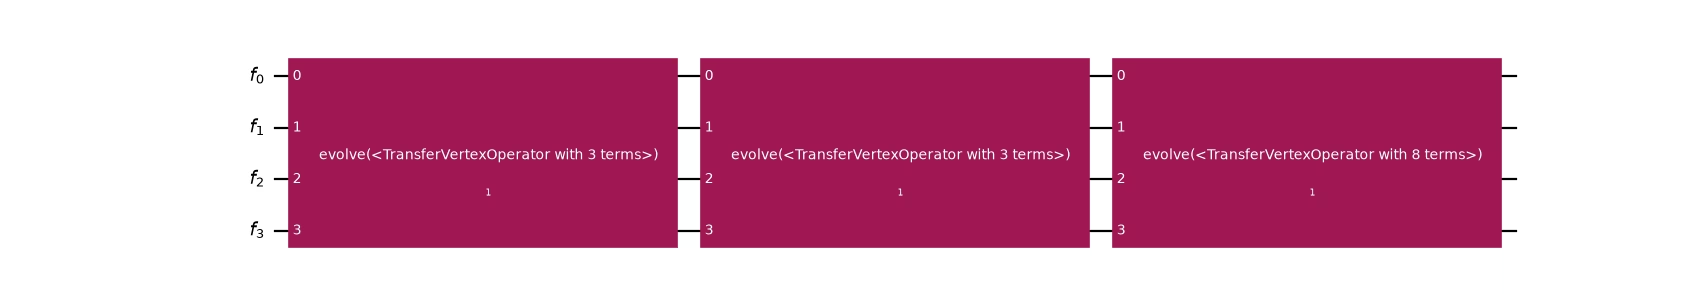
Note que tout cela se passe entièrement dans l'espace fermionique : aucun qubit n'a encore été mentionné, et l'approximation est déjà faite. Le nombre de pas de Trotter relève donc lui aussi d'ici, sous la forme de reps, qui divise le temps et répète tout le balayage :
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
Neuf portes : les trois ensembles de flux, parcourus trois fois cycliquement, chacun pour un tiers du temps. C'est ce cycle qui en fait une trotterisation plutôt qu'un redécoupage d'un seul groupe. Répéter un seul groupe n'apporterait rien, puisque des exponentielles consécutives du même opérateur commutent, donc A(t/3) A(t/3) A(t/3) vaut simplement A(t). Une formule qui lit les groupes peut les entrelacer ; une formule appliquée après l'application ne le peut pas, car le regroupement a alors disparu.
C'est l'étape qui donne son importance au regroupement. Chaque porte émise est appliquée et synthétisée indépendamment, de sorte que tout ce qui suit agit sur le partitionnement décidé au niveau fermionique. Sauter la décomposition transmet à la place tout l'opérateur à l'étape suivante, et le regroupement est ignoré.
6. Transpiler avec l'encodage personnalisé
L'encodage est maintenant prêt à être utilisé par le transpileur. Deux éléments supplémentaires sont nécessaires :
-
Un layout. Le
TrivialF2QLayoutpar défaut suppose un qubit par mode, ce qui est faux dans cette situation.CustomF2QLayoutassocie le registre fermionique à unQuantumRegisterde taille différente, ce qui permet aux qubits ancillaires d'entrer dans le pipeline. -
Un plugin de synthèse.
MapperFnEvolutionSynthesisprend directement la fonction de mapping, l'applique à l'hamiltonien de la porteEvolutionet émet unePauliEvolutionGate, en préservant la convention . Sonproduct_formuladétermine comment cette porte est transformée en rotations. Note qu'il s'agit d'une seconde formule de produit, indépendante, agissant sur les qubits après l'application : leLieTrotterde Qiskit lui est transmis ici, et l'étape 7 le remplace par une formule qui connaît les ensembles de flux.
Comme chaque comparaison ci-dessous relance ce pipeline, il vaut la peine de l'encapsuler une fois pour toutes :
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
Quatre modes fermioniques sont devenus un circuit à cinq qubits, l'ancilla étant fournie par le layout personnalisé.
Regardons maintenant ce que contient réellement le circuit obtenu. Une décomposition répétée réduit les portes d'évolution jusqu'à U et CX, de sorte que le coût en portes à deux qubits des deux stratégies de synthèse comparées ci-dessous soit mesuré dans la même monnaie : count_ops() indique alors le nombre de CX, et depth() accepte une fonction de filtre pour mesurer la profondeur à deux qubits. Note que ce reps est une profondeur de décomposition, sans rapport avec le nombre de pas de Trotter d'une formule de produit, qui porte aussi le nom reps plus loin dans ce guide :
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
Vingt-six portes CX en vingt-trois couches : presque rien ne s'exécute en parallèle. Dessiner le circuit montre pourquoi :
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
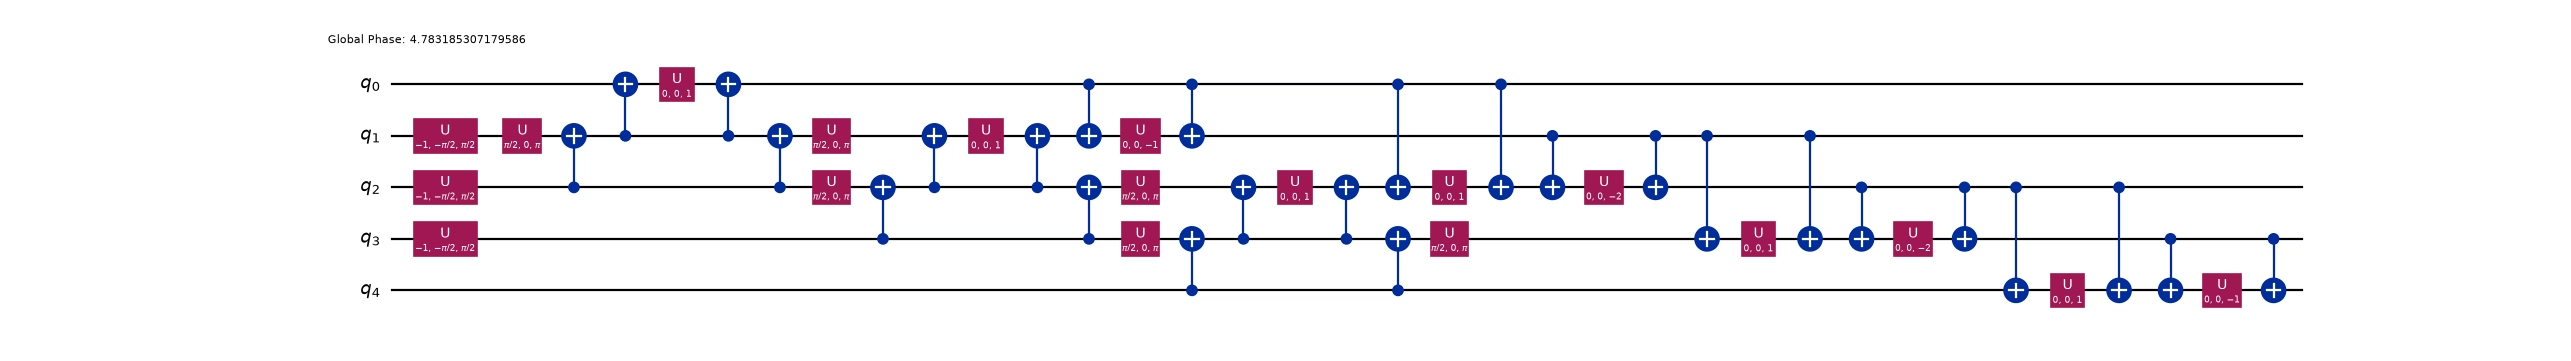
Chaque terme a été compilé isolément : un changement de base, une échelle de CX descendant jusqu'à une seule rotation, puis l'échelle est défaite. L'ensemble de flux de poids 1 est gratuit ; ses termes sont des rotations isolées sans échelle autour, mais chaque terme de poids 3 coûte quatre portes CX, et comme les échelles sont émises séquentiellement, rien ne se chevauche.
Le regroupement survit donc à tout le pipeline (trois ensembles de flux, trois PauliEvolutionGate appliquées) et ne rapporte pourtant presque rien. La trotterisation fermionique de l'étape 5 a fait son travail ; ce qui la gaspille, c'est la formule côté qubits. LieTrotter reçoit un ensemble de termes dont on ne lui dit rien, et compile chacun isolément. Elle ne peut pas savoir qu'ils commutent mutuellement, donc elle sérialise ce qui pourrait partager un changement de base.
C'est l'écart que cet encodage existe pour combler : deux formules de produit sont à l'œuvre, et seule la fermionique a reçu la structure jusqu'ici. L'étape suivante fournit une synthèse côté qubits qui l'exploite elle aussi.
7. Une synthèse consciente des ensembles de flux
Retrouver l'avantage suppose d'informer la synthèse côté qubits de la structure. C'est la section IV C de la réf. [1] : comme tous les termes d'un ensemble de flux commutent, ils peuvent être diagonalisés simultanément par un seul circuit de Clifford, pivotés dans une base partagée puis repivotés, au lieu de le faire une fois par terme.
Pour cet encodage, le Clifford est simple. Conjuguer par une chaîne de portes CZ entre plus proches voisins envoie
simultanément pour tout . Une chaîne de CZ transforme tout l'ensemble de flux de poids 3 (ouest) en une couche de rotations à un qubit indépendantes. L'interface EvolutionSynthesis ne demande qu'une méthode synthesize(), qui est tout ce que cette classe implémente. Elle ne porte aucun nombre de pas de Trotter, car elle reçoit un ensemble de flux à la fois et ne peut donc pas subdiviser l'évolution entre les ensembles. Cette subdivision relève d'un niveau supérieur, dans l'espace fermionique, où un F2FSynthesisPlugin les voit tous à la fois (voir l'étape 9) :
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
Deux détails passent facilement inaperçus. Une EvolutionSynthesis personnalisée doit exposer un attribut preserve_order, que lit la passe de synthèse de haut niveau.
Les deux utilitaires émettent leurs portes en couches explicites plutôt que dans l'ordre des termes, car depth() planifie les portes dès que possible, dans l'ordre où elles ont été ajoutées. Comme toutes les portes d'un même ensemble commutent, l'ordre peut être choisi librement. Une synthèse terme par terme choisit mal l'ordre. Émettre séquentiellement la chaîne de CZ qui se chevauche donne une profondeur qui croît avec le nombre de qubits plutôt que la constante 2 que le matériel pourrait atteindre.
C'est pourquoi la synthèse ci-dessus ne porte aucun nombre de pas de Trotter. Elle reçoit un ensemble de flux par porte, donc une répétition en son sein répéterait à l'intérieur d'un ensemble plutôt que de cycler entre eux :
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
La première forme n'apporte rien : des exponentielles consécutives du même opérateur commutent, donc A(t/2) A(t/2) vaut simplement A(t) et l'erreur reste à sa valeur d'un seul pas, quel que soit le nombre de pas demandé.
Le nombre de pas appartient donc au FermionicLieTrotter fermionique de l'étape 5, qui lit les groups et peut les entrelacer. Cette répartition des tâches est le point essentiel : la formule fermionique décide combien de pas et dans quel ordre, et cette classe décide à quel coût chaque ensemble obtenu est réalisé.
Pour choisir l'ordre, passe-le à MapperFnEvolutionSynthesis.product_formula, qui est l'argument que prend flow_set_pass_manager. Rien d'autre dans le pipeline (ni dans le circuit fermionique sur lequel il s'exécute) ne change :
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
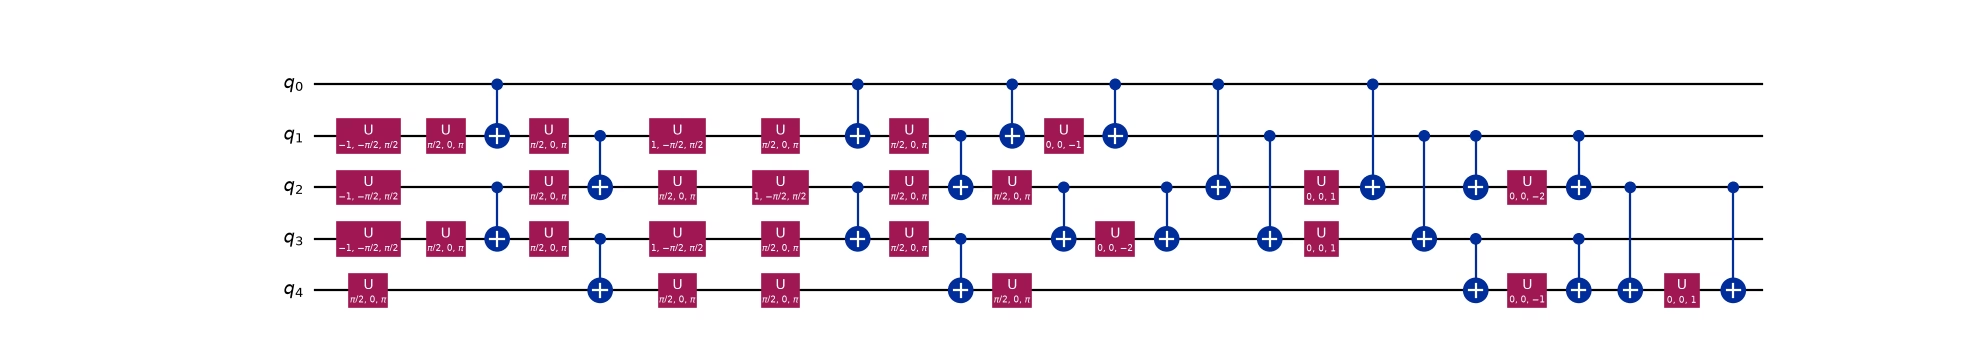
D'une profondeur de 23 avec 26 portes CX à une profondeur de 12 avec 22 portes CX. Note qu'il y a moins de portes intriquantes et presque moitié moins de profondeur. En comparant les deux figures, la différence n'est pas que les portes coûtent moins cher mais qu'elles s'empilent. Les échelles sérielles ont disparu ; les portes intriquantes se superposent désormais dans des couches partagées, parce que tout l'ensemble de flux ouest est pivoté dans une seule base partagée et que l'interaction est émise en couches de paires disjointes.
FlowSetSynthesis fait une recherche de motifs sur les indices absolus de qubits, ce qui n'est sûr ici que parce que chaque ensemble de flux de cet hamiltonien couvre tout le registre. Une formule de produit fermionique réduit chaque facteur aux modes qu'il touche réellement ; un regroupement dont les ensembles ne couvriraient qu'une partie de la chaîne arriverait donc renuméroté et les motifs ci-dessus ne correspondraient pas.
Les deux dessins montrent le circuit après decompose(reps=6), qui réécrit tout dans la base U et CX, de sorte que les portes CZ, Rx et Rzz émises par FlowSetSynthesis ne sont pas visibles en tant que telles. C'est voulu : cela place les deux circuits dans la même base, seule manière de rendre comparables les nombres et profondeurs à deux qubits ci-dessus. Ce qui est notable dans ces figures, c'est la structure en couches, pas les étiquettes des portes.
8. Profondeur constante à grande échelle
La question intéressante n'est pas le nombre à quatre modes mais la façon dont il évolue. Les deux couches en briques de CZ ne croissent pas avec la longueur de la chaîne, donc la profondeur à deux qubits d'un pas de Trotter devrait être constante. Mesurons-la directement sur l'hamiltonien complet de Fermi-Hubbard, bien au-delà de ce qu'on pourrait simuler par force brute :
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
La profondeur à deux qubits reste à 12 de quatre modes jusqu'à 100, alors que LieTrotter croît linéairement jusqu'à 407. Les ensembles de flux lui permettent de paralléliser un peu au sein du pipeline, mais chaque ensemble est encore trotterisé terme par terme, donc la croissance est seulement ralentie, pas supprimée :
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

Le nombre de portes croît linéairement dans les deux cas (il y a termes à appliquer, et c'est inévitable), mais la synthèse par ensembles de flux les applique en un nombre constant de couches parallèles. C'est le résultat de profondeur constante de la réf. [1].
La profondeur 12 se répartit sur les trois ensembles de flux en 0 + 4 + 8, quelle que soit la longueur de la chaîne. L'ensemble de flux est contribue pour zéro ; ce ne sont que des rotations Rx. L'ensemble de flux ouest coûte 4, avec les deux couches en briques de CZ à l'entrée et les deux à la sortie ; en supprimant l'interaction, il reste une profondeur à deux qubits de quatre quelle que soit la longueur de la chaîne. Les huit restants viennent de l'interaction, dont les termes Rzz agissent sur les plus proches voisins comme sur les seconds voisins et nécessitent donc quatre couches disjointes, chacune coûtant deux portes CX. Quatre est optimal ici : chaque qubit intérieur porte quatre portes Rzz (deux vers chaque voisin et deux vers chaque second voisin) et ne peut participer qu'à une à la fois, donc aucun ordonnancement ne peut faire mieux.
Les deux tiers de la profondeur viennent de l'interaction, ce qui montre que cet encodage excelle pour le saut, et donc pour la dynamique d'une chaîne de fermions libres. Note toutefois que l'interaction ne commute pas avec le saut. L'omettre n'est pas une approximation de Fermi-Hubbard mais un modèle différent. Où se situe l'équilibre pour un problème donné mérite d'être exploré.
9. Vérifier la dynamique
Avec l'application en mur de domaine, un motif d'occupation devient une chaîne de parités cumulées ; l'état initial est donc préparé différemment qu'avec Jordan-Wigner. C'est une conséquence pratique facilement négligée de la délocalisation de la parité. L'utilitaire de l'étape 4 donne la bonne étiquette :
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
L'état étant préparé, deux questions demeurent, et il vaut mieux les poser séparément : la synthèse par ensembles de flux calcule-t-elle la bonne chose, et la calcule-t-elle à moindre coût ?
Commençons par l'exactitude. FlowSetSynthesis et le LieTrotter de Qiskit reçoivent les mêmes ensembles de flux encodés issus de la même trotterisation fermionique, ils doivent donc réaliser la même unitaire à une phase globale près. Les Cliffords personnalisés réorganisent le travail ; ils ne changent pas le résultat. Des vecteurs d'état aléatoires détectent toute divergence bien moins cher que la construction de l'unitaire complète :
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
Les deux moitiés de cette vérification comptent. Un recouvrement de module unité sur un seul état est nécessaire mais pas suffisant : une synthèse qui se tromperait sur une phase dépendant de l'état le laisserait quand même paraître. Exiger la même phase sur plusieurs états aléatoires comble cette lacune. Vérifier plus d'un reps compte aussi, car cela confirme que l'accord survit à l'entrelacement des ensembles de flux au lieu de ne tenir que pour un seul balayage.
Le choix de la synthèse côté qubits est donc sans conséquence pour la précision, ce qui rend une comparaison de coûts pertinente. La question restante est ce que l'encodage dans son ensemble apporte face à l'alternative évidente : Jordan-Wigner simple sur num_sites qubits, sans ancilla ni Cliffords personnalisés. L'encodage et la synthèse côté qubits diffèrent tous deux entre les deux colonnes, mais la vérification ci-dessus a montré que cette dernière ne peut pas affecter le résultat, donc ce que les fidélités testent, c'est l'encodage. Les deux pipelines partent aussi de la même trotterisation fermionique, donc toute différence de fidélité indiquerait un bogue plutôt qu'un compromis. Les deux colonnes sont les encodages, ensembles de flux contre Jordan-Wigner :
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
Lis d'abord la colonne des fidélités : identiques, à chaque chiffre affiché, dans deux espaces de Hilbert différents sous deux encodages différents. C'est la trotterisation fermionique qui transparaît. L'approximation a été fixée à l'étape 5, avant le choix de l'un ou l'autre encodage, donc les deux circuits portent exactement l'erreur d'une formule du premier ordre sur trois ensembles de flux, et elle est divisée par environ quatre à chaque doublement du nombre de pas.
Ce en quoi les encodages diffèrent, c'est le coût, et le compromis mérite d'être énoncé clairement. L'ensemble de flux dépense plus de portes intriquantes : 22 contre 18 pour un pas. L'ancilla n'en est pas la raison, puisqu'elle ne porte aucune porte à deux qubits propre. La raison est l'interaction, exactement comme l'étape 3 l'avait annoncé : délocaliser la parité transforme trois termes ZZ entre plus proches voisins en sept couvrant les plus proches et les seconds voisins, et chacun coûte deux portes CX. C'est le prix à payer pour rendre le saut peu coûteux.
Il ne l'emporte aussi que de justesse en profondeur à cette taille (12 contre 14), car quatre modes est trop peu pour que l'asymptotique se manifeste. Ce qui compte, c'est le passage à l'échelle mesuré à l'étape 8 : cette profondeur de 12 est constante, alors que celle de Jordan-Wigner croît avec la chaîne. À 14 modes, c'est déjà 12 contre 34.
Les appels à decompose() ci-dessus sont essentiels, pour deux raisons indépendantes.
evolve() et Operator utilisent la définition exacte d'une PauliEvolutionGate, contournant toute synthèse personnalisée côté qubits. Vérifier un circuit non décomposé indique une fidélité parfaite même pour une synthèse délibérément fausse.
La même chose s'applique un niveau plus haut, à la synthèse fermionique. Une porte Evolution qui n'est jamais décomposée passe entière à l'étape fermion-vers-qubit, qui l'applique sans consulter Evolution.synthesis, de sorte que reps n'aurait silencieusement aucun effet. trotter_steps de l'étape 5 effectue cette décomposition ; un pipeline qui définit la méthode avec F2FSynthesis obtient le même développement de la part de la passe.
Pour une dernière vérification croisée, les densités de site calculées dans l'espace encodé doivent reproduire le résultat de Jordan-Wigner. Cette vérification porte sur l'encodage, pas sur le circuit, donc aucune approximation de Trotter n'y intervient. Les deux évolutions temporelles sont calculées exactement, par exponentiation matricielle des hamiltoniens respectifs. Toute divergence pointerait donc vers l'encodage plutôt que vers une formule de produit :
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
Les densités concordent à dix décimales.
Ce qu'il faut retenir
-
Regrouper avant d'appliquer. Les ensembles de flux sont définis sur le graphe d'interaction fermionique orienté, donc le regroupement est choisi tant que la structure du problème est encore disponible. L'attribut
groupsle porte jusque dans le circuit, où un seuldecompose()le transforme en une porteEvolutionpar ensemble de flux. -
Les ancillas achètent de la structure. Dépenser un qubit supplémentaire transforme tout un ensemble de flux en Paulis de poids 1, dont l'évolution ne nécessite aucune porte intriquante. La réf. [1] observe ce compromis de façon générale. Des rapports qubits-fermions plus grands permettent des circuits d'évolution moins profonds.
-
Un encodage personnalisé tient en une fonction. Appliquer un seul opérateur de transfert généralisé à une chaîne de Pauli ;
map_transfer_vertex_generators()etMapperFnEvolutionSynthesisfont le reste. -
L'application et le regroupement seuls ne suffisent pas. Scinder l'évolution par ensemble de flux n'a fait que ralentir la croissance linéaire de la profondeur ; une synthèse terme par terme de chaque ensemble gaspillait encore le fait que ses termes commutent. Seule la fourniture d'une
EvolutionSynthesisconsciente des ensembles de flux a rendu la profondeur constante. Encodages personnalisés, regroupement et synthèse personnalisée sont complémentaires : les trois sont nécessaires. -
Deux formules de produit, deux rôles.
FermionicLieTrotterfixe l'approximation dans l'espace fermionique, où le regroupement est encore visible, donc lui seul détermine l'erreur de Trotter et le nombre de pas. L'EvolutionSynthesiscôté qubits décide alors seulement à quel coût chaque ensemble est réalisé : l'étape 9 confirme que les deux choix donnent la même unitaire. Séparer les deux permet de régler indépendamment la précision et le coût. Voir Synthétiser une porte Evolution dans l'espace fermionique. -
Vérifie-le. Un encodage qui satisfait les relations de commutation peut malgré tout représenter un autre hamiltonien si un préfacteur ou un signe est erroné. Vérifier une relation d'entrelacement (ou, à moindre coût, le spectre) permet de le détecter.
Le FlowSetSynthesis ci-dessus est délibérément écrit pour cet encodage sur une chaîne 1D. Il fait une recherche de motifs sur les étiquettes de Pauli précises que produit l'encodage et lève une erreur pour tout le reste, plutôt que de se rabattre silencieusement sur une formule de produit générique. Une implémentation générale comporte deux moitiés. Lire la structure des ensembles de flux à partir des groups de l'opérateur, c'est ce que fait déjà un F2FSynthesisPlugin pour une évolution. Dériver le Clifford diagonalisant à partir du groupe stabilisateur, comme décrit dans la section IV C de la réf. [1], est la moitié qui reste spécifique à l'encodage.
Par ailleurs, délocaliser la parité rend le terme d'interaction de poids 2 plutôt que diagonal en qubits individuels, ce qui est le coût symétrique des termes de saut moins chers.
Ensuite : deux dimensions
Tout ce qui précède est unidimensionnel, et délibérément. Sur une chaîne, les ensembles de flux ne sont que les deux orientations des flèches, et l'encodage n'a besoin que d'une seule ancilla. Aucune de ces simplifications ne survit en deux dimensions, là où des encodages locaux sont nécessaires.
Sur un réseau planaire, un ensemble de flux est un chemin orienté (ou une union de chemins orientés disjoints en sommets) à travers le graphe d'interaction, et trouver un petit ensemble de tels chemins qui couvre chaque arête devient un problème combinatoire à part entière, plutôt qu'une classification en deux lignes. Les encodages changent aussi de nature ; au lieu d'une seule ancilla pour toute la chaîne, ils en ajoutent une par site ou par cellule du réseau. Verstraete-Cirac associe à chaque site fermionique son propre qubit auxiliaire, soit un rapport qubits-modes de , tandis que Derby-Klassen en place un au centre de chaque plaquette impaire, pour un rapport de . La disposition du registre a alors une véritable structure bidimensionnelle, et le groupe stabilisateur sur lequel il faut projeter n'est plus trivial. L'hamiltonien encodé n'est fidèle que sur un sous-espace, ce qui change à la fois la préparation de l'état et la méthode de vérification de l'étape 4.
Les éléments que construit ce guide sont ceux qui se transposent : CustomF2QLayout pour un registre dont la taille diffère du nombre de modes, map_transfer_vertex_generators() pour l'encodage lui-même, MapperFnEvolutionSynthesis pour le brancher dans le transpileur, et une EvolutionSynthesis personnalisée pour que la structure des ensembles de flux porte ses fruits. Seuls l'encodage et la décomposition en ensembles de flux sont différents.
Le guide des ensembles de flux 2D prend le relais ici, en traitant l'encodage de Verstraete-Cirac sur un réseau carré : quatre ensembles de flux, un Clifford de profondeur 2 pour chacun, et la projection sur le stabilisateur dont la vérification a ensuite besoin.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.