Simuler la dynamique de Fermi-Hubbard 2D avec des ensembles de flux
Les concepts de ce guide ne sont actuellement disponibles que dans l'API Python. Une fonctionnalité équivalente sera disponible dans l'API C dans une prochaine version.
Lis d'abord le guide des ensembles de flux 1D. Ce guide en est la suite bidimensionnelle et ne répète pas les informations qui y sont développées : opérateurs de transfert et de sommet, ce qu'est un ensemble de flux, comment les groups survivent dans le circuit, et comment un encodage personnalisé est branché dans le transpileur via MapperFnEvolutionSynthesis.
Consulte le guide de transpilation pour les étapes du transpileur citées tout au long, et le guide des mappers pour la recette générale d'écriture d'un mapper personnalisé.
Le guide 1D se terminait en mentionnant que des encodages locaux sont nécessaires pour travailler en deux dimensions. Ce guide franchit ce pas, pour le modèle de Fermi-Hubbard bidimensionnel sur un réseau carré, en utilisant l'encodage de Verstraete-Cirac (VC) [2].
Il y a trois différences avec le problème 1D, qui forment la base de ce travail :
-
Les ensembles de flux se multiplient. Une chaîne a deux orientations de flèches ; un réseau carré en a quatre (est, ouest, nord, sud), et chacune est une union de chemins orientés disjoints en sommets (un par ligne ou colonne du réseau) plutôt qu'un chemin unique.
-
L'encodage gagne une ancilla par site, et non une pour tout le système, ce qui donne un
rapport qubits-modes de . Les opérateurs de transfert deviennent des Paulis de poids 3 (horizontaux) et de poids 4 (verticaux), et chacun des quatre ensembles de flux correspond à sa propre forme de Pauli, donc chacun nécessite son propre Clifford diagonalisant.
-
L'Hamiltonien encodé n'est fidèle que sur un sous-espace : le conjoint
joint des contraintes de plaquette que porte tout encodage local 2D [2] [3]. En 1D, l'encodage était une simple isométrie et la vérification était un contrôle du spectre. Ici, la comparaison doit être projetée, comme l'illustre l'étape 9.
Le gain a la même forme qu'en 1D : la profondeur à deux qubits d'un pas de Trotter devient constante en la taille du réseau, à ( pour le saut, en accord avec la réf. [1], plus pour l'interaction), alors qu'une trotterisation terme par terme du même hamiltonien encodé croît linéairement. Le nombre de portes croît toujours avec le nombre de liaisons, bien sûr ; ce qui devient indépendant de la taille, c'est le nombre de couches qu'occupent ces portes. Les profondeurs sont comptées partout sur un registre abstrait entièrement connecté ; appliquer l'encodage à la carte de couplage restreinte d'un appareil est un problème à part, abordé à la fin.
Le réseau et ses quatre orientations
Le premier changement est visible sur le graphe d'interaction orienté. Les sites sont numérotés par lignes, site(r, c) = r * cols + c, et chaque liaison porte les deux orientations, comme la chaîne en 1D, mais les liaisons courent maintenant selon deux axes :
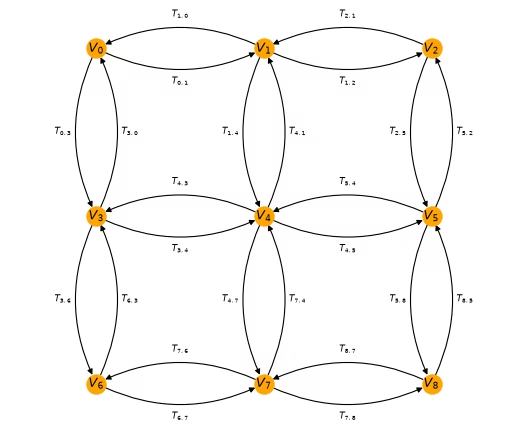
La règle de commutation est celle du 1D, inchangée : deux opérateurs de transfert partageant un site commutent quand les flèches le traversent et anticommutent quand elles s'opposent. Cependant, un site a maintenant jusqu'à quatre liaisons incidentes au lieu de deux, donc les flèches qui le traversent peuvent s'opposer de plus de façons, et un ensemble de flèches qui ne s'opposent jamais n'est plus un chemin unique. Lire les flèches horizontales de gauche à droite donne un tel ensemble, les flèches verticales de haut en bas en donnent un autre, et inverser chacun en donne deux de plus. Ce sont les ensembles de flux est, ouest, nord et sud qui organisent tout ce qui suit.
L'encodage de Verstraete-Cirac
Verstraete-Cirac (VC) associe à chaque mode fermionique son propre qubit auxiliaire. Avec sites de réseau, le mode vit sur le qubit et son ancilla est sur le qubit , donc le registre contient qubits. Les opérateurs de sommet restent aussi simples que possible,
ce qui rend les occupations directement lisibles par la suite. Les opérateurs de transfert dépendent de l'orientation de l'arête. Pour une arête horizontale avec le site ouest, et une arête verticale avec le site nord,
un « triangle » de poids 3 et un « carré » de poids 4. Identifier chaque flèche compte : avec comme site ouest, pointe vers l'est, mais avec comme site nord, elle pointe vers le sud. Les orientations inverses découlent de l'identité , qui transforme le triangle XXZ en YYZ, et le carré XYXY en YXXY. Ces quatre étiquettes distinctes sont les quatre ensembles de flux, et la suite de ce guide les suit.
Ce ne sont pas tout à fait les équations (A1) de la Réf. [1], qui indique « à des rotations à un qubit près » et diffère sur trois points qu'il vaut la peine de nommer, car un lecteur qui vérifie l'article les remarquera :
-
Le préfacteur : l'éq. (A1) n'en comporte aucun. Le ici est ce qui donne , en accord avec la normalisation qu'utilise
TransferVertexOperator. L'article n'a jamais besoin de ses opérateurs de transfert qu'à l'intérieur de , où un facteur d'échelle est absorbé dans l'angle de rotation ; ici, ils doivent être des opérateurs qui satisfont une identité. -
L'orientation : l'éq. (A1) choisit les lettres selon la parité de la ligne de , qui pour une arête horizontale est la même pour les deux extrémités, donc elle ne distingue pas de . L'article retrouve l'orientation séparément, en conjuguant avec une couche de . Ce guide l'intègre plutôt dans l'encodage, en dérivant l'orientation inverse de , ce qui fait que les deux orientations aboutissent à des Paulis différents à l'étape 3.
-
La forme verticale : l'éq. (A1) alterne
XXXXetYYYYselon la parité de la ligne, alors que ce guide utilise un seulXYXY. Ce sont deux manières d'obtenir la même chose : une asymétrie de lettres qui fait qu'une arête verticale entre correctement en conflit avec les arêtes horizontales qui la rejoignent. Ne considère pas cette différence comme un libre choix de base. Supprimer l'alternance de parité et utiliser un seulXXXXcasse purement et simplement l'algèbre, c'est pourquoi les lettres distinctes sont vérifiées plutôt que supposées.
L'ancilla est attachée à un site, ce qui donne le rapport ; c'est l'encodage de Derby-Klassen qui place un qubit auxiliaire par plaquette (impaire), pour le rapport plus petit . VC est utilisé ici parce que ses opérateurs de transfert sont ceux dont les Cliffords de diagonalisation sont donnés sous forme fermée dans la Réf. [1].
1. L'hamiltonien sur un réseau carré
La construction est la même qu'en 1D, mais avec une liste d'arêtes bidimensionnelle. Les sites gardent la numérotation ligne par ligne utilisée pour la figure ci-dessus, site(r, c) = r * cols + c, de sorte que les liaisons horizontales relient des indices consécutifs et que les liaisons verticales relient des indices qui diffèrent de cols :
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_2d(rows, cols, tunneling, interaction):
...     site = lambda r, c: r * cols + c
...     edges = [(site(r, c), site(r, c + 1)) for r in range(rows) for c in range(cols - 1)]
...     edges += [(site(r, c), site(r + 1, c)) for r in range(rows - 1) for c in range(cols)]
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j, k in edges:
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> rows, cols = 3, 3
>>> num_sites = rows * cols
>>> hamiltonian = fermi_hubbard_2d(rows, cols, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 46
2. Quatre ensembles de flux au lieu de deux
Chaque terme de saut est classé selon la direction vers laquelle pointe sa flèche sur le réseau. La comparaison des coordonnées ligne/colonne divmod des deux extrémités sépare les arêtes horizontales des verticales, et le signe de la différence détermine l'orientation. Tout ce qui est diagonal (l'identité, les termes et ) va dans un cinquième groupe :
Convention d'orientation. Les noms sont simplement lus sur la figure ci-dessus : une flèche est est ou ouest selon qu'elle pointe vers la droite ou vers la gauche le long d'une ligne, et nord ou sud selon qu'elle pointe vers le haut ou vers le bas le long d'une colonne. Comme la numérotation se fait ligne par ligne, l'est et le sud sont les directions où l'indice augmente. Rien en aval ne dépend de ces noms (ils servent seulement d'étiquettes aux groupes), mais ils sont faciles à confondre, donc il vaut la peine de les fixer par rapport au schéma. La Réf. [1] nomme ses ensembles de flux sur réseau carré de la même façon.
>>> EAST, WEST, NORTH, SOUTH, DIAGONAL = range(5)
>>>
>>> def flow_set_groups(operator, cols):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         if len(terms) == 1 and terms[0][0] != terms[0][1]:
...             j, k = terms[0]
...             row_j, col_j = divmod(j, cols)
...             row_k, col_k = divmod(k, cols)
...             if row_j == row_k:
...                 groups.append(EAST if col_k > col_j else WEST)
...             else:
...                 groups.append(SOUTH if row_k > row_j else NORTH)
...         else:
...             groups.append(DIAGONAL)
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian, cols)
>>>
>>> names = ["east", "west", "north", "south", "diagonal"]
>>> for index, name in enumerate(names):
...     count = sum(1 for group in hamiltonian.groups if group == index)
...     print(f"{name:9s} {count:2d}")
east       6
west       6
north      6
south      6
diagonal  22
Au sein d'un même ensemble de flux, chaque flèche en rencontre une autre bout à bout ou ne la rencontre pas du tout, comme en 1D, donc un ensemble de flux commute toujours terme à terme et son évolution n'entraîne aucune erreur de Trotter. Ce qui est nouveau, c'est qu'un ensemble de flux est désormais déconnecté : l'ensemble est d'un réseau rows x cols se compose de rows chemins indépendants de gauche à droite. Cette déconnexion est un atout plutôt qu'une complication, comme le montre l'étape 6.
3. Encoder l'opérateur
L'encodage est une fonction unique qui associe un seul opérateur de transfert généralisé à une chaîne de Pauli, laquelle est transmise à map_transfer_vertex_generators(). Par rapport à la version 1D, le corps comporte plus de cas : diagonal, horizontal, vertical, et les orientations inverses via .
Il y a un problème. map_transfer_vertex_generators() rappelle avec un générateur et rien d'autre, alors que pour décider de la chaîne de Pauli d'une liaison, il faut aussi cols afin de retrouver les coordonnées de ligne et de colonne à partir d'un indice de mode. Plutôt que d'imbriquer les fonctions pour le capturer, functools.partial() le lie, ce qui garde les deux fonctions au niveau supérieur et appelables indépendamment.
>>> from functools import partial
>>>
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def ancilla_qubit(mode, num_sites):
...     """The auxiliary qubit paired with fermionic mode `mode`."""
...     return num_sites + mode
>>>
>>> def vc_action(generator, width, cols):
...     """Map one generalized transfer operator to its Verstraete-Cirac Pauli."""
...     num_sites = width // 2
...     ancilla = partial(ancilla_qubit, num_sites=num_sites)
...     j, k = generator
...     if j == k:  # vertex operator V_j = Z_j
...         return SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     row_j, col_j = divmod(j, cols)
...     row_k, col_k = divmod(k, cols)
...     if row_j == row_k:  # horizontal: weight-3 triangle
...         left, right = (j, k) if col_j < col_k else (k, j)
...         operator = SparseObservable.from_sparse_list(
...             [("XXZ", [left, right, ancilla(left)], 0.5)], num_qubits=width
...         )
...         forward = (j, k) == (left, right)
...     else:  # vertical: weight-4 square
...         up, down = (j, k) if row_j < row_k else (k, j)
...         operator = SparseObservable.from_sparse_list(
...             [("XYXY", [up, down, ancilla(up), ancilla(down)], 0.5)], num_qubits=width
...         )
...         forward = (j, k) == (up, down)
...     if forward:
...         return operator
...     # reverse orientation: T_kj = -V_j V_k T_jk
...     v_j = SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     v_k = SparseObservable.from_sparse_list([("Z", [k], 1.0)], num_qubits=width)
...     return (-1.0 * v_j.compose(v_k).compose(operator)).simplify()
>>>
>>> def vc_encoding(operator, width, cols):
...     """Map a TransferVertexOperator to a qubit observable, Verstraete-Cirac style."""
...     return map_transfer_vertex_generators(
...         operator,
...         partial(vc_action, width=width, cols=cols),
...         identity=lambda: SparseObservable.identity(width),
...         compose=SparseObservable.compose,
...     ).simplify()
>>>
>>> # bind the lattice width once; the transpiler only ever passes (operator, width)
>>> encoding = partial(vc_encoding, cols=cols)
>>> num_qubits = 2 * num_sites
>>> num_qubits
18
L'intérêt de regrouper avant d'appliquer l'encodage se voit immédiatement : chaque ensemble de flux s'encode en une seule forme de Pauli, uniforme sur tout l'ensemble.
>>> for index, name in enumerate(names):
...     observable = encoding(hamiltonian.split_out_groups()[index], num_qubits)
...     shapes = sorted({label for label, _, _ in observable.to_sparse_list()})
...     print(f"{name:9s} {shapes}")
east      ['XXZ']
west      ['YYZ']
north     ['YXXY']
south     ['XYXY']
diagonal  ['', 'Z', 'ZZ']
Les quatre formes de saut sont distinctes, donc chaque ensemble de flux obtient son propre Clifford à l'étape 5. Les orientations inverses sont des Paulis différents, et non les mêmes renommés ; c'est pourquoi une synthèse d'ensembles de flux 2D nécessite quatre circuits, alors que la synthèse 1D n'en nécessite qu'un.
4. Transpiler avec l'encodage personnalisé
Cette étape est celle de la 1D avec un registre de qubits plus large : CustomF2QLayout associe le registre de modes à qubits, MapperFnEvolutionSynthesis porte l'encodage, et son argument product_formula sélectionne la façon dont la PauliEvolutionGate obtenue est décomposée. Compare avec l'étape 6 du guide 1D, qui construit le même pipeline pour une seule ancilla.
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit.synthesis import LieTrotter
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> total_time = 1.0
>>>
>>> def flow_set_pass_manager(mode_register, encoding, product_formula=None):
...     """Build the pipeline mapping `mode_register` with the VC `encoding`."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla per fermionic mode
...     qubit_register = QuantumRegister(2 * mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>>
>>> # as in 1D, one decompose() splits the Evolution group by group (five gates here,
>>> # the four hopping flow sets in group order, then the diagonal interaction)
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.count_ops()["Evolution"]
5
Cinq portes, portant les 6, 6, 6, 6 et 22 termes comptés à l'étape 2. Chacune est encodée et synthétisée indépendamment, de sorte que la partition décidée au niveau fermionique survit jusque dans le circuit :
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, encoding, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
18
>>>
>>> def two_qubit_stats(circuit):
...     decomposed = circuit.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops().get("cx", 0), decomposed.depth(two_qubit)
>>>
>>> two_qubit_stats(qubit_circuit)
(144, 47)
Voilà la référence : l'encodage et le regroupement sont tous deux en place, mais LieTrotter synthétise chaque ensemble de flux terme par terme, et la profondeur croît avec le réseau.
5. Un Clifford de profondeur 2 par ensemble de flux
Le mécanisme est le même qu'en 1D : conjuguer tout un ensemble de flux commutant par un Clifford qui envoie chacun de ses termes sur un Pauli distinct de poids 1, de sorte que l'évolution de l'ensemble entier ne coûte que des rotations à un qubit. En 1D, un seul brickwork de portes CZ y suffisait.
En 2D, chaque ensemble de flux a besoin de son propre circuit, d'après la section IV C et la fig. 7 de la Réf. [1]. Tous les quatre agissent sur une seule ligne du réseau à la fois (une rangée pour est/ouest, une colonne pour nord/sud) avec les ancillas de cette ligne, et tous ont la même forme en trois parties :
-
Une couche de rotations à un qubit, qui place chaque qubit dans la base dont son ensemble de flux a besoin.
-
Une première couche de
CX, toujours du site vers l'ancilla du même site. -
Une seconde couche de
CX, qui couple les voisins le long de la ligne.
Les étapes 2 et 3 sont les deux seules couches à deux qubits, donc la profondeur à deux qubits est de , quelle que soit la longueur de la ligne. Elles sont écrites ci-dessous, une fonction par ensemble de flux. Les rotations sont ce qu'elles sont parce qu'elles ont été trouvées, en conjuguant les termes de chaque ensemble de flux et en exigeant des images distinctes de poids 1 ; considère-les donc comme données et appuie-toi sur la vérification qui suit.
Les deux ensembles horizontaux sont les plus simples. Leurs termes sont de poids 3, XXZ et YYZ, et ne diffèrent que par le supplémentaire qui transforme en sur les sites :
>>> from qiskit.circuit import QuantumCircuit
>>>
>>> def east_clifford(circuit, line, ancilla):
...     """Diagonalize the east flow set (XXZ) on one lattice row."""
...     for j in line:
...         circuit.h(ancilla(j))
...     for j in line[:-1]:  # layer 1: each site with its own ancilla
...         circuit.cx(ancilla(j), j)
...     for j, k in zip(line, line[1:]):  # layer 2: ancilla with the next site along
...         circuit.cx(k, ancilla(j))
>>>
>>> def west_clifford(circuit, line, ancilla):
...     """Diagonalize the west flow set (YYZ) on one lattice row."""
...     for j in line:
...         circuit.s(j)  # the only difference from east: X -> Y on the sites
...         circuit.h(ancilla(j))
...     for j in line[:-1]:
...         circuit.cx(ancilla(j), j)
...     for j, k in zip(line, line[1:]):
...         circuit.cx(k, ancilla(j))
Les deux ensembles verticaux sont de poids 4, XYXY et YXXY, et sont par conséquent plus chargés : les rotations alternent selon la position le long de la ligne, et la seconde couche de CX alterne aussi, en couplant les sites aux positions paires et les ancillas aux positions impaires (ou l'inverse) :
>>> def south_clifford(circuit, line, ancilla):
...     """Diagonalize the south flow set (XYXY) on one lattice column."""
...     for position, j in enumerate(line):
...         if position % 2 == 0:
...             circuit.sdg(ancilla(j))
...             circuit.h(ancilla(j))
...         else:
...             circuit.h(j)
...             circuit.s(j)
...             circuit.h(ancilla(j))
...             circuit.s(ancilla(j))
...     for j in line:  # layer 1
...         circuit.cx(ancilla(j), j)
...     for position, (j, k) in enumerate(zip(line, line[1:])):  # layer 2
...         if position % 2 == 0:
...             circuit.cx(ancilla(j), ancilla(k))  # ancilla to ancilla
...         else:
...             circuit.cx(j, k)  # site to site
>>>
>>> def north_clifford(circuit, line, ancilla):
...     """Diagonalize the north flow set (YXXY) on one lattice column."""
...     for position, j in enumerate(line):
...         if position % 2 == 0:
...             circuit.h(ancilla(j))
...             circuit.s(ancilla(j))
...         else:
...             circuit.h(j)
...             circuit.s(j)
...             circuit.sdg(ancilla(j))
...             circuit.h(ancilla(j))
...     for j in line:  # layer 1
...         circuit.cx(ancilla(j), j)
...     for position, (j, k) in enumerate(zip(line, line[1:])):  # layer 2
...         if position % 2 == 0:
...             circuit.cx(k, j)  # site to site, and the other way round from south
...         else:
...             circuit.cx(ancilla(j), ancilla(k))
Dessiné sur une seule ligne de trois sites (d'abord ses sites, puis leurs ancillas), tout le mécanisme tient en une seule image. La forme triangle est la plus claire des deux : un changement de base sur les ancillas, puis deux couches de CX, la première associe chaque site à sa propre ancilla et la seconde atteint le site suivant le long de la ligne.
>>> line = [0, 1, 2]  # three sites, with ancillas on qubits 3, 4, 5
>>> triangle = QuantumCircuit(6)
>>> east_clifford(triangle, line, lambda mode: 3 + mode)
>>> triangle.draw("mpl")
<Figure size ... with 1 Axes>

La forme carrée demande plus de travail à un qubit (les rotations alternent le long de la ligne) et sa seconde couche de CX alterne entre le couplage de sites et le couplage d'ancillas :
>>> square = QuantumCircuit(6)
>>> south_clifford(square, line, lambda mode: 3 + mode)
>>> square.draw("mpl")
<Figure size ... with 1 Axes>

Les deux ont une profondeur de deux couches de CX, et ajouter des sites à la ligne les élargit sans les approfondir ; c'est toute l'affirmation de profondeur constante, visible par simple inspection. Les Cliffords ouest et nord ne diffèrent que par leurs couches à un qubit, donc ils ne sont pas dessinés séparément.
Ce dont la synthèse a encore besoin, c'est de déterminer où aboutit chaque terme. Une ligne de sites porte liaisons, chacune apportant un terme, donc la fonction auxiliaire ci-dessous renvoie une entrée par liaison : le qubit sur lequel le terme a atterri et le Pauli à un qubit qu'il est devenu. Point crucial, ces valeurs sont lues sur la conjugaison et non prédites. Contrairement à la 1D, où un brickwork de CZ envoie sous forme fermée, il n'existe pas de telle formule ici, et les ancillas d'une ligne de colonne ne sont pas contiguës. La seule chose qui diffère entre les ensembles de flux est la chaîne de Pauli en entrée, que l'étape 3 a déjà affichée :
>>> from qiskit.quantum_info import Clifford, SparsePauliOp
>>>
>>> def clifford_supports(clifford, pauli, line, ancilla, num_qubits):
...     """Conjugate a flow set's terms to find which qubit each one lands on.
...
...     `pauli` is the flow set's Pauli string, as printed in step 3. Its letters apply
...     to the i-th term's qubits in the order below: the two sites of the bond, then
...     their ancillas.
...
...     This is the one check that needs SparsePauliOp: Clifford conjugation wants a
...     `Pauli` and its symplectic bits, and SparseObservable exposes neither -- its own
...     `evolve` conjugates by a Pauli, not by a Clifford.
...     """
...     supports = []
...     for i in range(len(line) - 1):
...         qubits = [line[i], line[i + 1], ancilla(line[i]), ancilla(line[i + 1])]
...         term = SparsePauliOp.from_sparse_list(
...             [(pauli, qubits[: len(pauli)], 1.0)], num_qubits=num_qubits
...         )
...         image = term.paulis[0].evolve(clifford, frame="s")
...         # a weight-1 image has exactly one qubit with an X and/or Z bit set
...         (support,) = np.nonzero(image.x | image.z)
...         assert len(support) == 1, f"term {i} is not weight-1"
...         supports.append((int(support[0]), image[support].to_label()))
...     return supports
Les images doivent être distinctes et de poids 1, afin que chaque terme puisse être tourné indépendamment sur son propre qubit ; la profondeur à deux qubits de est déjà visible dans les quatre constructions ci-dessus, chacune émettant deux couches de CX quelle que soit la longueur de la ligne. Ci-dessous, les deux propriétés sont vérifiées sur chaque ensemble de flux, chaque ligne et plusieurs tailles de réseau. L'étape 6 appelle ensuite clifford_supports, qui est donc une partie opérationnelle de la synthèse et pas seulement une démonstration.
6. Synthèse tenant compte des ensembles de flux
La synthèse part avec une aide précieuse. Comme Evolution se découpe lui-même groupe par groupe, synthesize est appelée une fois par ensemble de flux (cinq fois ici, quatre ensembles de saut plus le groupe diagonal), de sorte que chaque terme de saut qu'elle voit partage une seule forme de Pauli, et qu'un seul Clifford les diagonalise tous. Elle n'a qu'à lire cette forme sur le premier terme et à trier les autres selon la ligne sur laquelle ils se trouvent. Vient ensuite l'observation qui rend deux dimensions moins coûteuses qu'on pourrait le craindre :
Les composantes d'un même ensemble de flux sont disjointes en sommets : les rangées de l'ensemble ouest ne partagent aucun qubit. Tous les Cliffords d'un ensemble de flux peuvent donc être émis ensemble et partagent les mêmes deux couches à deux qubits, au lieu de faire la queue l'un après l'autre. Un ensemble de flux coûte donc un nombre fixe de couches (deux pour le Clifford et deux pour son inverse) quel que soit le nombre de rangées ou de colonnes du réseau, c'est pourquoi la profondeur totale finit par être constante.
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> # The interaction couples nearest neighbors only, so every interior site carries four
>>> # Rzz gates -- one per bond -- and can only do one at a time: four layers is the best
>>> # any schedule can achieve. Horizontal bonds split by column parity, vertical ones by
>>> # row parity, which achieves it.
>>> def rzz_layers(circuit, angles, cols):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     horizontal = [(j, k) for j, k in angles if k - j == 1]
...     vertical = [(j, k) for j, k in angles if k - j == cols]
...     schedule = [
...         [(j, k) for j, k in horizontal if (j % cols) % 2 == 0],
...         [(j, k) for j, k in horizontal if (j % cols) % 2 == 1],
...         [(j, k) for j, k in vertical if (j // cols) % 2 == 0],
...         [(j, k) for j, k in vertical if (j // cols) % 2 == 1],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     """Synthesize one 2D line flow set at a time, via its depth-2 Clifford."""
...
...     preserve_order = True
...
...     def __init__(self, rows, cols):
...         self.rows, self.cols = rows, cols
...
...     def rows_of_lattice(self):
...         return [[r * self.cols + c for c in range(self.cols)] for r in range(self.rows)]
...
...     def columns_of_lattice(self):
...         return [[r * self.cols + c for r in range(self.rows)] for c in range(self.cols)]
...
...     def synthesize(self, evolution):
...         num_qubits = 2 * self.rows * self.cols
...         ancilla = partial(ancilla_qubit, num_sites=self.rows * self.cols)
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         terms = [
...             (label, indices, 2 * evolution.time * coeff.real)
...             for label, indices, coeff in evolution.operator.to_sparse_list()
...         ]
...
...         # `Evolution.decompose()` hands us one gate per flow set, so every hopping term
...         # here shares a single Pauli shape and one Clifford diagonalizes all of them
...         shapes = tuple({label for label, _, _ in terms} - {"", "Z", "ZZ"})
...         match shapes:
...             case ("XXZ",):
...                 clifford_function, lines = east_clifford, self.rows_of_lattice()
...                 along_rows = True
...             case ("YYZ",):
...                 clifford_function, lines = west_clifford, self.rows_of_lattice()
...                 along_rows = True
...             case ("XYXY",):
...                 clifford_function, lines = south_clifford, self.columns_of_lattice()
...                 along_rows = False
...             case ("YXXY",):
...                 clifford_function, lines = north_clifford, self.columns_of_lattice()
...                 along_rows = False
...             case ():  # the diagonal group: no conjugation needed
...                 self.diagonal(circuit, terms)
...                 return circuit
...             case _:
...                 raise ValueError(f"expected one known flow set per gate, got {shapes}")
...
...         # a term's line is the row it sits in and its slot the column, or vice versa
...         rotations: dict[int, list] = defaultdict(list)
...         for _, indices, angle in terms:
...             row, col = divmod(indices[0], self.cols)
...             line, slot = (row, col) if along_rows else (col, row)
...             rotations[line].append((slot, angle))
...
...         active = sorted(rotations)
...         # the lines of one flow set are vertex-disjoint, so all of their Cliffords
...         # are emitted together and share the same two two-qubit layers
...         conjugation = QuantumCircuit(num_qubits)
...         for line in active:
...             clifford_function(conjugation, lines[line], ancilla)
...         circuit.compose(conjugation, inplace=True)
...         for line in active:
...             supports = clifford_supports(
...                 Clifford(conjugation), shapes[0], lines[line], ancilla, num_qubits
...             )
...             for slot, angle in rotations[line]:
...                 match supports[slot]:
...                     case qubit, "X":
...                         circuit.rx(angle, qubit)
...                     case qubit, "Y":
...                         circuit.ry(angle, qubit)
...                     case qubit, "Z":
...                         circuit.rz(angle, qubit)
...         circuit.compose(conjugation.inverse(), inplace=True)
...         return circuit
...
...     def diagonal(self, circuit, terms):
...         """Synthesize the diagonal group: a phase, single-qubit Z and paired Rzz."""
...         rzz = {}
...         for label, indices, angle in terms:
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "Z", [qubit]:  # a lone vertex operator
...                     circuit.rz(angle, qubit)
...                 case "ZZ", [j, k]:  # interaction, see rzz_layers above
...                     rzz[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...         rzz_layers(circuit, rzz, self.cols)
Comme en 1D, elle est délibérément écrite pour cet encodage : elle reconnaît les quatre formes de Pauli et lève une erreur pour toute autre, plutôt que de se rabattre silencieusement sur autre chose. Elle suppose aussi la séparation d'un ensemble de flux par porte décrite ci-dessus, et le dit ; plus d'une forme de saut dans une même porte signifie que le regroupement n'a pas été appliqué, ce qui est une erreur et non quelque chose à contourner.
Comme son équivalent 1D, cette synthèse ne prend aucun nombre de pas de Trotter. Un pas de Trotter doit alterner entre les ensembles de flux, mais transpile_trotter_step ci-dessous décompose le circuit fermionique en une porte Evolution par ensemble, donc cette méthode ne voit jamais qu'un ensemble à la fois et ne pourrait répéter qu'à l'intérieur de celui-ci, ce qui ne change rien : répéter un seul opérateur revient à découper sa propre évolution en morceaux égaux.
La trotterisation à plusieurs pas nécessite donc une formule de produit qui respecte les groups de l'opérateur à l'intérieur d'une seule porte, avant la décomposition. FermionicLieTrotter le fait, et l'étape 10 l'utilise pour mesurer la convergence.
Note les deux classes aux noms voisins qui entrent en jeu. LieTrotter de Qiskit, utilisée plus haut comme référence, agit sur l'hamiltonien encodé, où le regroupement a déjà disparu. FermionicLieTrotter en est l'équivalent fermionique, et c'est celle qui peut encore voir les ensembles de flux.
7. Le résultat : une profondeur constante
Tout ce qui précède s'est exécuté sur l'unique réseau construit à l'étape 1. Comparer les deux chemins de synthèse sur des réseaux de taille croissante nécessite de répéter toute cette séquence (opérateur, regroupement, encodage, circuit, gestionnaire de passes) pour chaque taille, donc il vaut la peine de l'encapsuler une fois pour toutes :
>>> def transpile_trotter_step(rows, cols, product_formula, steps=1):
...     """Transpile `steps` Trotter steps on a `rows` x `cols` lattice."""
...     num_sites = rows * cols
...     operator = fermi_hubbard_2d(rows, cols, 1.0, 2.0)
...     operator.groups = flow_set_groups(operator, cols)
...     encoding = partial(vc_encoding, cols=cols)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites,
...             operator,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=steps),
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # split into one Evolution per flow set
...
...     pass_manager = flow_set_pass_manager(circuit.register, encoding, product_formula)
...     return pass_manager.run(circuit)
Collecter les deux métriques sur une plage de tailles de réseau et les tracer en fonction de l'arête du réseau rend la différence évidente :
>>> sizes = [3, 4, 5, 6, 7, 8]
>>> lie_trotter = [
...     two_qubit_stats(transpile_trotter_step(n, n, LieTrotter())) for n in sizes
... ]
>>> flow = [
...     two_qubit_stats(transpile_trotter_step(n, n, FlowSetSynthesis(n, n))) for n in sizes
... ]
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sizes, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sizes, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="lattice edge $L$ (an $L \\times L$ lattice)", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

La profondeur à deux qubits est de 24 et constante de à (soit de 18 qubits à 128), alors que LieTrotter appliquée à l'hamiltonien encodé de manière identique croît linéairement avec l'arête du réseau, de 47 à 92. Le nombre de portes croît dans les deux cas, puisqu'il y a termes à appliquer de toute façon ; ce que les ensembles de flux suppriment, c'est la croissance du nombre de couches occupées par ces portes.
Le budget se répartit en 16 pour le saut et huit pour l'interaction :
-
Chacun des quatre ensembles de flux coûte couches à deux qubits : son Clifford à l'entrée et l'inverse à la sortie, tous deux de profondeur deux par construction, avec seulement des rotations à un qubit entre les deux. Cela fait , qui est le chiffre cité par la Réf. [1], puisqu'elle ne compte que les termes de saut. Poser dans le code ci-dessus le reproduit.
-
Le groupe diagonal ajoute les huit restantes. Ses portes
Rzzse regroupent en quatre couches, et chaqueRzzse décompose en deux portesCXautour d'une rotation à un qubit, donc . Quatre couches est optimal : sur un réseau carré, l'interaction n'atteint que les plus proches voisins, donc chaque site intérieur porte quatre portesRzz(une par liaison) et ne peut participer qu'à une seule à la fois.
Rien dans l'une ou l'autre somme ne fait référence à la taille du réseau, et c'est tout l'intérêt.
8. Vérifier le circuit
La synthèse par ensembles de flux et LieTrotter décrivent le même pas de Trotter du même hamiltonien encodé, donc leurs unitaires doivent coïncider à une phase globale près. Des vecteurs d'état aléatoires détectent toute divergence bien plus économiquement que la construction de l'unitaire complet :
Les deux circuits sont décomposés en portes à un et deux qubits avant d'être appliqués à un état. Si on les laissait non décomposés, chaque instruction Evolution de haut niveau forcerait Statevector à construire son opérateur dense complet ; décomposer d'abord lui permet d'appliquer les portes une à une, ce qui est ici plusieurs centaines de fois plus rapide.
>>> import numpy as np
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(rows, cols, samples=3):
...     """Compare both syntheses on random states.
...
...     Returns whether they agree up to a phase, and whether it is the *same* phase
...     for every input state.
...     """
...     lie_trotter = transpile_trotter_step(
...         rows, cols, LieTrotter()
...     ).decompose(reps=6)
...     flow = transpile_trotter_step(
...         rows, cols, FlowSetSynthesis(rows, cols)
...     ).decompose(reps=6)
...     dimension = 2**lie_trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(lie_trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> agrees_up_to_one_phase(rows, cols)
(True, True)
Les deux moitiés de cette vérification comptent. Un recouvrement de module unité sur un seul état est nécessaire mais non suffisant : une synthèse dont la phase dépend de l'état et est erronée le montrerait quand même. Exiger la même phase sur plusieurs états aléatoires est ce qui comble l'écart.
9. Vérifier la physique sur le sous-espace des stabilisateurs
C'est la difficulté propre au deux dimensions. En 1D, l'encodage était une isométrie, et comparer les spectres à une référence de Jordan-Wigner suffisait. VC n'est pas une isométrie : il utilise qubits pour modes, donc un espace de dimension contient un espace physique de dimension . C'est générique pour les encodages locaux en deux dimensions (les qubits excédentaires sont contraints par des symétries locales commutantes, une par plaquette [2] [3]) et cela signifie que l'hamiltonien encodé ne représente fidèlement l'hamiltonien fermionique que sur l'espace propre conjoint de ces contraintes.
Le mot stabilisateur a un double emploi dans ce domaine, et les deux sens n'ont aucun rapport. La Réf. [1] l'emploie pour les opérateurs de transfert commutants d'un ensemble de flux, qui forment un groupe stabilisateur que les Cliffords de l'étape 5 diagonalisent (un artifice de compilation, et le sens visé partout plus haut). Cette section l'emploie au sens de la correction d'erreurs : des opérateurs dont l'espace propre est le sous-espace physique. La Réf. [1] signale explicitement cette collision et met de côté le second sens ; les contraintes de plaquette ci-dessous sont une propriété de l'encodage VC [2], et non un résultat du cadre des ensembles de flux.
Les générateurs sont construits ici plutôt que cités : un par face carrée, et chacun est simplement la boucle d'opérateurs d'arête encodés autour de cette face.
Les opérateurs d'arête sont l'objet naturel pour cela. Une boucle fermée de ceux-ci est une symétrie de tout hamiltonien conservant le nombre de particules, alors que la boucle correspondante d'opérateurs de transfert ne l'est pas : les deux diffèrent par un opérateur de sommet sur le site source de chaque liaison,
Le long d'une boucle fermée, chaque site est la source d'exactement une liaison, donc la boucle recueille un par site, qui est la parité locale des quatre sites de la plaquette. Cette parité locale fait toute la différence : l'hamiltonien fait sauter des particules à travers la frontière de la plaquette, donc il ne conserve que la parité globale. La boucle de transfert brute ne commute donc pas avec lui, alors que la boucle d'arête (qui porte le facteur de parité) commute.
Comme l'encodage est défini sur les opérateurs de transfert, encoder un opérateur d'arête nécessite la relation ci-dessus. C'est un rappel de cinq lignes, et il s'insère dans map_edge_vertex_generators() exactement comme vc_action s'insère dans map_transfer_vertex_generators() :
>>> from qiskit_fermions.mappers import map_edge_vertex_generators
>>> from qiskit_fermions.operators import EdgeVertexOperator
>>>
>>> def vc_edge_action(generator, width, cols):
...     """Map one generalized *edge* operator to its Verstraete-Cirac Pauli."""
...     j, k = generator
...     if j == k:  # a vertex operator is the same object in both algebras
...         return SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     # The library decomposes T_jk = (i/2) V_j E_jk, so E_jk = -2i V_j T_jk. Reuse the
...     # transfer encoding for T_jk rather than repeating its four cases here. Note that
...     # `compose` left-multiplies its argument, so this composes to V_j T_jk; the other
...     # order carries the opposite sign, since a vertex and a transfer operator sharing a
...     # mode anticommute.
...     vertex = SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_qubits=width)
...     return (-2.0j * vc_action(generator, width, cols).compose(vertex)).simplify()
>>>
>>> def vc_edge_encoding(operator, width, cols):
...     """Map an EdgeVertexOperator to a qubit observable, Verstraete-Cirac style."""
...     return map_edge_vertex_generators(
...         operator,
...         partial(vc_edge_action, width=width, cols=cols),
...         identity=lambda: SparseObservable.identity(width),
...         compose=SparseObservable.compose,
...     ).simplify()
>>>
>>> def plaquette_loops(rows, cols):
...     """The directed edge loop around each square face."""
...     at = lambda r, c: r * cols + c
...     return [
...         [(at(r, c), at(r, c + 1)), (at(r, c + 1), at(r + 1, c + 1)),
...          (at(r + 1, c + 1), at(r + 1, c)), (at(r + 1, c), at(r, c))]
...         for r in range(rows - 1)
...         for c in range(cols - 1)
...     ]
>>>
>>> def stabilizers(rows, cols):
...     """One plaquette stabilizer per square face of the lattice."""
...     num_qubits = 2 * rows * cols
...     out = []
...     for loop in plaquette_loops(rows, cols):
...         loop_operator = EdgeVertexOperator.from_dict({tuple(loop): 1.0})
...         encoded_loop = vc_edge_encoding(loop_operator, num_qubits, cols)
...         out.append(encoded_loop / complex(encoded_loop.coeffs[0]))
...     return out
>>>
>>> plaquette_stabilizers = stabilizers(rows, cols)
>>> for stabilizer in plaquette_stabilizers:
...     print(stabilizer.to_sparse_list())
[('ZZYXXY', [1, 4, 9, 10, 12, 13], (1+0j))]
[('ZZYXXY', [2, 5, 10, 11, 13, 14], (1+0j))]
[('ZZYXXY', [4, 7, 12, 13, 15, 16], (1+0j))]
[('ZZYXXY', [5, 8, 13, 14, 16, 17], (1+0j))]
Chaque générateur a un poids , réparti sur deux des qubits physiques de sa plaquette et quatre ancillas. Ils sont involutifs et commutent avec l'hamiltonien encodé, donc le sous-espace physique est préservé par la dynamique. Ces deux propriétés sont des énoncés sur des opérateurs, elles sont donc vérifiées symboliquement sur l'algèbre de SparseObservable, sans aucune matrice :
>>> encoded = encoding(hamiltonian, num_qubits)
>>> identity = SparseObservable.identity(num_qubits)
>>> for stabilizer in plaquette_stabilizers:
...     square = stabilizer.compose(stabilizer).simplify()
...     print(square == identity, stabilizer.commutes(encoded))
True True
True True
True True
True True
Avec les stabilisateurs en main, la comparaison n'a besoin d'aucune correspondance de base, car signifie que les occupations vivent sur les mêmes qubits physiques dans les deux représentations. On procède donc ainsi : écrire un état produit directement sur les qubits physiques avec les ancillas dans , le projeter sur le sous-espace des stabilisateurs, l'évoluer avec l'hamiltonien encodé, et lire les densités de site des deux côtés.
Chaque étape reste ici au niveau d'un vecteur. Le projecteur est appliqué un facteur à la fois au lieu d'être développé, et l'évolution temporelle utilise expm_multiply(), qui calcule sans jamais former . Comme l'hamiltonien encodé est un opérateur creux de dimension , cette distinction est ce qui rend cette section peu coûteuse.
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> # an exact evolution time, unrelated to the Trotter step above
>>> evolution_time = 0.6
>>> reference = transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify()
>>>
>>> def to_sparse_matrix(observable):
...     # SparseObservable carries no dense- or sparse-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the numerical checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def basis_state(occupation, num_qubits):
...     """The computational basis state with `occupation` on the first qubits.
...
...     Qubit `q` carries bit `2**q`, and the ancillas are the *high* qubits `N..2N-1`,
...     so the same integer indexes the same site occupations on either register and
...     leaves every ancilla in |0>.
...     """
...     index = int("".join(str(bit) for bit in reversed(occupation)), 2)
...     state = np.zeros(2**num_qubits, dtype=complex)
...     state[index] = 1.0
...     return state
>>>
>>> def project_onto_codespace(state, stabilizers):
...     """Apply the projector one (1 + S) factor at a time, then renormalize.
...
...     The factors commute, so their product is itself a projector and the order does
...     not matter. Multiplying it out would build a dense 2^2N x 2^2N operator; applied
...     factor by factor this stays a handful of sparse matrix-vector products.
...
...     Each factor is really (1 + S)/2, but every one contributes the same scalar, so the
...     halvings only rescale the result and the final normalization absorbs them.
...     """
...     for stabilizer in stabilizers:
...         state += to_sparse_matrix(stabilizer) @ state
...     return state / np.linalg.norm(state)
>>>
>>> occupation = [1, 0, 1, 0, 1, 0, 0, 1, 0]  # site occupations of the initial state
>>> initial_reference = basis_state(occupation, num_sites)
>>> initial_encoded = project_onto_codespace(
...     basis_state(occupation, num_qubits), plaquette_stabilizers
... )
>>>
>>> evolved_encoded = expm_multiply(
...     -1j * evolution_time * to_sparse_matrix(encoded), initial_encoded
... )
>>> evolved_reference = expm_multiply(
...     -1j * evolution_time * to_sparse_matrix(reference), initial_reference
... )
>>>
>>> def density(state, qubit, width):
...     """Site density <n_j> = (1 - <Z_j>) / 2 of a statevector."""
...     z = to_sparse_matrix(
...         SparseObservable.from_sparse_list([("Z", [qubit], 1.0)], num_qubits=width)
...     )
...     return (1 - (state.conj() @ (z @ state)).real) / 2
>>>
>>> encoded_densities = [density(evolved_encoded, j, num_qubits) for j in range(num_sites)]
>>> reference_densities = [density(evolved_reference, j, num_sites) for j in range(num_sites)]
>>>
>>> for j, density_value in enumerate(encoded_densities):
...     print(f"site {j}: {density_value:.10f}")
site 0: 0.6750993356
site 1: 0.3689791258
site 2: 0.6750993356
site 3: 0.3818130396
site 4: 0.4868585996
site 5: 0.3818130396
site 6: 0.2693544696
site 7: 0.4916285849
site 8: 0.2693544696
>>> np.allclose(encoded_densities, reference_densities, atol=1e-12)
True
Ce sont les densités encodées ; elles coïncident avec la référence de Jordan-Wigner à la précision machine, sur un réseau dont l'encodage n'est fidèle qu'après projection.
10. Mesurer la convergence de Trotter
L'étape 8 a établi que les deux synthèses concordent entre elles, ce qui est un énoncé d'équivalence plutôt que de précision : toutes deux décrivent le même pas de Trotter, donc toutes deux portent la même erreur de Trotter. Mesurer cette erreur nécessite une référence exacte, et l'étape 9 vient d'en construire une.
Le nombre de pas provient de FermionicLieTrotter, l'équivalent fermionique de la formule au niveau des qubits utilisée plus haut comme référence. Appliquée à tout l'opérateur groupé avant la décomposition, sa répétition alterne entre les quatre ensembles de flux et le groupe diagonal au lieu de rester à l'intérieur de l'un d'eux :
>>> initial_state = project_onto_codespace(
...     basis_state(occupation, num_qubits), plaquette_stabilizers
... )
>>> exact = expm_multiply(
...     -1j * total_time * to_sparse_matrix(encoded), initial_state
... )
>>>
>>> def trotter_fidelity(steps):
...     # `steps` goes to the fermionic formula inside transpile_trotter_step, so the
...     # repetition cycles between the flow sets rather than within any one of them
...     circuit = transpile_trotter_step(
...         rows, cols, FlowSetSynthesis(rows, cols), steps=steps
...     )
...     evolved = Statevector(initial_state).evolve(circuit.decompose(reps=6))
...     return abs(np.vdot(evolved.data, exact)) ** 2
>>>
>>> for steps in (1, 2, 4, 8):
...     print(f"{steps} step(s): fidelity {trotter_fidelity(steps):.6f}")
1 step(s): fidelity 0.053820
2 step(s): fidelity 0.704014
4 step(s): fidelity 0.932937
8 step(s): fidelity 0.982687
La fidélité monte de façon monotone vers un à mesure que les pas raccourcissent, ce qui est le comportement que doit montrer une formule de produit. Raccourcir les pas n'est que l'un des deux leviers ; FermionicSuzukiTrotter les met en balance à un ordre supérieur, comme le mesure Synthétiser une porte Evolution dans l'espace fermionique.
Un seul pas de cet hamiltonien à est une mauvaise approximation (les quatre ensembles de saut et l'interaction ne commutent pas), donc la première ligne est loin de un, et c'est le but : c'est la convergence qui confirme la construction, pas une ligne isolée.
Chaque facteur du calendrier couvre tous les modes de ce réseau, donc restreindre un facteur à son support est sans effet ici et les indices de qubits absolus sur lesquels FlowSetSynthesis s'appuie restent inchangés. Une synthèse écrite pour un opérateur dont les groupes ne touchent qu'une partie du registre devrait tenir compte de ce changement d'étiquetage.
Ce qu'il faut retenir
-
Deux dimensions changent la comptabilité, pas la recette. Chaque ingrédient du guide 1D se transpose sans modification :
groupspour le regroupement,map_transfer_vertex_generators()pour l'encodage,CustomF2QLayoutpour le registre inadapté, etMapperFnEvolutionSynthesispour le brancher dans le transpileur. Ce qui a grandi, c'est le nombre de cas à l'intérieur de chacun. -
La disjonction est ce qui rend la 2D à profondeur constante. Un ensemble de flux se décompose en lignes disjointes en sommets, donc ses Cliffords sont émis en parallèle et partagent deux couches à deux qubits quelle que soit la taille du réseau. Quatre ensembles de flux et un groupe diagonal donnent alors un budget fixe : ici pour les quatre ensembles de flux plus pour le groupe d'interaction diagonal.
-
Chaque orientation est sa propre forme de Pauli. transforme
XXZenYYZetXYXYenYXXY, donc les quatre ensembles de flux nécessitent quatre Cliffords. Supposer qu'un seul Clifford couvre les deux orientations d'un axe est la manière la plus simple de se tromper dans une synthèse d'ensembles de flux 2D. -
Lire les supports sur la conjugaison. En 1D, un brickwork de
CZdonne les images sous forme fermée. En 2D, il n'existe pas de telle formule, et les lignes de colonne ont des ancillas non contiguës, donc une supposition dérivée à la main sur l'endroit où atterrit chaque terme est fragile. Conjuguer et inspecter le résultat coûte une construction deCliffordet ne peut pas être faux ; cela signifie aussi qu'un Clifford tout aussi valide qui envoie les termes ailleurs continue de fonctionner. -
Laisser le regroupement faire le tri. Comme
Evolutionse découpe lui-même par groupe, la synthèse reçoit un ensemble de flux à la fois et n'a jamais à redériver la partition : elle lit une forme de Pauli sur le premier terme et choisit le Clifford correspondant. Supposer cela, et lever une erreur quand ce n'est pas le cas, est ce qui gardesynthesizecourte. -
Le nombre de pas se situe au-dessus de la séparation. La synthèse voit ici un ensemble de flux par porte, donc elle ne peut pas subdiviser l'évolution entre les ensembles.
FermionicLieTrotterle fait dans l'espace fermionique, avant la décomposition, ce qui rend un test de convergence possible. -
Vérifier sur le sous-espace. Un encodage de modes sur qubits n'est fidèle que là où les stabilisateurs le disent. Comme VC conserve , la vérification fiable la moins coûteuse consiste à projeter un état produit et à comparer les densités : pas d'entrelaceur et pas de comparaison spectrale, qui n'est pas fiable lorsque l'hamiltonien restreint est dégénéré.
L'hamiltonien encodé commute avec les stabilisateurs, donc la projection n'a besoin d'être appliquée qu'à l'état initial. L'évolution préserve le sous-espace d'elle-même. Sur du matériel réel, c'est aussi ce qui rend l'encodage utile comme ressource de détection d'erreurs : les stabilisateurs peuvent être mesurés.
Suite
Deux directions prolongent ce qui précède, et toutes deux sont des changements d'ingrédient plutôt que de méthode. La première est l'encodage : Verstraete-Cirac a été choisi ici parce que la Réf. [1] donne ses Cliffords de diagonalisation sous forme fermée, mais Derby-Klassen dépense une ancilla par plaquette impaire au lieu d'une par site, pour un rapport qubits/modes de au lieu de . Ses opérateurs de transfert ont des formes de Pauli différentes, donc un portage revient à réécrire la fonction d'encodage de l'étape 3 et à trouver le Clifford de chaque nouvelle forme ; le regroupement, la disposition et l'échafaudage de synthèse se transposent sans changement.
La seconde est le réseau lui-même. Tout ce qui précède suppose des bords ouverts et une seule espèce fermionique. Des bords périodiques referment chaque ligne en cycle : les flèches commutent toujours toutes, puisque chacune rencontre la suivante bout à bout, mais les deux formes de Clifford de l'étape 5 sont construites pour une ligne avec extrémités. Un cycle de sites porte liaisons par orientation là où une ligne en porte , donc la liaison de bouclage n'a pas de place dans la construction et demande un traitement à part. Un modèle avec spin est plus facile : il double le registre et ajoute des termes d'interaction sur site au groupe diagonal, sans toucher aux ensembles de flux. Ni l'un ni l'autre ne perturbe l'argument de profondeur constante, mais tous deux changent la comptabilité, qui, comme le dit le premier point à retenir, est la partie que les deux dimensions agrandissent.
La connectivité matérielle n'est pas traitée ici. Chaque circuit ci-dessus est construit sur un registre abstrait où n'importe quelle paire de qubits peut interagir, et les profondeurs indiquées sont comptées dans ce cadre. Les appareils réels ont une carte de couplage restreinte, et projeter cet encodage sur l'une d'elles est un problème substantiel en soi : le registre VC est un graphe de qubits dont les portes agissent entre un site et sa propre ancilla, entre sites voisins et entre ancillas voisines, donc une disposition doit garder simultanément adjacents ces trois types de paires. Si elle n'y parvient pas, le transpileur insère des portes SWAP, et les couches qu'elles ajoutent sont ce que la construction à profondeur constante permettait de regagner. La Réf. [1] cite de même son chiffre de profondeur sous l'hypothèse d'un graphe de connectivité carré avec CX comme seul intriqueur natif. Trouver de bonnes dispositions et stratégies de routage pour des encodages locaux sur une topologie d'appareil donnée dépasse le cadre de ce guide.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.
F. Verstraete and J. I. Cirac, Mapping local Hamiltonians of fermions to local Hamiltonians of spins, J. Stat. Mech. 2005, P09012 (2005).
Y.-A. Chen and Y. Xu, Equivalence between fermion-to-qubit mappings in two spatial dimensions, PRX Quantum 4, 010326 (2023).