Suppression et façonnage des erreurs
La suppression des erreurs peut désigner toute technique qui anticipe et tente d'éviter certains types de bruit et d'erreurs. Cela s'explique plus facilement à travers des exemples concrets, mais gardez à l'esprit que ces méthodes ne se limitent pas aux exemples présentés ici, et que de nouvelles méthodes sont continuellement explorées. Parfois, il n'est pas possible de supprimer les erreurs, mais il est possible d'agir sur la façon dont elles s'accumulent. Si nous pouvons faire en sorte que les erreurs s'accumulent plus lentement, on pourrait décrire cela comme une suppression de l'erreur globale, mais il est plus juste de le considérer comme un façonnage du bruit. Dans cette leçon, nous couvrons des exemples canoniques de suppression d'erreurs (découplage dynamique) et de façonnage/mise en forme du bruit (Pauli twirling).
Une vidéo accompagnant cette leçon sera mise en ligne dans les prochains jours, et sera intégrée ici.
Découplage dynamique
Commençons par un état très simple sur un seul qubit, et introduisons un modèle de bruit simple. Cela ne suffit pas à expliquer complètement le découplage dynamique, mais cela nous donne un exemple clair. Supposons que nous ayons un qubit préparé dans un état de superposition à l'aide d'une porte de Hadamard :
Cet état est visualisé sur la sphère de Bloch comme indiqué ci-dessous à gauche. Dans le cas idéal sans bruit, ce qubit resterait dans cet état jusqu'à la prochaine opération. Cependant, nous savons d'après la leçon précédente que ce n'est pas ce que nous observons. Le bruit provoque la dégradation de l'information quantique.
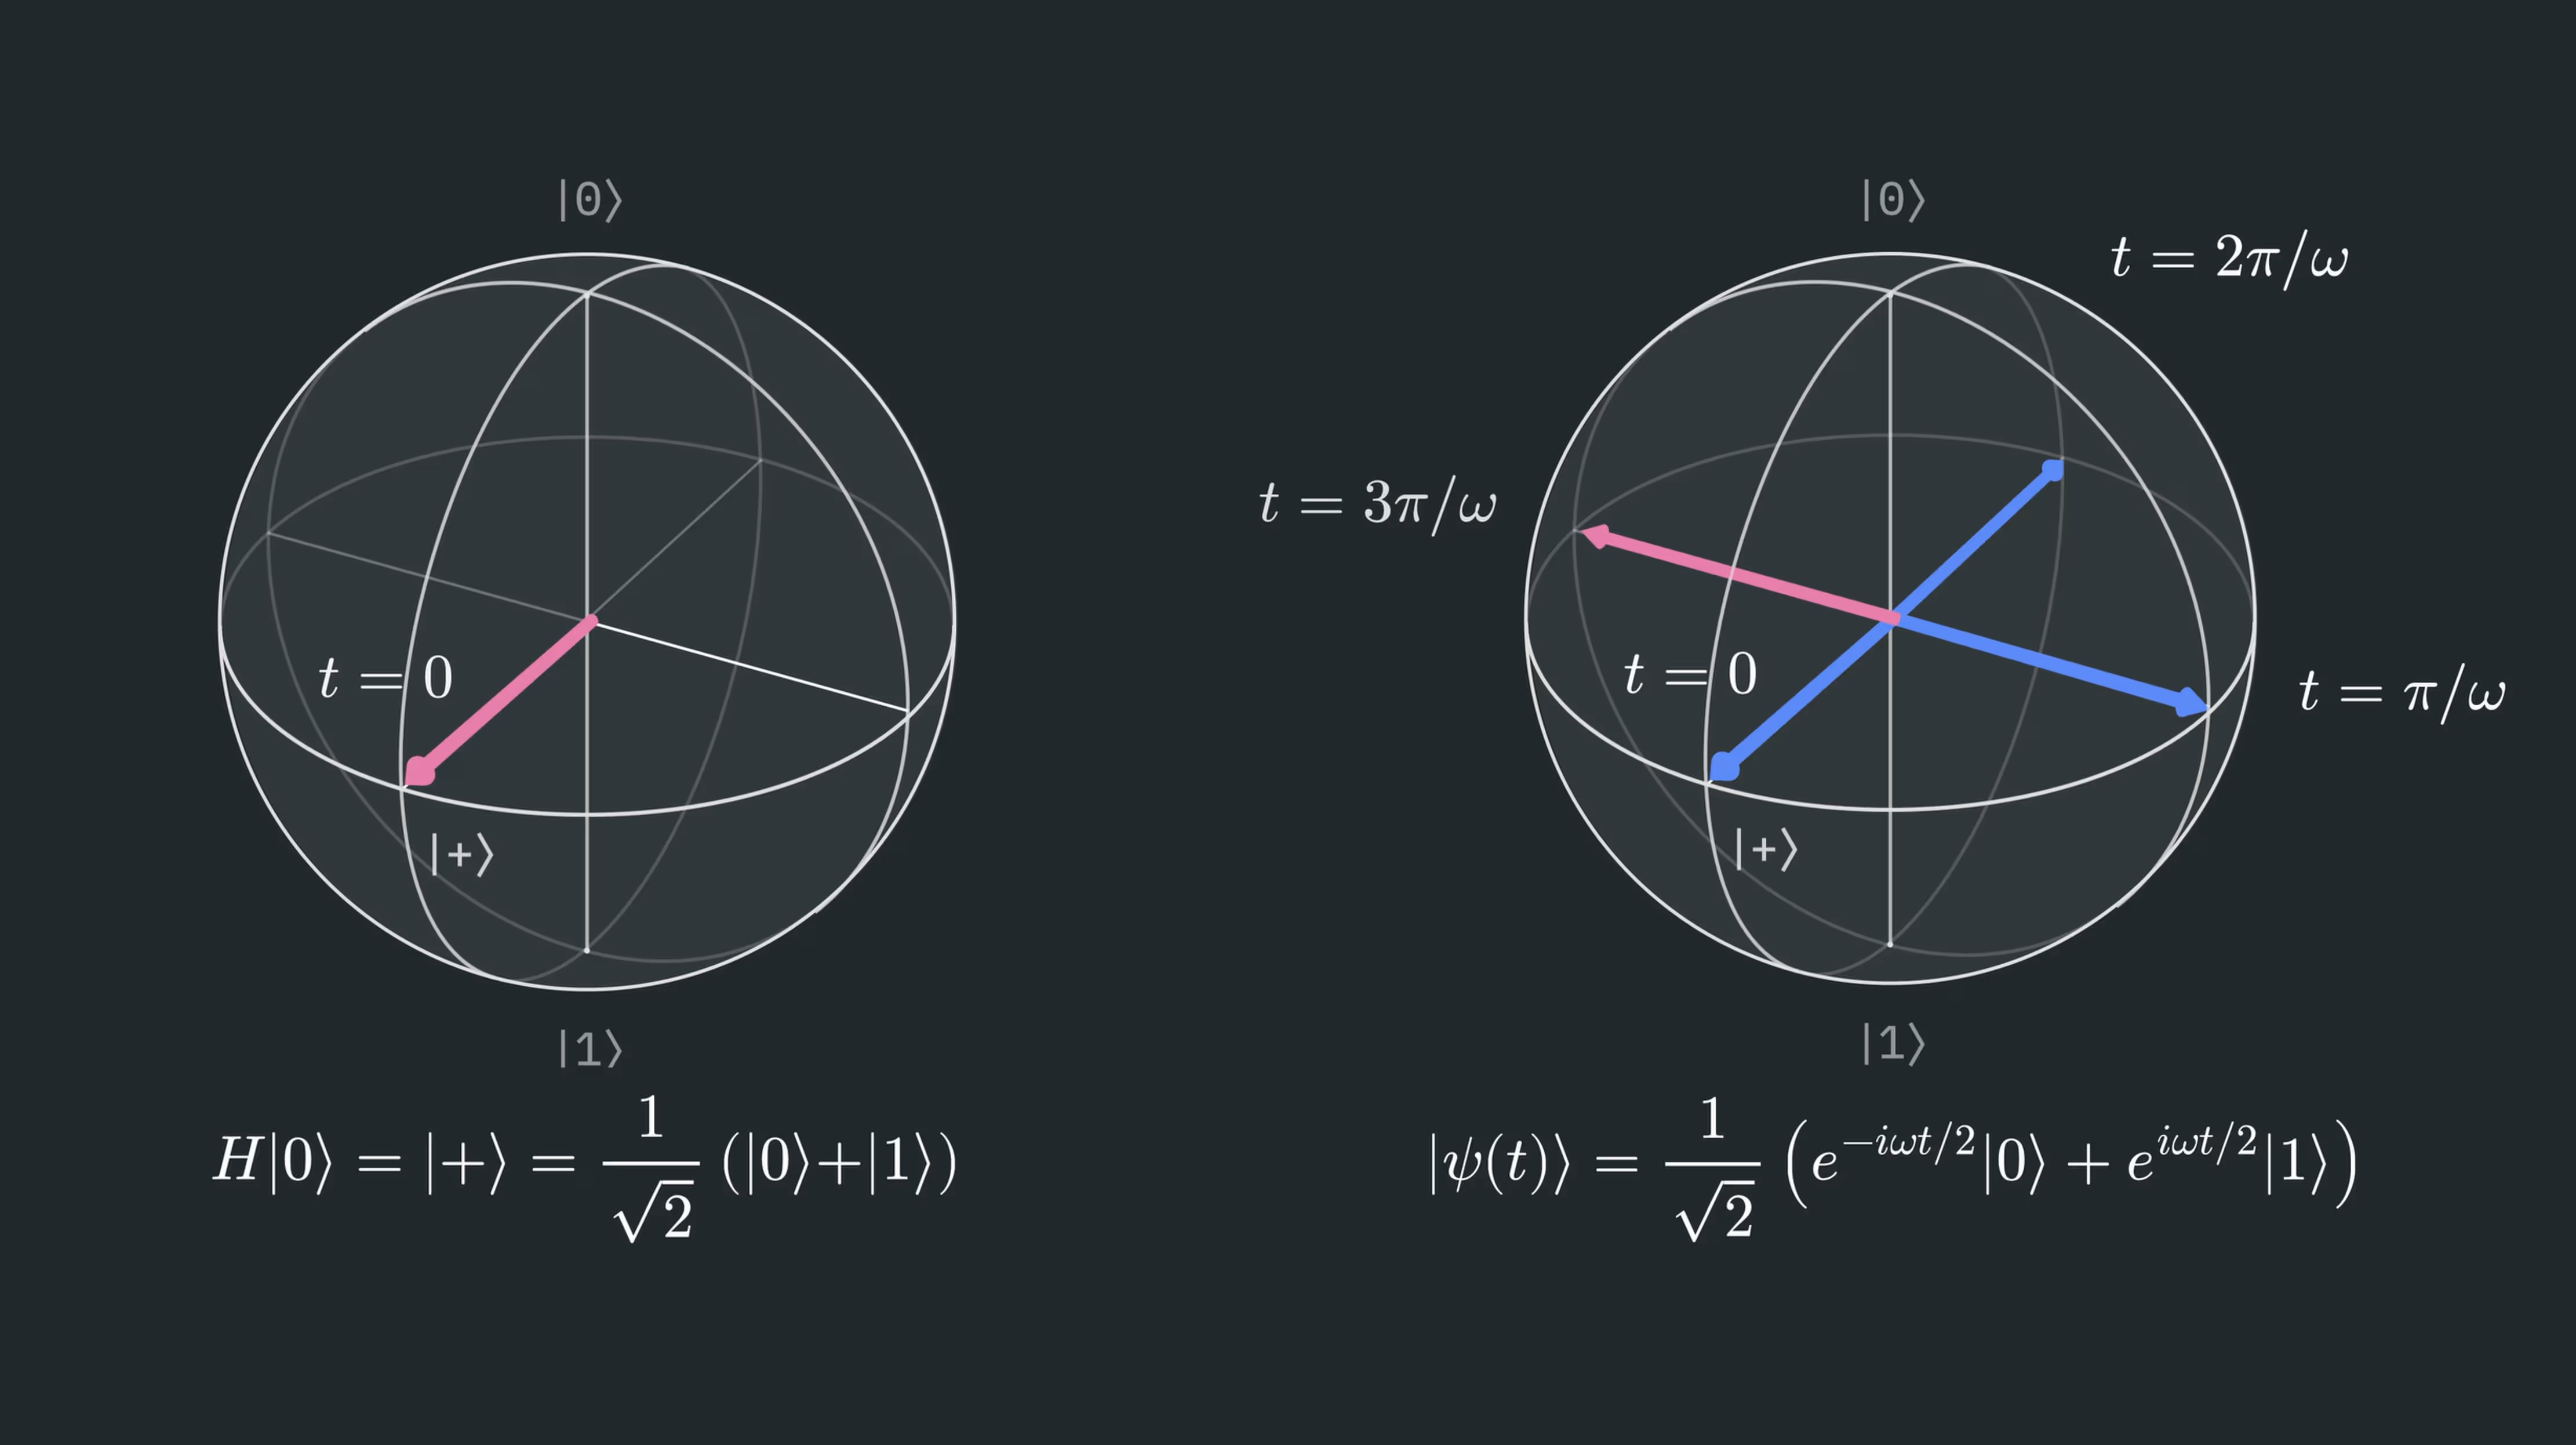
Le bruit ou le couplage environnemental peut faire varier la phase relative entre les états de base. C'est-à-dire que les probabilités de et ne changent pas, car les valeurs absolues de leurs coefficients ne changent pas. En revanche, les phases des amplitudes changent, modifiant leurs composantes réelle et imaginaire. Pour rendre cette discussion plus concrète, considérons un type d'interaction pouvant causer cela : le couplage à un champ magnétique orienté selon la direction Z : .
Considérons ce qui arrive à l'état au fil du temps :
Nous avons utilisé ici le fait qu'un champ magnétique dans la direction Z provoque une précession autour de l'axe Z avec une fréquence qui dépend du moment magnétique effectif et de l'intensité du champ magnétique. Les détails sont moins importants que le fait que cette interaction provoque une évolution autour de l'axe Z, entraînant une accumulation de phase opposée pour les deux états de base computationnels. En appliquant cet opérateur à chaque terme de , nous obtenons ce qui suit :
Cette phase dépendante du temps correspond à une précession autour de l'axe Z dans la représentation de la sphère de Bloch. Cela est illustré dans la moitié droite de la figure ci-dessus.
Si nous savions que cette interaction se produisait de manière contrôlée, nous pourrions la prédire. Pour modéliser ce type de bruit, nous considérons plutôt une distribution des intensités possibles du champ magnétique, chacune se produisant avec une certaine probabilité classique (d'autres sources de bruit devraient être modélisées différemment). Nous devons considérer ce qui se passe lorsqu'il existe une probabilité classique non nulle que l'état n'ait pas du tout tourné, ainsi qu'une certaine probabilité qu'il ait tourné d'une petite quantité, voire d'une grande quantité. Cette distribution de rotations possibles est la raison de l'étalement de l'état dans la représentation de la sphère de Bloch ci-dessous. S'il y a davantage de ce bruit de déphasage, la phase sera moins bien définie. Dans la limite d'un déphasage fort, le qubit devient complètement déphasé, ce qui correspond à la perte de la cohérence quantique stockée dans l'état.
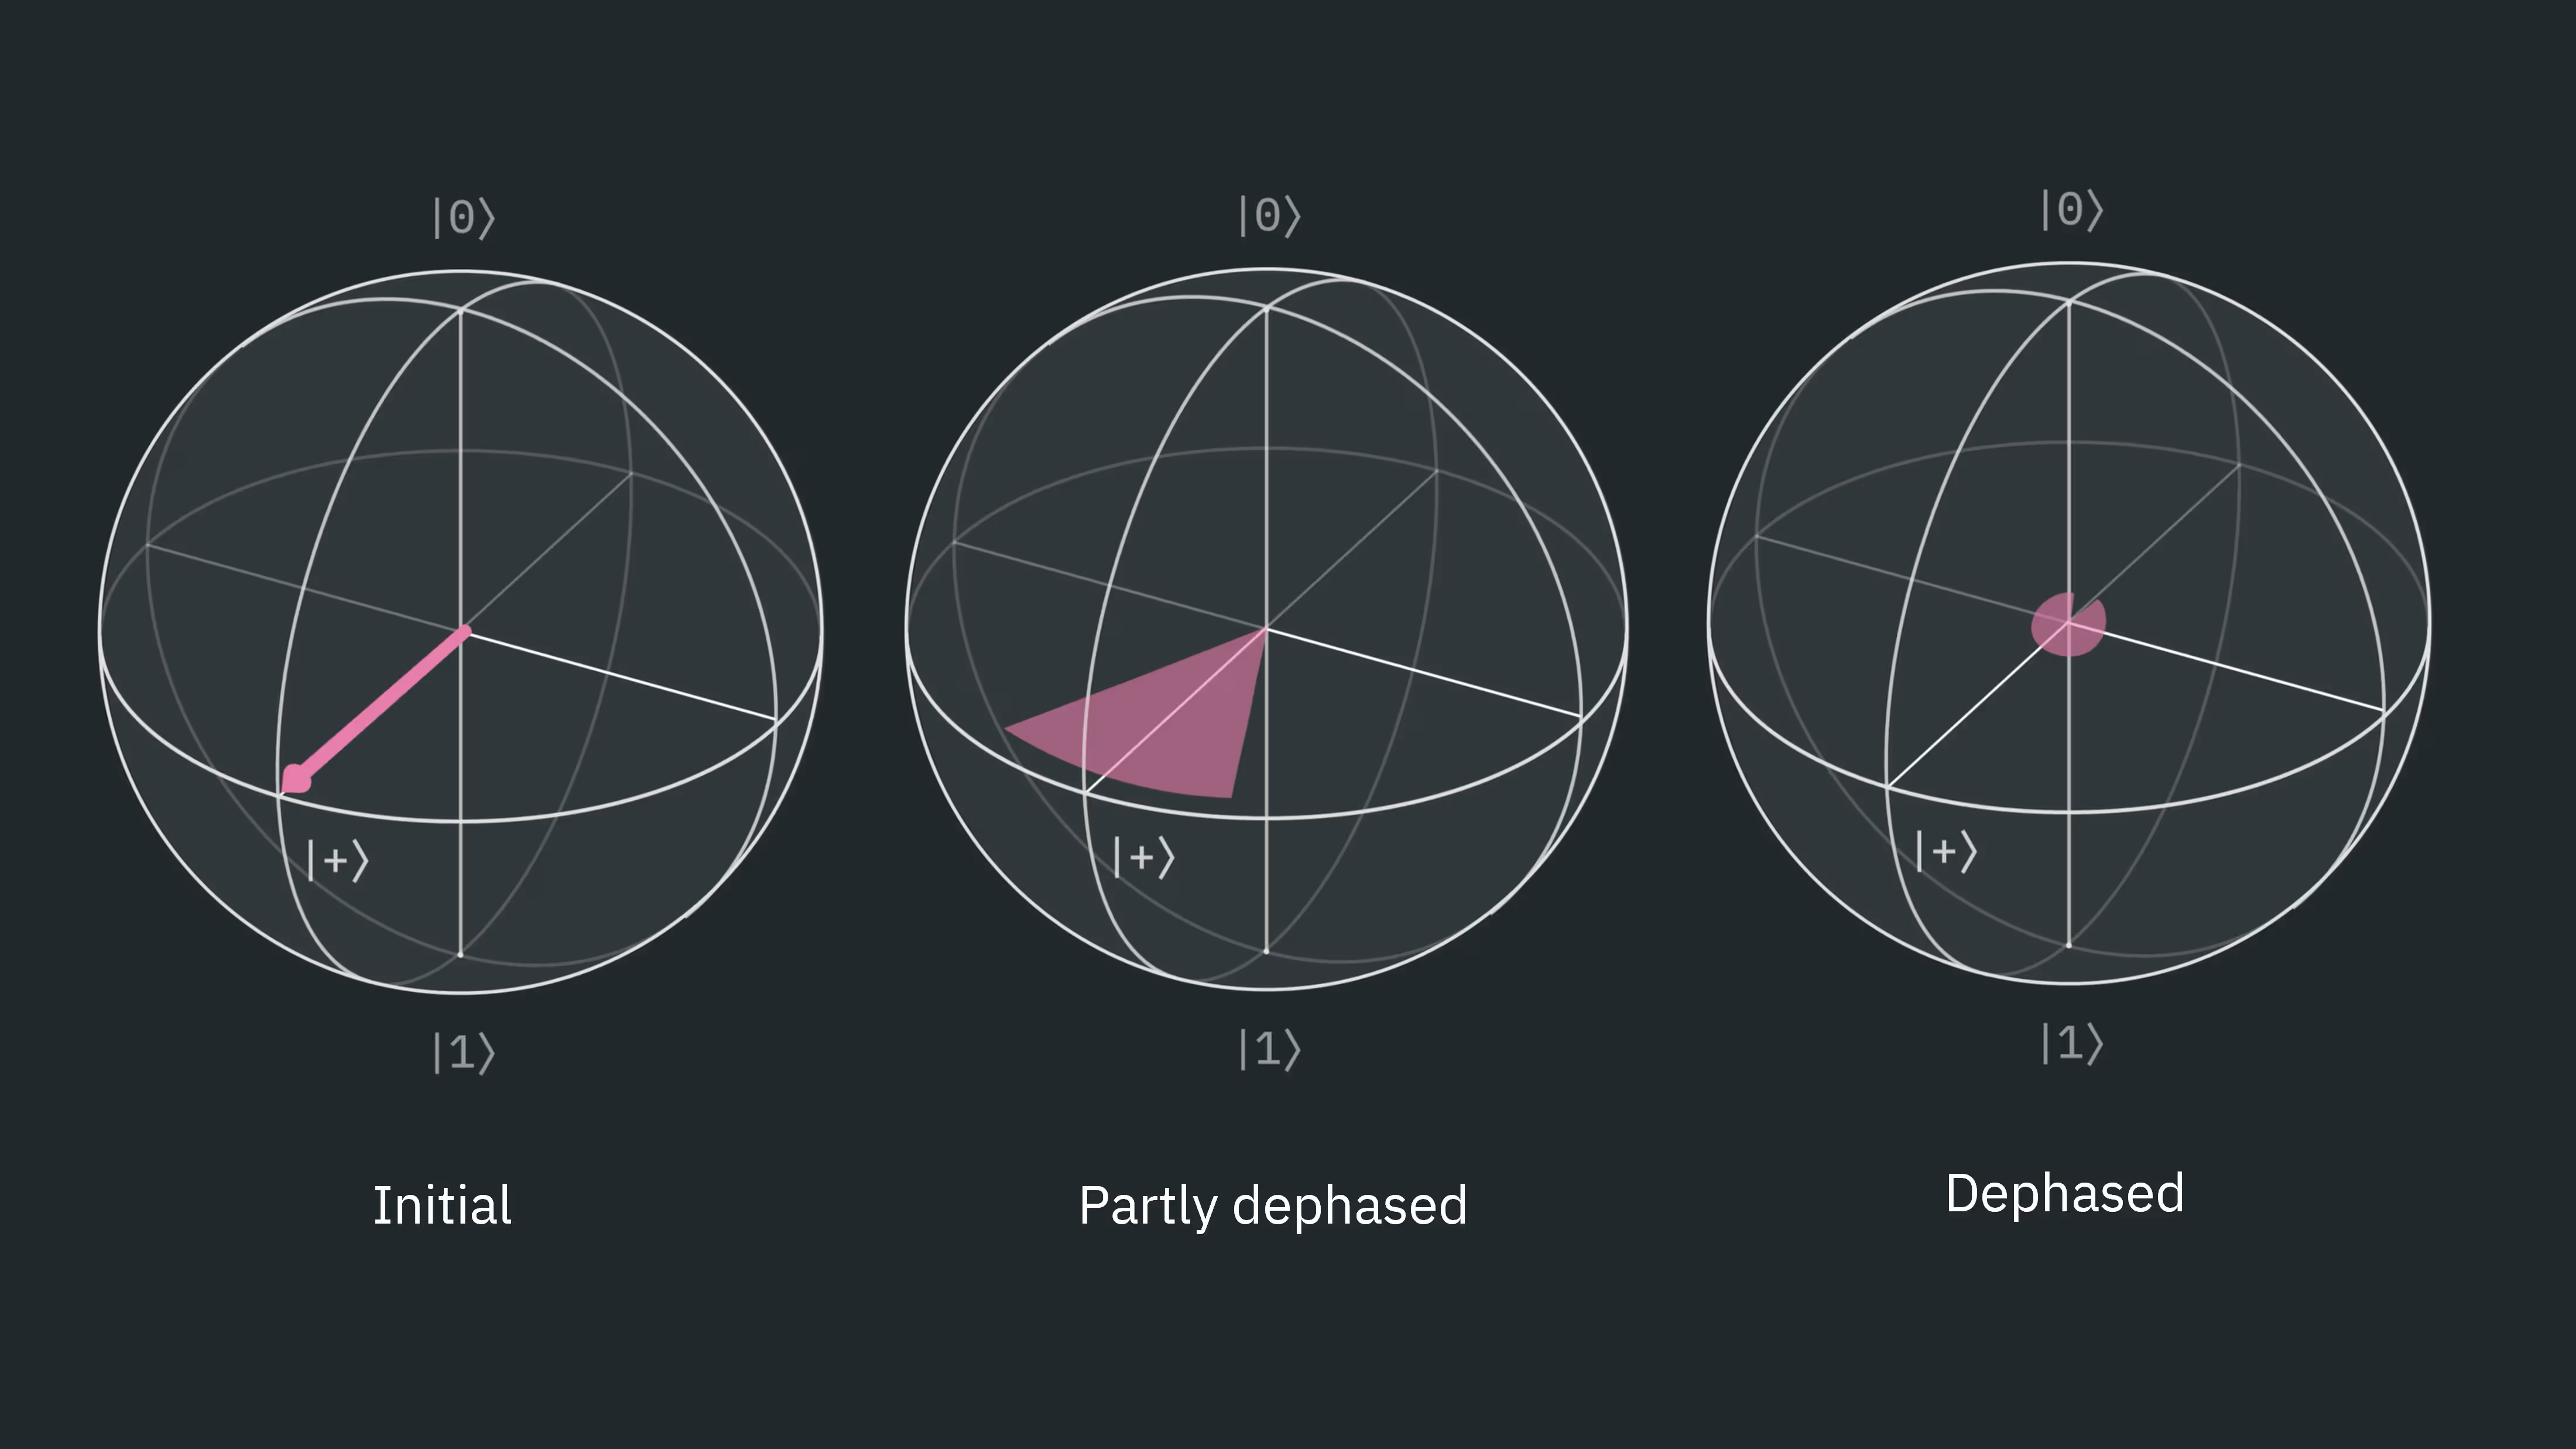
Bien sûr, dans une expérience, nous n'avons aucune idée du couplage aléatoire qui se produira. Que pouvons-nous faire à ce sujet ?
Supposons que le couplage environnemental reste approximativement constant sur un intervalle de temps . Considérons ce qui se passerait si nous suivions cette prescription :
-
Laisser la phase changer pendant un temps
-
Appliquer une porte X au qubit
-
Laisser le même couplage environnemental se produire pendant un temps supplémentaire
-
Appliquer une deuxième porte X
Après l'évolution temporelle initiale, nous aurions exactement l'état ci-dessus. En appliquant la première porte X, nous avons :
Maintenant, lorsque le deuxième intervalle de s'écoule, la même interaction se produit. Mais maintenant les amplitudes sont associées aux états propres Z opposés, ce qui signifie que le signe de la rotation autour de l'axe Z s'est inversé. Après avoir laissé le système évoluer pendant un autre , nous avons l'état :
Et en insérant , nous avons :
Appliquer la porte X finale ne change rien dans ce cas, mais c'est généralement nécessaire :
Nous avons récupéré l'état quantique original, y compris sa phase relative. Ce processus est un exemple particulièrement simple de découplage dynamique.
Plus généralement, le découplage dynamique (DD) consiste à insérer certaines portes à un qubit pour réduire l'effet des interactions avec des systèmes extérieurs au qubit (le découplant de l'environnement). Le refocalisage complet de tous les historiques de phase possibles vers l'état original, comme montré ci-dessus, est quelque peu idéalisé, mais reste un scénario possible. Discutons de quand le DD est utile et des mises en garde qui existent.
Vérifie ta compréhension
Dans le texte ci-dessus, nous avons détaillé étape par étape l'effet d'une séquence DD XX sur l'état initial . Vérifie si les mêmes étapes ci-dessus ramènent également l'état à son état initial sous les mêmes hypothèses d'un champ magnétique variant lentement le long de la direction z.
Réponse
Après l'évolution temporelle initiale, nous aurions exactement l'état ci-dessus. En appliquant la première porte X, nous avons :
Maintenant, lorsque le deuxième intervalle de s'écoule, la même interaction se produit. Mais maintenant les amplitudes sont associées aux états propres Z opposés, ce qui signifie que le signe de la rotation autour de l'axe Z s'est inversé. Après avoir laissé le système évoluer pendant un autre , nous avons l'état :
Et en insérant , nous avons
En appliquant la porte X finale, nous avons :
Quand utiliser le DD
La première mise en garde, et la plus évidente, est que nous avons supposé un canal purement de déphasage dans notre traitement. Les interactions du monde réel produisent généralement un mélange de déphasage et d'autres mécanismes d'erreur. Dans le traitement ci-dessus, nous avons choisi d'appliquer spécifiquement des portes X. C'est ce qu'on appelle une séquence XX en découplage dynamique. Cette séquence particulière convient aux erreurs purement de déphasage. Mais il existe d'autres séquences qui pourraient être plus largement applicables, comme XY4 (montrée dans le diagramme de circuit ci-dessous) et le XY8 plus complexe.

Une autre mise en garde est que le découplage dynamique ajoute des portes à un qubit, ce qui peut ajouter des erreurs sur un seul qubit dues à des imperfections de porte ou même à de la diaphonie (crosstalk). Ces taux d'erreur sur un seul qubit sont généralement bien inférieurs aux erreurs des portes multi-qubits, donc ce n'est généralement pas une préoccupation majeure, mais c'est quelque chose à garder à l'esprit si de nombreux qubits utilisent le DD de nombreuses fois tout au long de ton circuit.
Le DD est utile lorsque le couplage externe a le temps d'affecter l'état du qubit. Comme les qubits sont soigneusement bien isolés et que les couplages externes devraient être faibles, ce type de bruit est le plus perceptible lorsqu'un qubit reste inactif pendant de longues périodes. Pour de courtes durées d'inactivité, l'effet du DD pourrait être d'ajouter des erreurs de porte à un seul qubit tout en supprimant très peu de bruit ; la fidélité de ton circuit pourrait en réalité être réduite.
À retenir : utilise le découplage dynamique lorsque les qubits restent inactifs pendant des périodes suffisamment longues, et fais attention au type de séquence DD utilisée.
Découplage dynamique avec Qiskit
Explorons l'utilisation du DD en examinant le cas de plusieurs qubits préparés dans l'état , qui restent ensuite inactifs pendant longtemps. En l'absence d'erreurs, préparer l'état multi-qubit puis appliquer une porte de Hadamard avant la mesure (mesurant ainsi dans la base X) devrait toujours donner 0. Avec du bruit, le résultat de la mesure ne sera 0 qu'une fraction du temps plutôt qu'avec une probabilité de 100 %. Nous calculons la valeur moyenne d'espérance de X sur plusieurs qubits. C'est-à-dire que nous nous intéressons à ce qui suit :
où avec l'opérateur X à la position en partant de la droite et est l'état du système entier.
Ce circuit contient des délais intentionnels, ce qui est quelque peu artificiel pour un benchmark. Cependant, il est très courant que des circuits réels contiennent des qubits qui restent inactifs pendant une partie de l'exécution. Tu peux considérer cela comme un modèle simplifié d'un circuit plus complexe dans lequel certains qubits restent inactifs pendant une partie du calcul. Ce type de benchmarking basé sur l'évolution des états est souvent appelé benchmarking de Ramsey.
Nous commençons par charger les paquets nécessaires et configurer le service.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
Nous définissons maintenant quelques fonctions d'assistance. Tout d'abord, nous voulons aborder le point sur les longues durées d'inactivité. Que signifie exactement « long » dans ce contexte ? Nous pourrions simplement indiquer la durée d'inactivité en microsecondes. Cependant, il est utile de savoir combien de portes à deux qubits pourraient être exécutées pendant cet intervalle. Cela rend les durées d'inactivité plus directement représentatives de la profondeur de circuit qui aurait pu être exécutée pendant la même période. La première fonction d'assistance récupère la porte à deux qubits native du backend et détermine la durée de cette porte.
La deuxième fonction crée simplement un circuit de Ramsey (avec des qubits dans l'état ), met en œuvre un délai, effectue une rotation à l'aide d'une porte H, puis mesure. Rappelle-toi qu'une porte de Hadamard (H) fait correspondre à , donc mesurer dans la base Z après la porte de Hadamard correspond au fait que le qubit était dans juste avant la porte de Hadamard.
Notre dernière fonction convertit les décomptes bruts des résultats de mesure 0 et 1 en une valeur d'espérance de X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
Nous précisons maintenant les détails de notre test, y compris le nombre de qubits et la séquence de portes à utiliser dans le DD (dans ce cas XX). Note en particulier que nous fixons le niveau d'optimisation à zéro. En pratique, tu choisirais souvent un niveau d'optimisation plus élevé ; ici nous utilisons le niveau 0 pour garantir que les effets des erreurs ciblées par le DD restent visibles. Enfin, nous déterminons le temps caractéristique des portes à deux qubits sur ce backend et affichons quelques durées pertinentes.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
Nous construisons maintenant nos circuits et les transpilons pour le backend choisi.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
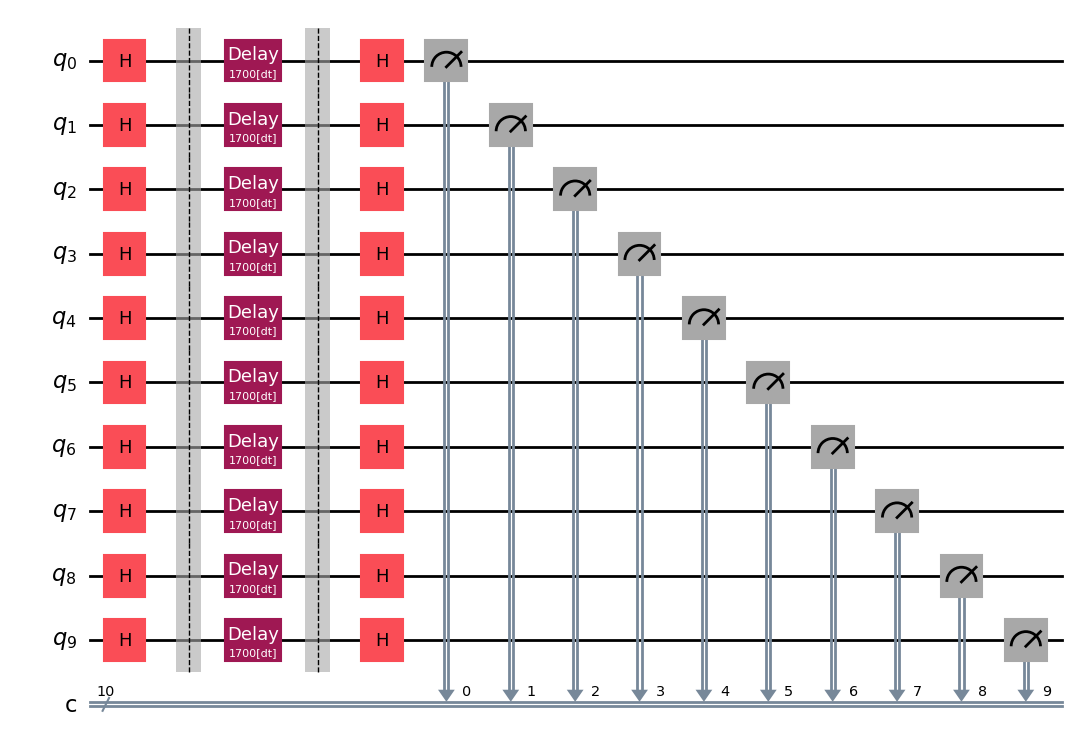
Nous devrions visualiser au moins un circuit pour vérifier que nous avons codé notre circuit avec les états et délais souhaités. Il pourrait être plus facile de visualiser le circuit pré-transpilé qc, ou tu pourrais vérifier le circuit transpilé qc_isa.
qc.draw("mpl")
Exécuter
Nous sommes enfin prêts à exécuter sur le matériel. Nous utilisons Sampler pour obtenir de nombreuses mesures de chaque qubit, et nous l'utiliserons deux fois : une fois avec le DD explicitement désactivé, et une fois avec le DD activé et en utilisant la séquence de portes XX.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
Nous pouvons extraire les décomptes des différents circuits.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
Post-traitement
Nous avons maintenant les décomptes issus de la mesure, mais nous voulons les transformer en valeur d'espérance de X, puis moyenner ces valeurs d'espérance sur tous les qubits que nous avons utilisés, afin de connaître la préservation de l'information de phase. Pour cela, nous utilisons notre fonction counts_to_x_expectations définie précédemment.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
Enfin, traçons nos résultats.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
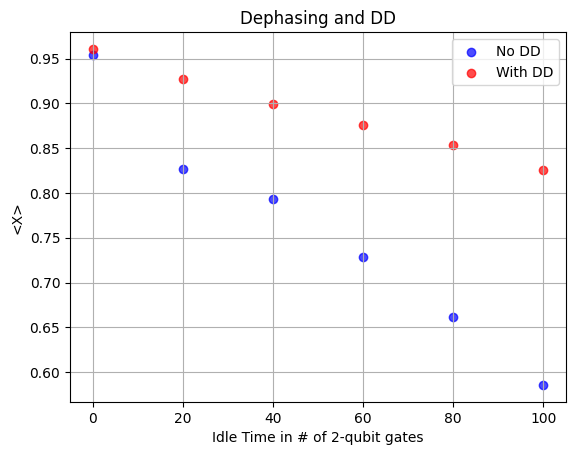
Comme tu peux le voir, sans délai explicite, les valeurs d'espérance sont effectivement proches de 1, ce à quoi on s'attendrait si toute l'information de phase était préservée. Si toute l'information de phase était perdue, il n'y aurait aucune préférence pour que la rotation finale produise plutôt que , et la valeur d'espérance moyenne s'approcherait de zéro. Dans les données, nous voyons qu'à mesure que les temps de délai augmentent, la valeur d'espérance moyenne de X diminue, commençant à approcher zéro. Note que le DD a été très efficace ici ; les valeurs d'espérance avec DD sont généralement plus de 20 % meilleures (plus proches de 1) que les valeurs sans DD. Mais note également que le premier point de données retardé correspond à un délai à peu près équivalent à 100 opérations de porte à deux qubits. Cela renforce l'idée que le DD est le plus utile lorsque les qubits restent inactifs pendant des périodes relativement longues.
Vérifie ta compréhension
Si nous appliquons le DD en utilisant XY4 au même circuit qu'auparavant, t'attends-tu à ce qu'il donne des résultats bien meilleurs, bien pires, ou à peu près les mêmes, que le DD utilisant XX ? Explique.
Réponse
À peu près la même chose, peut-être légèrement pire. Le circuit que nous avons utilisé avait des états tournés dans le plan XY. Cet état stocke l'information principalement dans sa phase, ce qui le rend particulièrement sensible aux erreurs de déphasage plutôt qu'à la relaxation T1. XY4 pourrait aider avec une plus grande variété d'erreurs, mais XX est déjà optimisé pour aider le circuit que nous utilisons. XY4 pourrait être tout aussi bon, mais n'apporterait rien de substantiel, ou le fait que XY4 contienne plus de portes pourrait permettre à des erreurs de porte supplémentaires de rendre les résultats légèrement pires.
Le dernier résultat utilisait la séquence de portes DD la plus simple XX. Voyons comment implémenter une séquence plus complexe, XY4. Nous définissons un Sampler dans la section suivante.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
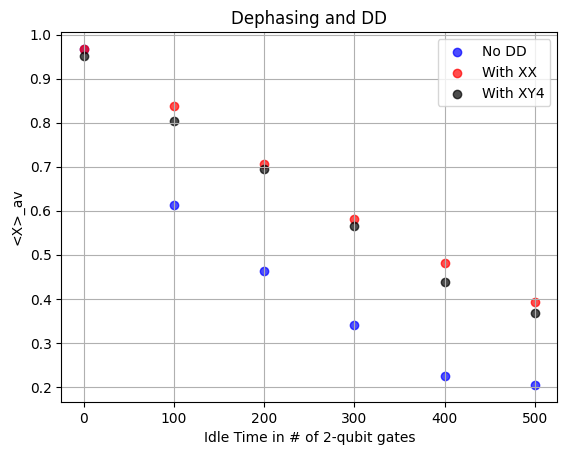
Nous voyons ici que XY4 n'est pas sensiblement différent de XX. Cela pourrait être très légèrement pire en raison des portes supplémentaires dans la séquence XY4, mais plus important encore, nous avons déjà expliqué pourquoi XX aurait l'effet souhaité pour préserver la phase spécifiquement pour un état comme . Il n'y a aucune raison de penser que pour un tel état initial, une séquence différente améliorerait les résultats.
Vérifie ta compréhension
Vérifie que la séquence XY4 laisse l'état inchangé à une phase globale près.
Réponse
Pauli twirling
Il convient de commencer par noter que le Pauli twirling est souvent utilisé non pas comme une technique de suppression d'erreurs, mais comme une technique de mise en forme des erreurs : il fait en sorte que le bruit/les erreurs se comportent différemment, parfois de manière plus prévisible, pour permettre d'autres méthodes. Bien que le Pauli twirling ne prévienne pas les erreurs, il peut empêcher leur accumulation cohérente.
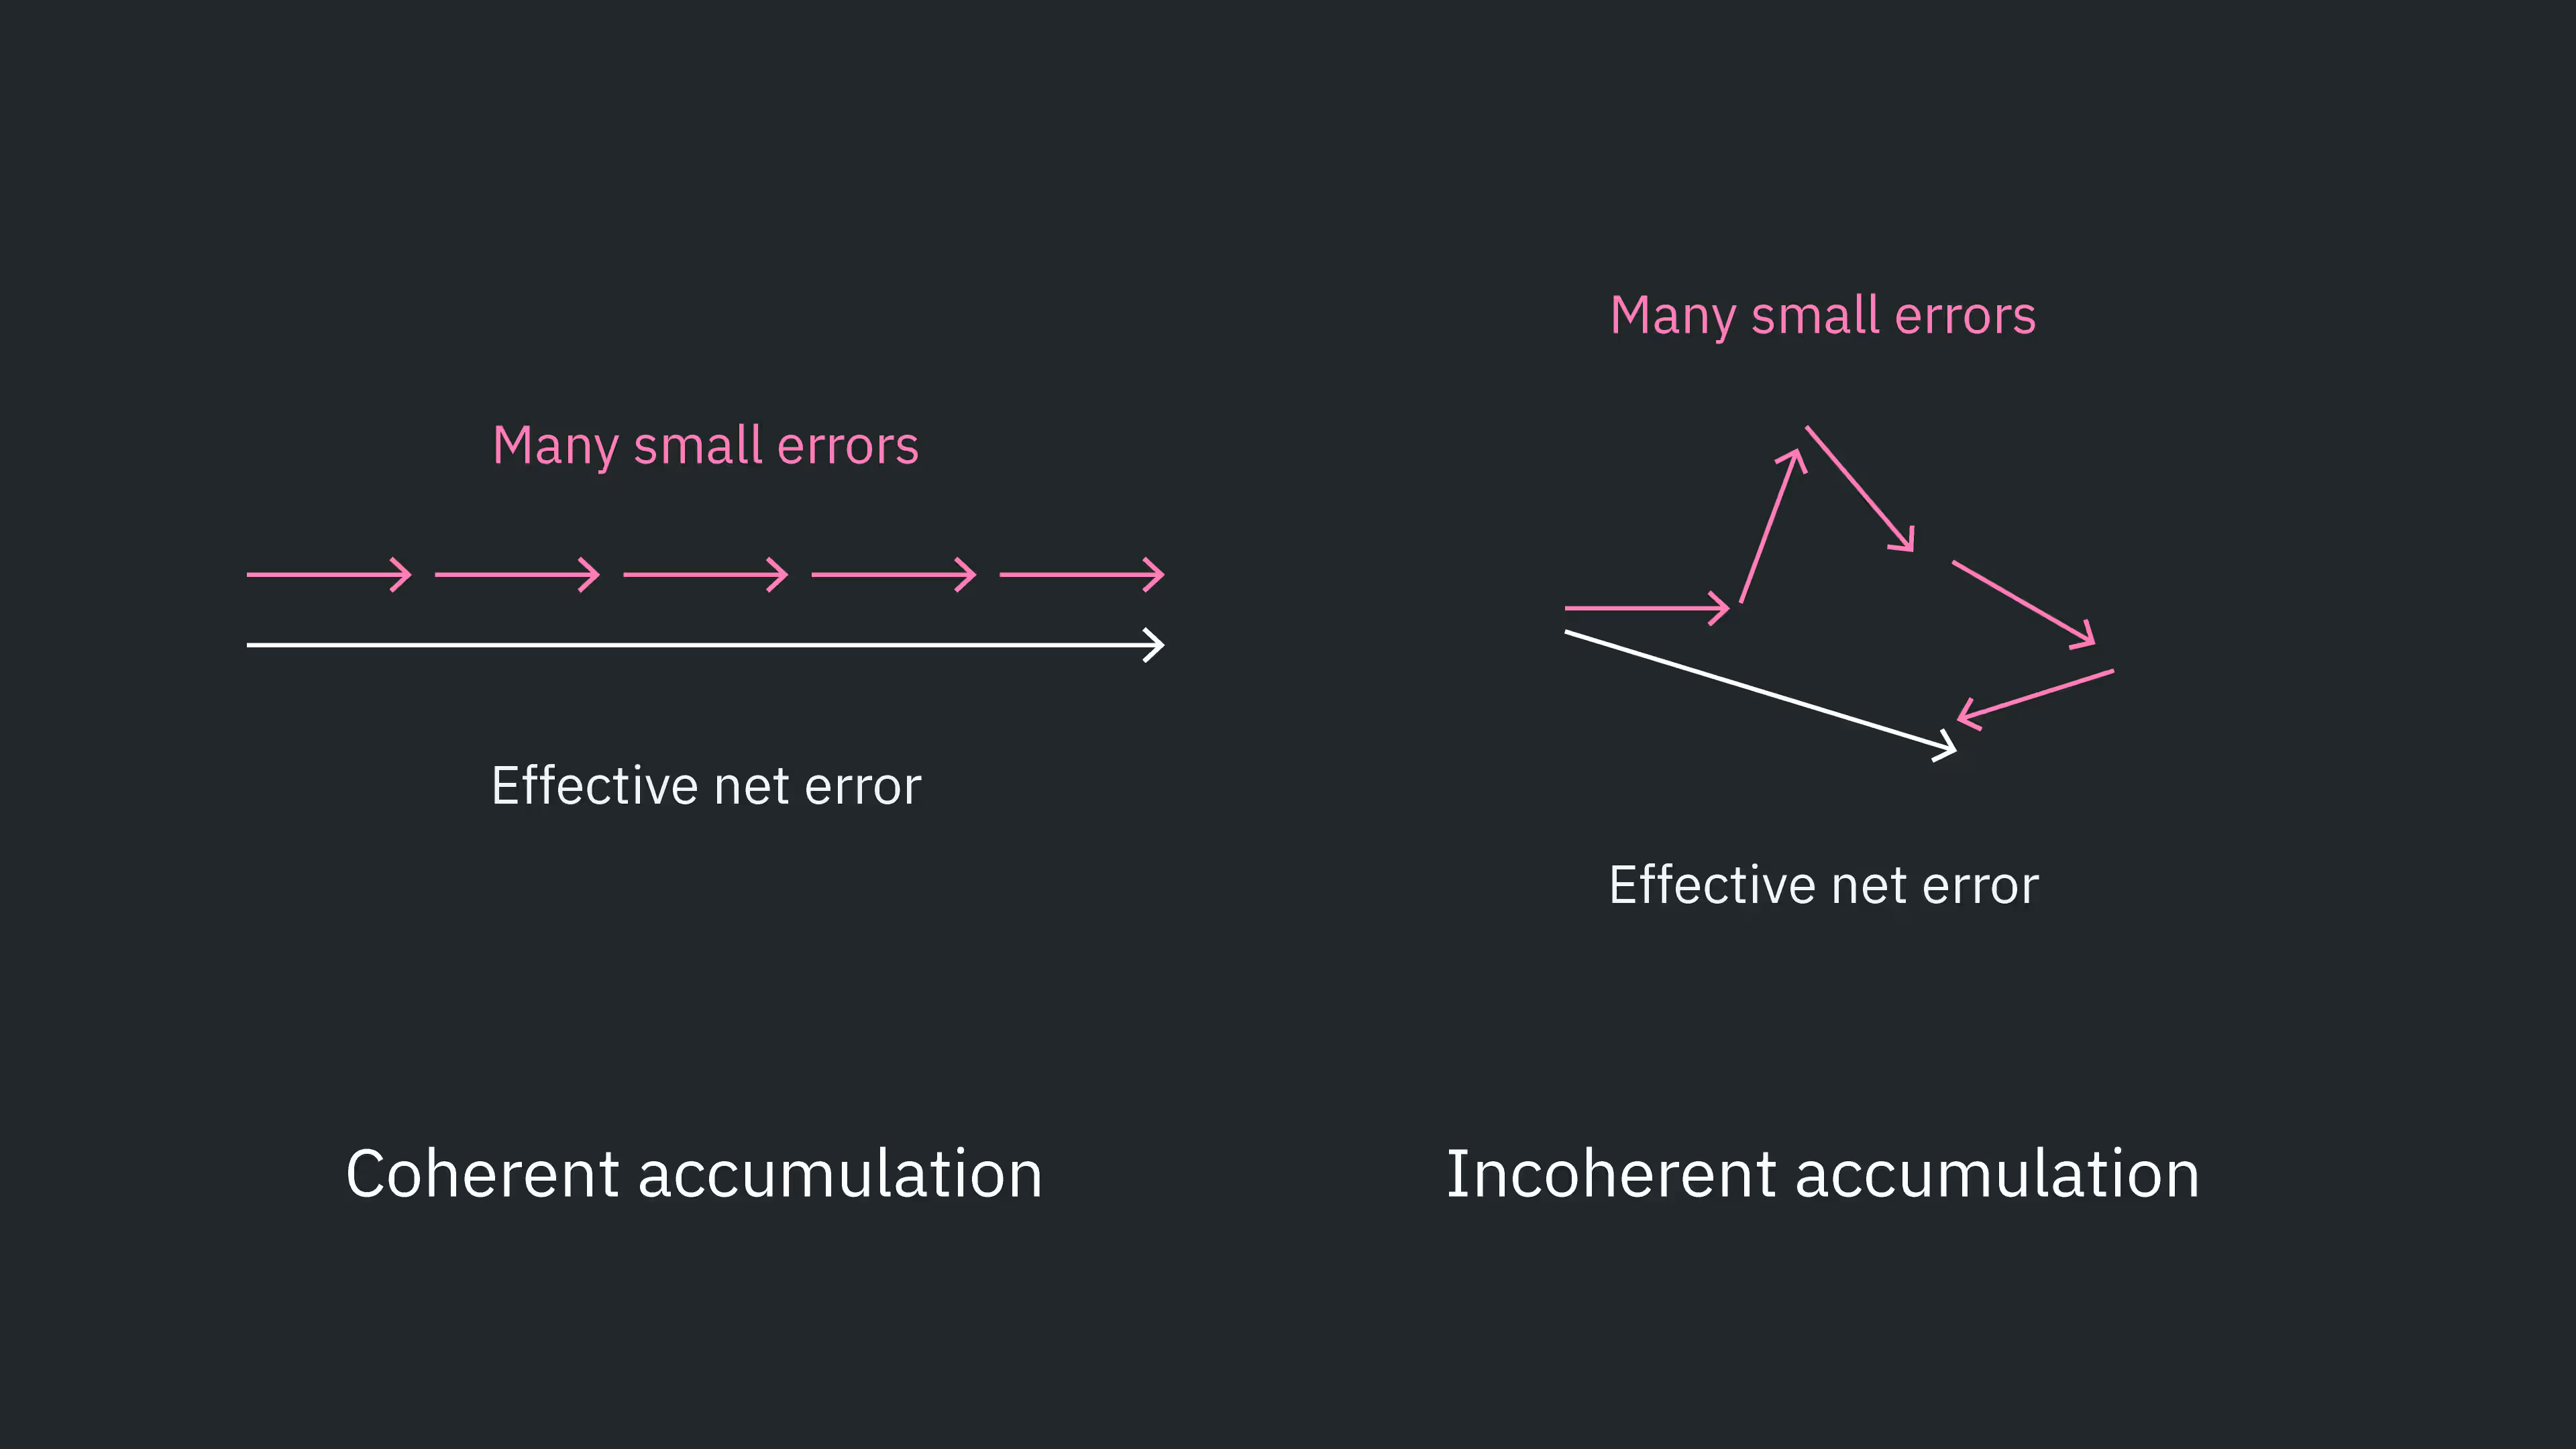
Dans un circuit quantique, plusieurs sources d'erreur différentes s'additionnent. Les erreurs peuvent s'additionner de différentes manières, notamment de façon cohérente et incohérente. L'accumulation cohérente d'erreurs signifie que le bruit ou les implémentations imparfaites tendent tous à pousser les erreurs dans la même direction à travers plusieurs couches et portes. Un exemple serait une sur-rotation cohérente lors de l'application d'une porte de rotation.
Considère une porte de rotation idéale, telle que , qui effectue une rotation autour de l'axe X d'exactement . Bien sûr, l'implémentation de la porte n'est pas parfaite, et la rotation réelle pourrait être pour une implémentation, et il pourrait même arriver que soit toujours du même signe, et possiblement de magnitude similaire à travers de nombreuses applications de . Ainsi, l'application répétée de portes de rotation peut entraîner une accumulation cohérente de ces nombreuses sur-rotations (ou sous-rotations), .
L'accumulation d'erreurs incohérente est exactement l'inverse : des erreurs dans des directions aléatoires avec des signes aléatoires, de sorte que les erreurs dans différentes couches n'interfèrent pas toujours de manière additive, mais s'annulent ou s'additionnent parfois en quadrature. Il est clair que les erreurs incohérentes s'accumulent plus lentement en termes d'effet global sur l'état du qubit. Un schéma simplifié de cela est montré dans la figure ci-dessous. Il s'agit d'une simplification. Les erreurs quantiques réelles ne sont pas limitées à un espace cartésien à deux dimensions ; toutes les contributions d'erreur n'auront pas la même magnitude, et il existe davantage de complexités. Mais l'intuition d'une image comme celle-ci est utile : les erreurs cohérentes ont tendance à s'accumuler plus rapidement que les incohérentes.
On peut souvent obtenir des résultats de fidélité plus élevée en transformant l'accumulation cohérente d'erreurs en accumulation incohérente d'erreurs. Une façon principale d'y parvenir est appelée Pauli twirling.
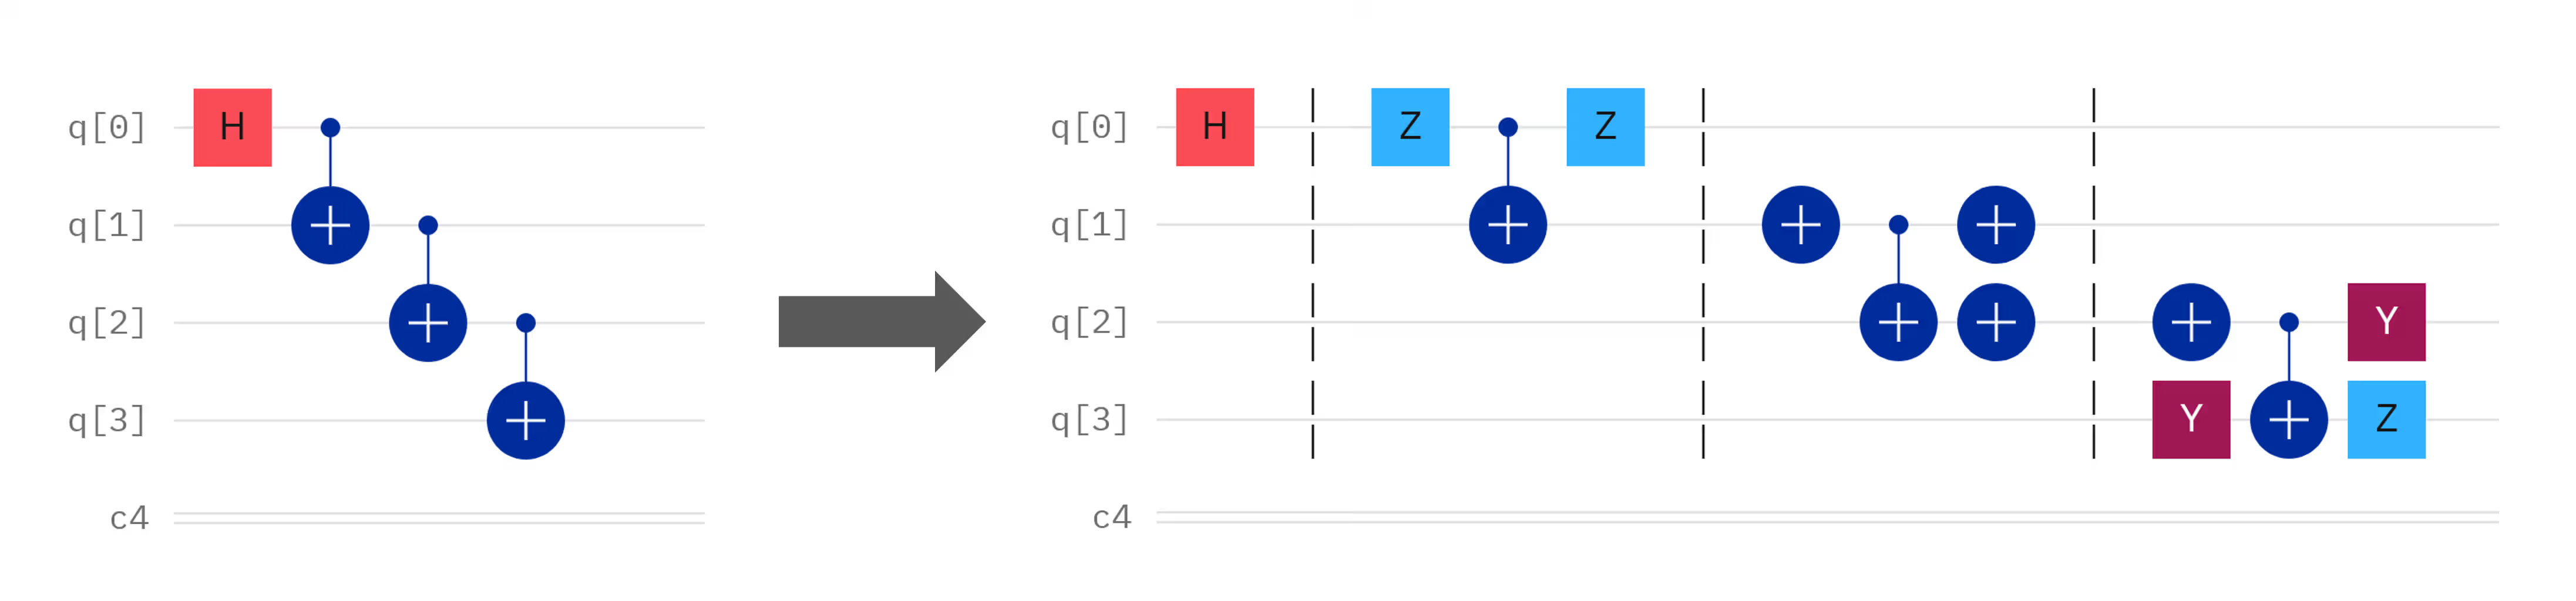
Le Pauli twirling consiste à ajouter des combinaisons de portes de Pauli avant et après une opération de porte souhaitée de telle sorte que . Ici, et ne sont pas de simples Pauli isolées, mais des ensembles d'opérateurs de Pauli agissant souvent sur plusieurs qubits. Tu pourrais parfois lire que l'action des portes de Pauli supplémentaires est « équivalente à l'identité ». Mais c'est imprécis et potentiellement source de confusion. Les portes de Pauli sont séparées par et l'objectif est de laisser l'action logique de toutes les portes égale à . Parfois est appelé la « charge utile » (payload) pour distinguer cette opération voulue des portes ajoutées pour la suppression. Quelques exemples de Pauli twirling autour d'une porte CNOT sont présentés ci-dessous.

Parcourons un seul exemple pour vérifier que le twirling laisse l'effet logique de la charge utile inchangé. Sans perte de généralité, soient les états à deux qubits impliquant et :
Comme toujours, nous utilisons la convention d'ordre des qubits . En appliquant une porte CX avec comme cible, on obtient
Considérons maintenant le troisième circuit montré, utilisant des portes X pour le Pauli twirling. Nous pourrions simplement multiplier les matrices ensemble et vérifier qu'elles donnent une matrice CNOT. Alternativement, nous pouvons suivre l'opération sur un état quantique arbitraire à travers le circuit, comme nous le faisons ci-dessous. Les états aux différents points du circuit ont été étiquetés a-d.

C'est exactement que nous avons obtenu précédemment sans twirling. En effet, cette séquence de portes twirlées laisse l'action logique de la charge utile inchangée. Cependant, si différentes séquences de twirling valides sont sélectionnées aléatoirement d'une couche à l'autre, l'accumulation cohérente d'erreurs peut être convertie en accumulation d'erreurs effectivement stochastique (incohérente). Pour être clair, on ne choisit pas un seul motif de twirling et on ne l'utilise pas tout au long du circuit. Au lieu de cela, différentes séquences de twirling valides sont sélectionnées pour différentes couches. Un exemple avec de nombreuses couches intriquées pourrait ressembler à ceci.
Vérifie ta compréhension
Vérifie que le Pauli twirling dans le quatrième panneau de la figure ci-dessus laisse également l'effet logique du CNOT inchangé.
Réponse
Nous suivons l'exemple ci-dessus et montrons que l'action sur tout état arbitraire à deux qubits est équivalente à une opération CNOT. Nous ferons référence aux points étiquetés dans ce diagramme.

Ceci est équivalent à l'action d'un CNOT avec le qubit 0 comme contrôle et le qubit 1 comme cible.
Peux-tu trouver une séquence de Pauli twirling pour la porte CNOT qui n'est pas montrée ci-dessus ?
Réponse
Oui, il en existe beaucoup d'autres. Un exemple est avant le CNOT, et un et après le CNOT.
Quand utiliser le Pauli twirling
Tel que présenté ici, le Pauli twirling n'est appliqué qu'aux portes multi-qubits. Appliquer un protocole similaire aux portes à un seul qubit nécessiterait une logique différente et n'est généralement pas utile en pratique. Le Pauli twirling lui-même utilise plusieurs portes à un seul qubit (les portes de Pauli). Les portes de Pauli supplémentaires introduiraient probablement plus d'erreurs qu'elles n'en gagneraient en randomisant toute accumulation d'erreur cohérente. Les taux d'erreur associés aux portes à deux qubits sont beaucoup plus élevés que ceux associés aux portes à un seul qubit. De plus, certaines portes à un seul qubit sont non-Clifford, ce qui ne peut pas être entièrement twirlé. C'est pourquoi Qiskit inclut des options de Pauli twirling qui twirlent automatiquement autour des portes à deux qubits, et non autour des portes à un seul qubit.
Cela était implicite dans la figure ci-dessus : le Pauli twirling a été implémenté autour des portes CX, mais pas autour de la porte de Hadamard.
Voyons deux exemples de Pauli twirling en action.
Pauli twirling pour supprimer l'accumulation cohérente
Pour observer comment le Pauli twirling peut transformer l'accumulation cohérente d'erreurs en une accumulation incohérente plus lente, nous voulons un circuit et une observable qui fonctionnent comme un test de résistance aux erreurs cohérentes. Le seul objectif est de rendre visibles les erreurs à deux qubits s'accumulant de manière cohérente, puis de montrer comment le Pauli twirling convertit cette accumulation cohérente en décroissance stochastique.
Les portes CNOT (ou CZ) sont une source courante d'erreurs cohérentes. L'expérience la plus simple que nous puissions faire dans ce cas est d'initialiser un état (disons ), d'appliquer des couches de paires de portes CNOT (en utilisant le fait que deux CNOT donnent une identité), et de vérifier comment les erreurs s'accumulent à mesure que le nombre de couches augmente, à la fois avec et sans Pauli twirling.
L'observable d'intérêt est sur un seul qubit, que nous traçons en fonction du nombre de répétitions de paires de CNOT.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
Comme nous avons fait tourner notre base avant les mesures, une mesure de correspond au fait que l'état était dans juste avant la porte de Hadamard finale, et de même pour et . Par conséquent, notre valeur d'espérance peut être simplement calculée à partir des décomptes de moins les décomptes de .
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
Nous sélectionnons un nombre raisonnable de couches de CNOT sur lesquelles laisser l'erreur s'accumuler, construisons nos circuits, puis les transpilons.
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
Garde à l'esprit que chaque couche consiste en plus d'une porte à deux qubits. Surveille la profondeur transpilée à deux qubits en utilisant la fonction ci-dessous.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Nous exécutons maintenant les jobs.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
Enfin, nous visualisons ces résultats.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
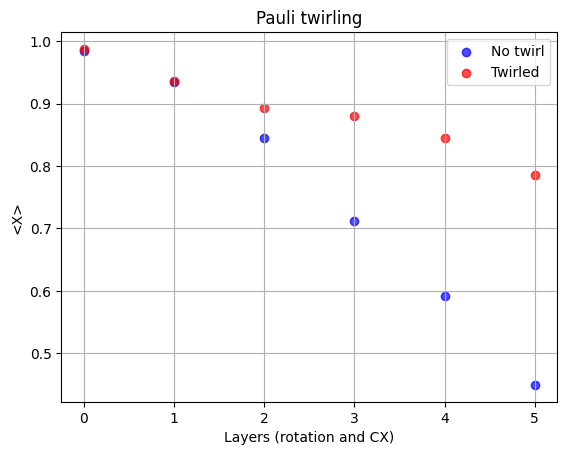
Nous pouvons clairement voir que le circuit twirlé donne une valeur d'espérance plus proche de l'idéal . Cet exemple a rempli son objectif, mais passons à quelque chose de plus utile : le twirling dans la production d'états hautement intriqués.
Pauli twirling dans la préparation d'état GHZ
L'exemple précédent a montré un cas convaincant pour le Pauli twirling en détruisant l'accumulation cohérente d'erreurs associées aux portes CNOT. La production d'états GHZ utilise de nombreuses portes CNOT pour produire des états hautement intriqués utiles pour de nombreuses applications de calcul quantique. Explorons comment le Pauli twirling aide dans ce contexte, avec des états GHZ de taille croissante.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
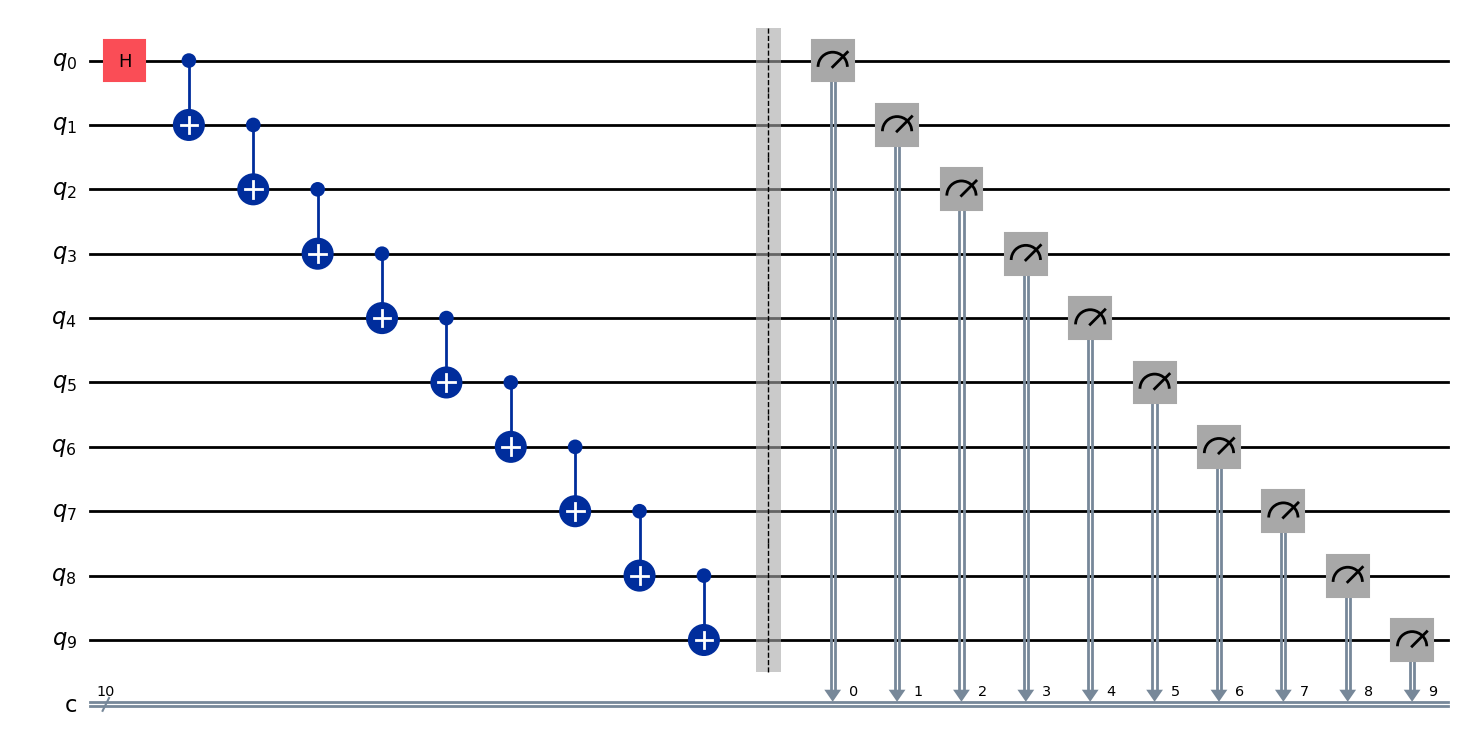
Nous construisons maintenant nos circuits et les transpilons. Dans ce cas, nous n'avons pas de portes artificiellement répétées qui se réduisent à l'identité. Nous pouvons donc laisser le pass manager faire un peu plus d'optimisation pour nous. Nous le réglerons au niveau trois.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
Nous pouvons voir que l'optimiseur a mappé notre circuit abstrait sur les qubits 123, 124, 136, 142 et 143.
circuits[0].draw("mpl")
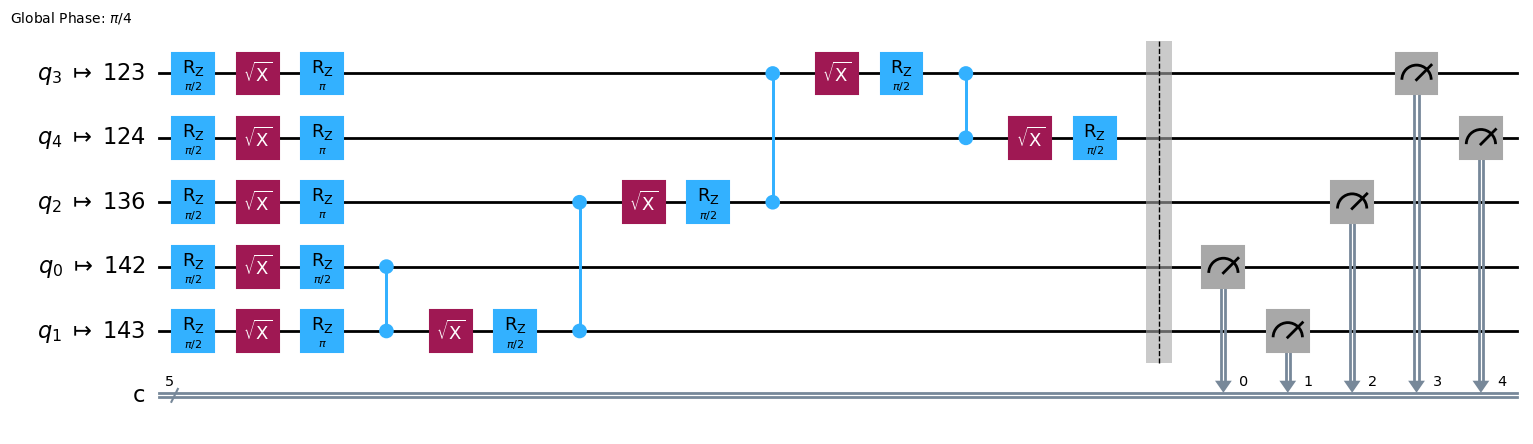
Pour comprendre pourquoi, regardons une carte de la disposition de notre backend (dans cette image, ibm_fez, mais tu peux effectuer des analyses équivalentes sur n'importe quel backend).
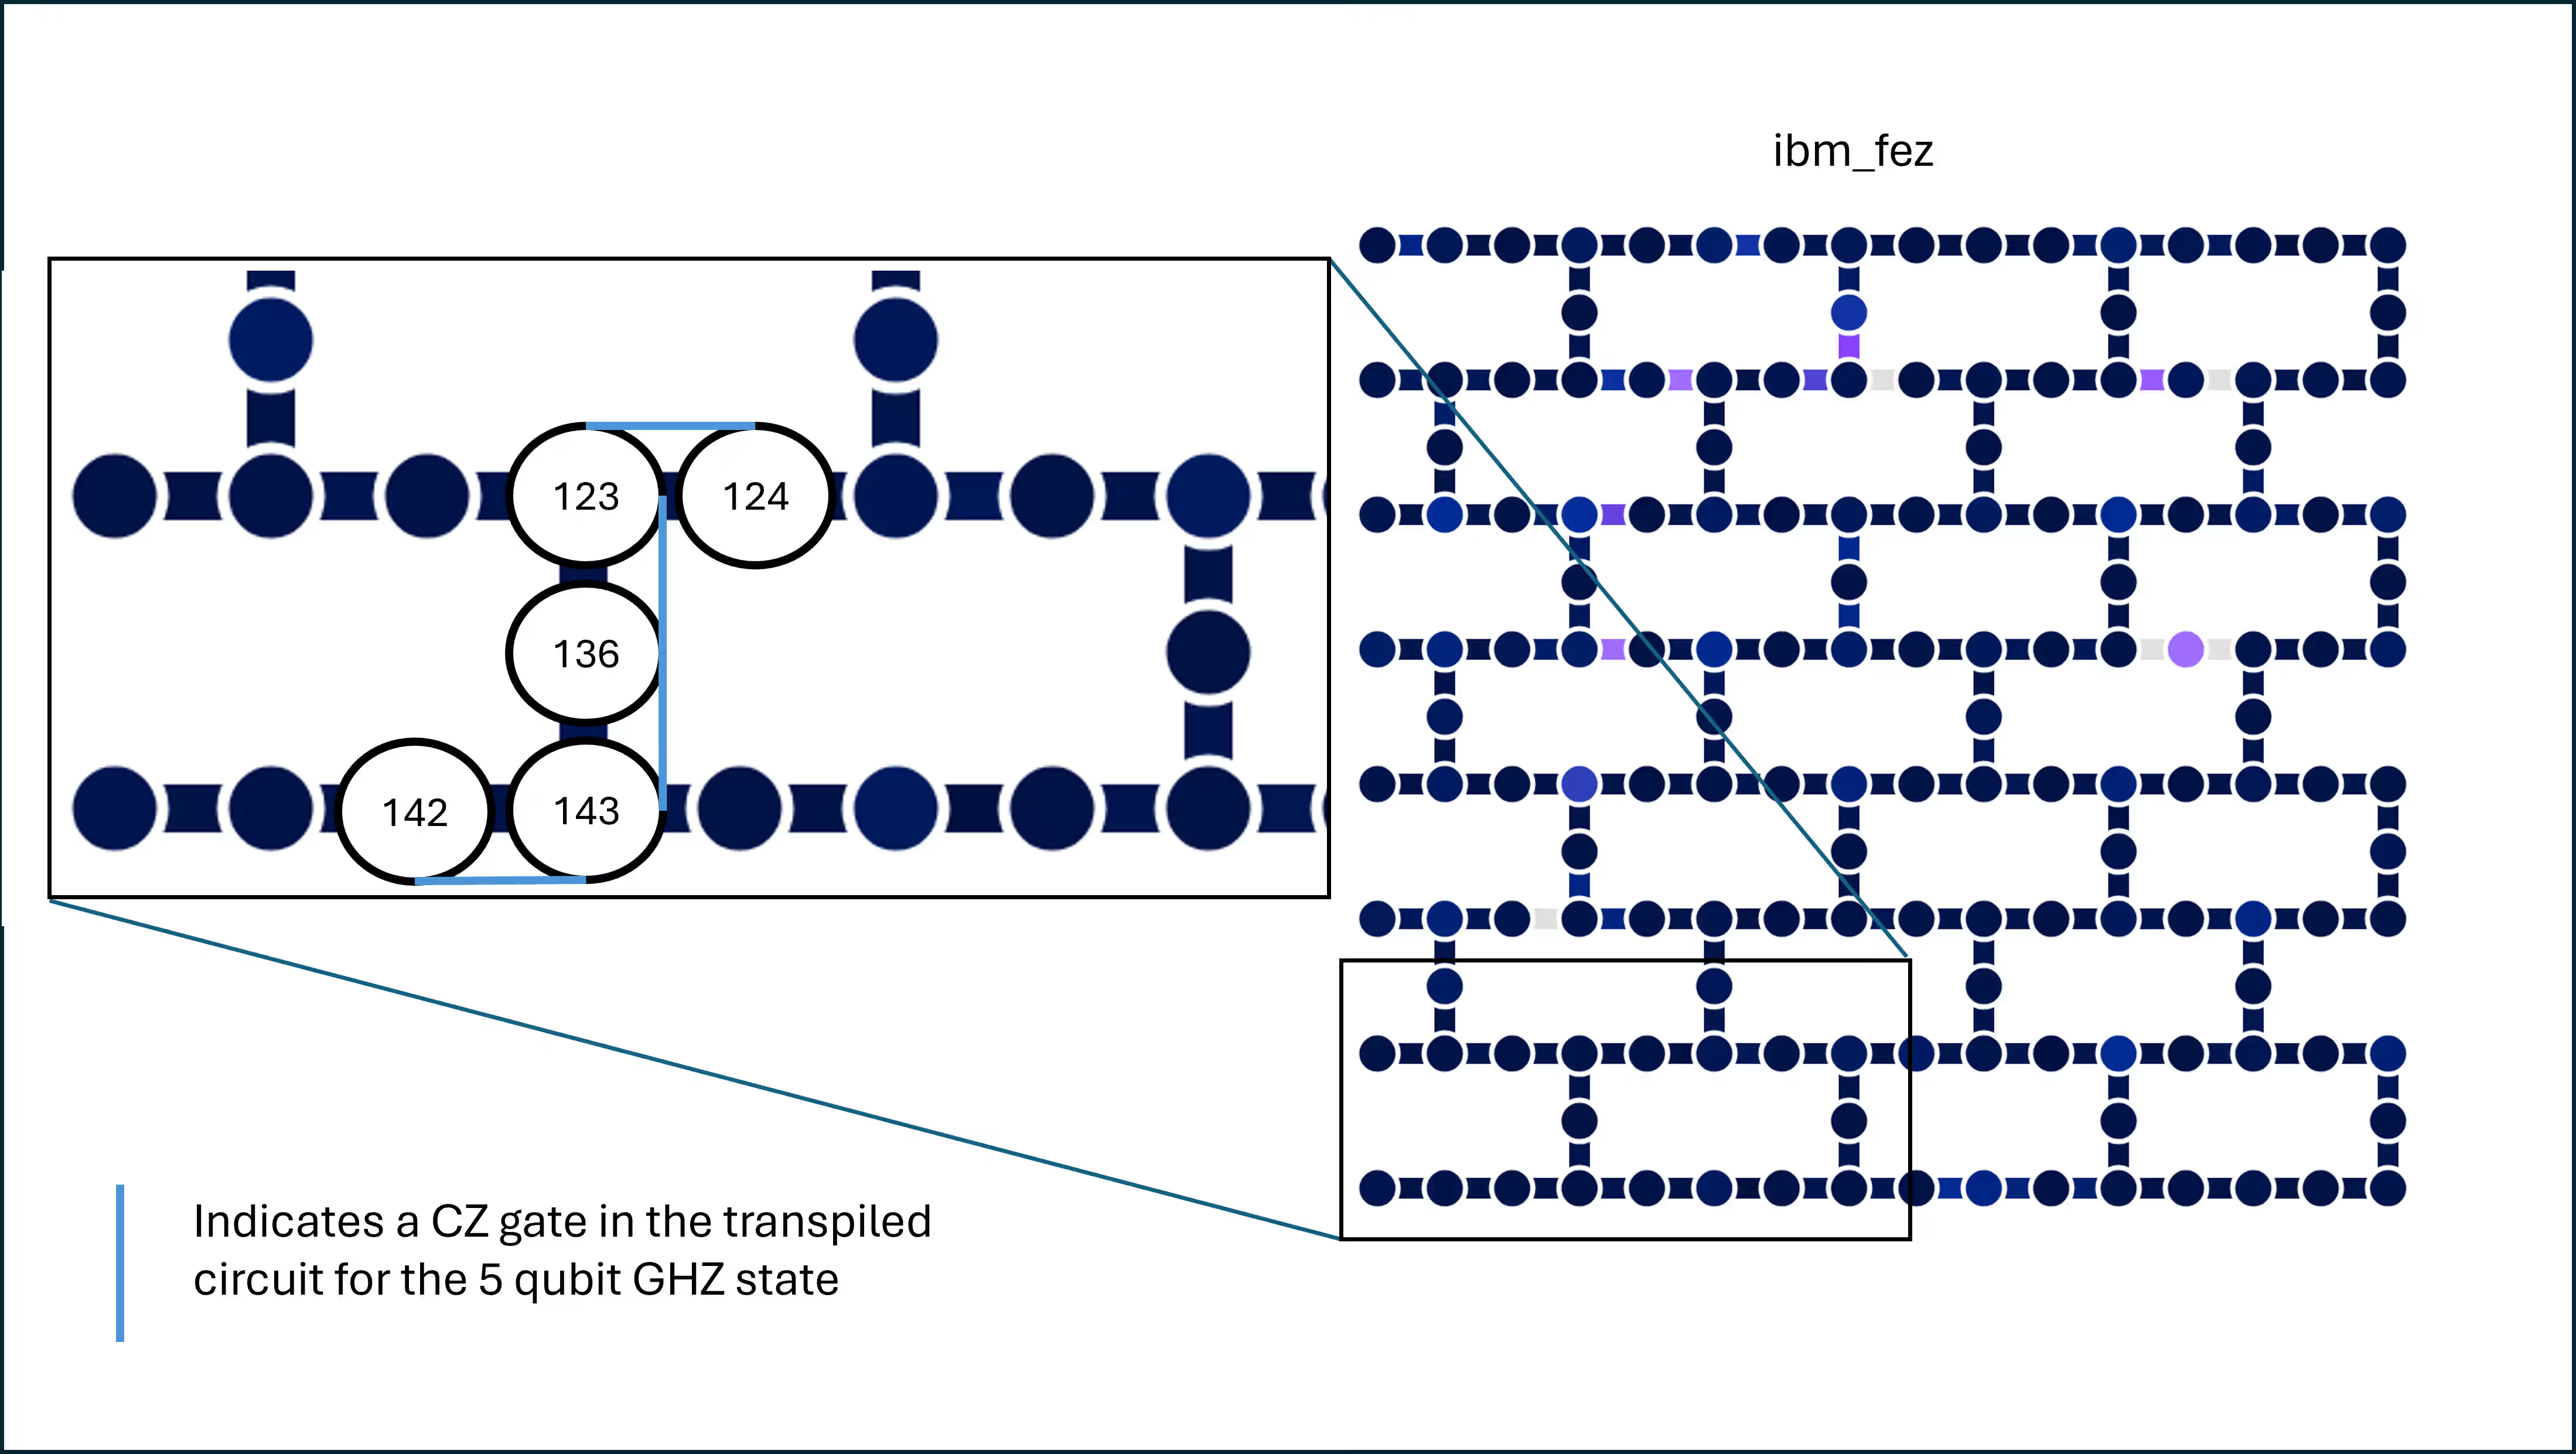
Nous voyons que les qubits ont été sélectionnés en chaîne pour minimiser les portes swap et donc la profondeur du circuit. De plus, chaque porte CZ implémentée dans le circuit est entre des qubits adjacents. Enfin, les cinq qubits ont tous des taux d'erreur relativement faibles, y compris les taux d'erreur d'assignation de lecture (readout). Tu peux vérifier ces taux d'erreur sur n'importe quel backend sur la page Ressources de calcul. Trouver une telle disposition n'est pas difficile pour une simple chaîne linéaire, mais à mesure que les problèmes deviennent plus complexes, l'optimisation de la disposition du circuit devient plus difficile et plus précieuse.
Nous configurons maintenant notre primitive Sampler. Nous désactivons les autres outils de suppression/atténuation pour nous concentrer sur le Pauli twirling.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Enfin, nous exécutons nos jobs. Tu peux éventuellement afficher les numéros d'identification des jobs pour une récupération ultérieure.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
Nous extrayons les décomptes de chaque état de base computationnel mesuré pour tous les circuits, à la fois avec et sans twirling.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
Nous savons que la distribution idéale d'un état GHZ est celle où la moitié des tirs renvoie et l'autre moitié renvoie . Construis ceci à des fins de comparaison.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
Nous utilisons maintenant la fidélité de Hellinger comme mesure de la qualité de notre état final.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
Enfin, nous traçons nos résultats.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
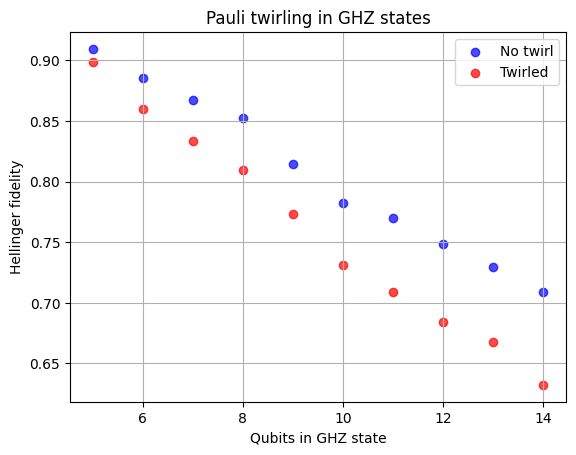
Les résultats utilisant le Pauli twirling ne sont pas meilleurs (et même légèrement pires) que sans twirling. Que s'est-il passé ?
Deux choses se sont produites. Premièrement, le Pauli twirling ne réduit pas la quantité totale de bruit — il transforme plutôt les erreurs cohérentes et systématiques en erreurs de type Pauli stochastiques, de sorte que la croissance de l'erreur devienne prévisible et modélisable. Il n'y a jamais eu de promesse de réduction d'erreur, sauf dans des cas particuliers.
Deuxièmement, dans les circuits GHZ, certaines erreurs cohérentes peuvent partiellement s'annuler ou agir comme des déphasages bénins en raison de la symétrie de la construction GHZ ; le twirling supprime cette protection accidentelle et la remplace par un bruit de Pauli stochastique non corrélé, de sorte que la fidélité GHZ devient légèrement pire sous twirling.
Cette deuxième affirmation nécessite quelques explications. L'affirmation n'est pas que les circuits GHZ sont protégés contre tous les types d'accumulation d'erreurs cohérentes, seulement certains types — et que dans ces cas, la protection est détruite par le twirling. Plus précisément, considérons la sur-rotation cohérente associée aux portes CX. Appelons la porte CX réelle avec sur-rotation :
où est un produit quelconque d'opérateurs de Pauli, comme , , , , etc. Pour des états généraux, l'une quelconque de ces sur-rotations pourrait affecter les statistiques de mesure (et donc les mesures de fidélité de l'état). Un sous-ensemble de ces sur-rotations, cependant, laisse de nombreux observables GHZ standards inchangés, y compris des opérateurs tels que et . Dans le contexte de la préparation d'un état GHZ, les erreurs de sur-rotation pertinentes de ce type seraient :
La préparation de l'état GHZ complet à qubits ressemblerait à :
Après avoir préparé l'état GHZ, l'état est idéalement :
Cet état est un état propre simultané d'un large ensemble d'opérateurs de Pauli, y compris les suivants :
avec la valeur propre . Par conséquent, un opérateur de la forme agit sur l'état GHZ comme une multiplication par le facteur de phase , ce qui n'affecte pas les observables GHZ standards tels que la parité, le collectif, ou les populations dans la base computationnelle. Ainsi, bien que les erreurs de sur-rotation soient cohérentes et systématiques, elles sont effectivement invisibles pour les mesures utilisées afin d'évaluer la fidélité GHZ. En ce sens, le circuit GHZ bénéficie d'une protection de cohérence accidentelle : certaines erreurs CX cohérentes commutent avec la structure de l'état préparé et ne dégradent donc pas la performance mesurée.
Le twirling de Pauli change fondamentalement cette situation. Le twirling ne préserve pas l'erreur de sur-rotation cohérente en tant que processus déterministe. Au lieu de cela, il convertit le canal d'erreur cohérent en un canal de Pauli stochastique effectif. Par conséquent, le canal d'erreur inclut désormais des termes tels que , , , et , qui ne commutent pas avec les stabilisateurs GHZ.
Lorsque ces erreurs de Pauli stochastiques se produisent, elles créent de véritables défauts de bit-flip et de phase-flip sur des qubits individuels ou des paires de qubits. Ces erreurs sortent l'état du sous-espace stabilisateur GHZ, réduisent l'interférence entre et , et diminuent directement la fidélité GHZ et les signaux de parité multi-qubits. En d'autres termes, le twirling de Pauli supprime la structure cohérente de l'erreur mais supprime également l'annulation basée sur la symétrie qui rendait auparavant ces erreurs bénignes. Le résultat est un état GHZ légèrement moins bon — non pas parce que le twirling ajoute du bruit, mais parce qu'il convertit une erreur cohérente majoritairement inoffensive en erreurs stochastiques réellement dommageables.
Cet exemple met en évidence une leçon importante : le twirling de Pauli n'est pas une stratégie d'amélioration universelle. Il est le plus bénéfique lorsque des erreurs cohérentes s'accumulent à travers un circuit d'une manière destructive pour la fidélité requise. Dans des circuits hautement symétriques comme la préparation d'un état GHZ, certaines erreurs cohérentes sont naturellement alignées avec les stabilisateurs de l'état, et les randomiser délibérément peut éliminer cette protection accidentelle.
Combiner les méthodes
On peut en principe combiner le twirling de Pauli avec le découplage dynamique. Nous n'avons pas utilisé le DD dans ce cas pour deux raisons : premièrement, il ne devrait pas y avoir de périodes d'inactivité extrêmement longues dans ce circuit. Deuxièmement, les états GHZ ne stockent pas la majeure partie de leur information dans la cohérence de phase à un seul qubit, en particulier si nous observons la fidélité uniquement en termes de comptages de chaînes de bits, et non en termes de phase entre les chaînes de bits souhaitées et .
Si nous devions étendre la préparation GHZ à plus de 100 qubits, alors les délais de mesure des premiers qubits pourraient en effet être suffisamment longs pour que le DD soit utile. Ceci est particulièrement vrai lorsque l'on prend en compte la profondeur transpilée du circuit.
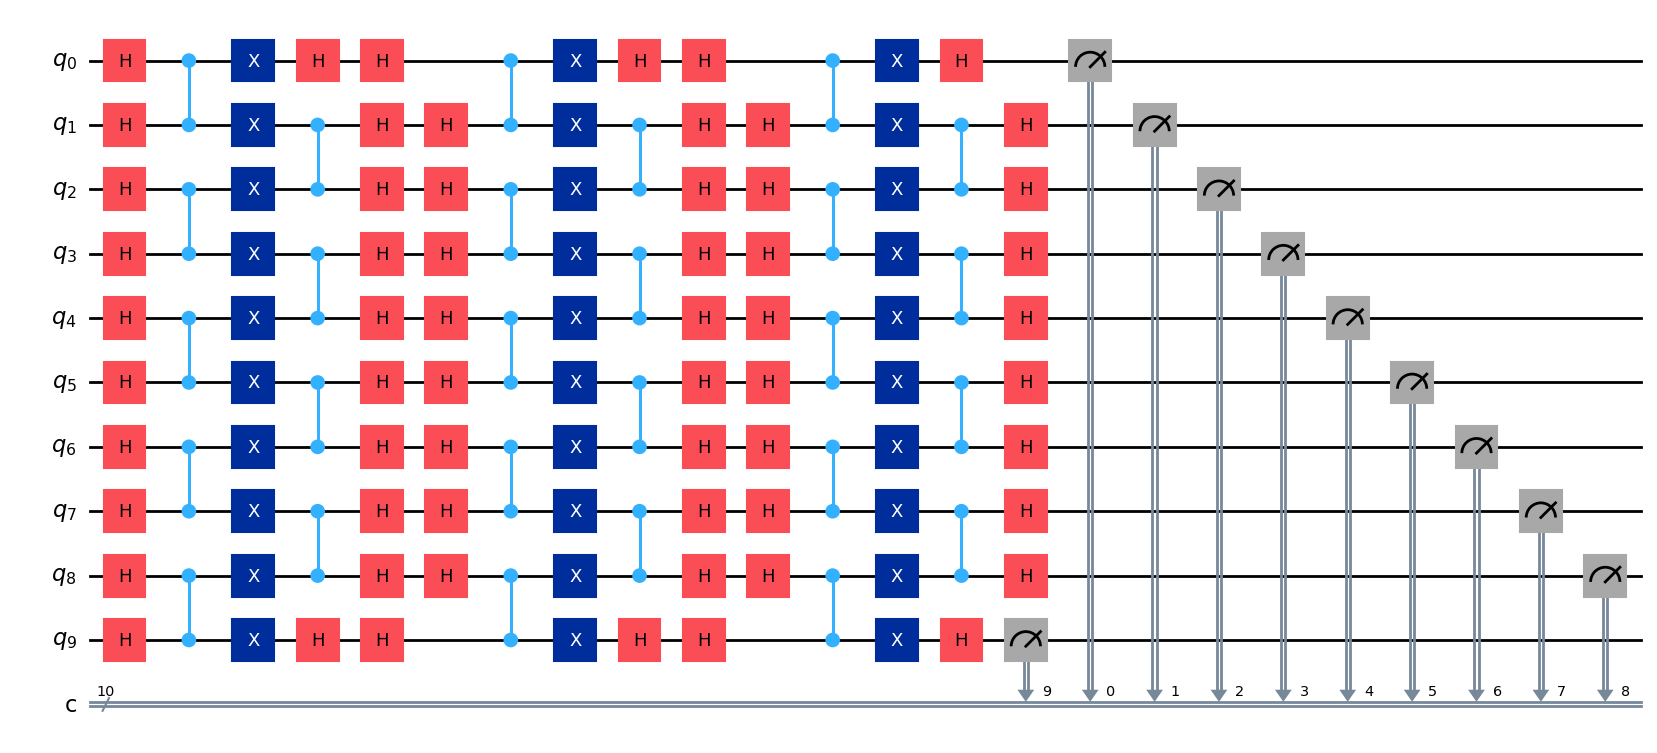
Twirling de Pauli dans la structure d'écho RTZ
Notre dernier exemple de twirling de Pauli dans le contexte de la réduction de l'accumulation d'erreurs cohérentes utilise un circuit avec des couches de combinaisons X-CZ-X-CZ. Il s'agit d'une séquence de portes bien connue, souvent utilisée pour annuler les termes d'erreur ZZ cohérents dans les portes à deux qubits, même sans twirling. Mais avec le twirling, nous pouvons réduire ou randomiser d'autres formes d'accumulation d'erreurs cohérentes.
Nous allons commencer par définir une fonction permettant de construire des circuits de type RTZ avec un nombre variable de couches.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
Maintenant, nous construisons des circuits avec un nombre croissant de couches, jusqu'à une profondeur totale transpilée à deux qubits raisonnable.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
Aux valeurs élevées, certains de ces circuits sont assez profonds. Utilisons l'AerSimulator sans modèle de bruit pour obtenir les états idéaux à la fin de chacun de ces circuits. Nous pouvons ensuite évaluer nos résultats provenant d'ordinateurs quantiques réels à l'aide de la fidélité de Hellinger.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
Maintenant, nous définissons un SamplerV2 avec twirling, et un autre sans twirling.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
Maintenant, nous exécutons nos jobs.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
Nous récupérons les comptages de chacune des exécutions sur un ordinateur quantique réel.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
Maintenant, nous calculons la fidélité de Hellinger en comparant chacune de ces exécutions aux résultats de l'AerSimulator sans bruit.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
Maintenant, nous visualisons nos résultats.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
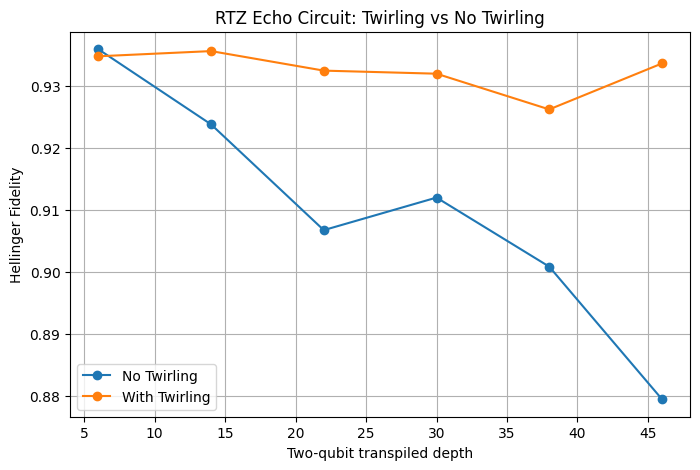
Tout au long de cette leçon, nous avons examiné des cas où le twirling de Pauli est utilisé pour limiter l'accumulation d'erreurs cohérentes, un contexte dans lequel il pourrait être décrit comme une suppression d'erreur. Cependant, le twirling de Pauli est souvent plus utile en tant qu'outil pour remodeler le comportement des erreurs, en convertissant les erreurs cohérentes en une forme plus prévisible et plus facile à modéliser. L'utilité de cela deviendra plus évidente dans le contexte de techniques d'atténuation d'erreurs telles que l'extrapolation à bruit nul (ZNE), qui s'appuient sur une mise à l'échelle du bruit raisonnablement prévisible. Ceci est abordé dans la prochaine leçon.