Performance Management : une Qiskit Function par Q-CTRL Fire Opal
Consulte la référence API
Les Qiskit Functions sont une fonctionnalité expérimentale réservée aux utilisateurs des plans IBM Quantum® Premium, Flex et On-Prem (via l'API IBM Quantum Platform). Elles sont en version préliminaire et susceptibles d'évoluer.
Package versions
Le code de cette page a été développé avec les prérequis suivants. Nous recommandons d'utiliser ces versions ou des versions plus récentes.
qiskit[all]~=2.3.1
qiskit-ibm-runtime~=0.45.1
Vue d'ensemble
Fire Opal Performance Management permet à quiconque d'obtenir des résultats significatifs à partir d'ordinateurs quantiques à grande échelle, sans avoir besoin d'être expert en matériel quantique. Lorsque tu exécutes des circuits avec Fire Opal Performance Management, des techniques de suppression des erreurs basées sur l'IA sont automatiquement appliquées, permettant de traiter des problèmes plus vastes avec davantage de portes et de qubits. Cette approche réduit le nombre de shots nécessaires pour obtenir la bonne réponse, sans surcharge supplémentaire — ce qui se traduit par des économies significatives en termes de temps de calcul et de coût.
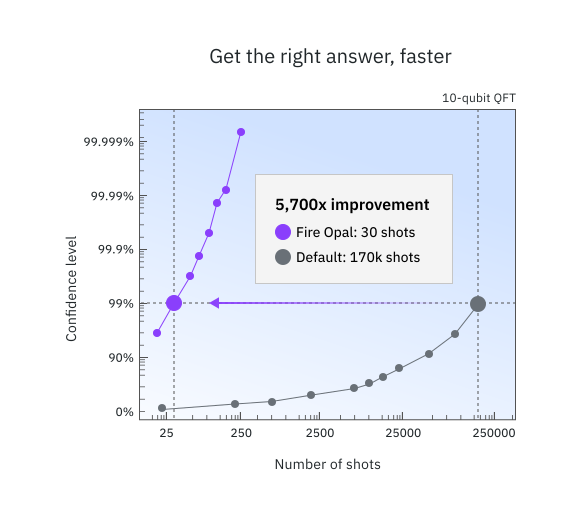
Performance Management supprime les erreurs et augmente la probabilité d'obtenir la bonne réponse sur du matériel bruité. En d'autres termes, il améliore le rapport signal/bruit. L'image ci-dessous montre comment la précision accrue offerte par Performance Management peut réduire le besoin de shots supplémentaires dans le cas d'un algorithme de transformée de Fourier quantique à 10 qubits. Avec seulement 30 shots, Q-CTRL atteint le seuil de confiance à 99 %, alors que la configuration par défaut (QiskitRuntime Sampler, optimization_level=3 et resilience_level=1, ibm_sherbrooke) en nécessite 170 000. En obtenant la bonne réponse plus vite, tu économises un temps de calcul considérable.
La fonction Performance Management peut être utilisée avec n'importe quel algorithme, et tu peux facilement l'utiliser à la place des primitives IBM Quantum standard. En arrière-plan, plusieurs techniques de suppression des erreurs fonctionnent ensemble pour prévenir les erreurs au moment de l'exécution. Toutes les méthodes du pipeline Fire Opal sont préconfigurées et indépendantes des algorithmes, ce qui signifie que tu obtiens toujours les meilleures performances prêtes à l'emploi.
Pour accéder à Performance Management, contacte Q-CTRL.
Description
Fire Opal Performance Management propose deux modes d'exécution similaires aux primitives IBM Quantum, ce qui te permet de remplacer facilement les primitives standard par le Sampler et l'Estimator Q-CTRL. Le flux de travail général pour utiliser la fonction Performance Management est :
- Définis ton circuit (et les opérateurs dans le cas de l'Estimator).
- Exécute le circuit.
- Récupère les résultats.
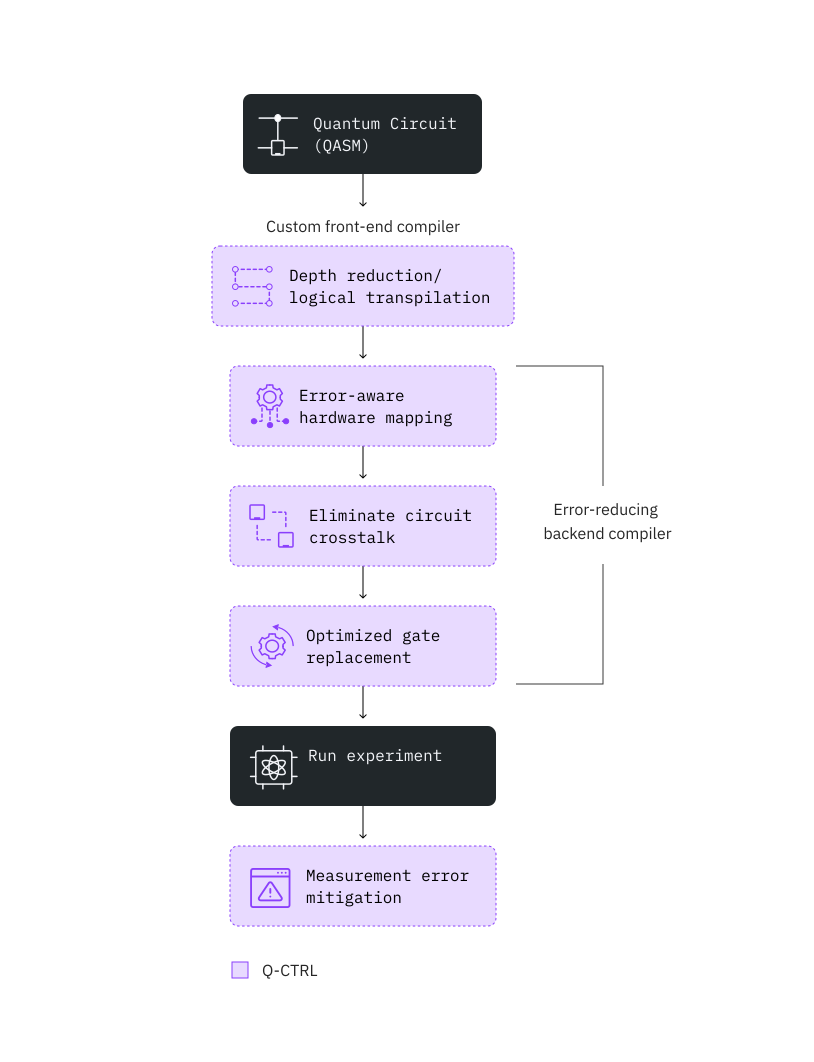
Pour réduire le bruit matériel, Fire Opal emploie un ensemble de techniques de suppression des erreurs basées sur l'IA, illustrées dans l'image suivante. Avec Fire Opal, l'ensemble du pipeline est entièrement automatisé, sans aucune configuration nécessaire.
Le pipeline Fire Opal élimine le besoin de surcharges supplémentaires, telles qu'un temps d'exécution quantique accru ou des qubits physiques supplémentaires. Note que le temps de traitement classique reste un facteur (consulte la section Benchmarks pour des estimations ; le « Temps total » reflète à la fois le traitement classique et quantique). Contrairement à la mitigation des erreurs, qui nécessite une surcharge sous forme d'échantillonnage, la suppression des erreurs de Fire Opal opère aux niveaux des portes et des impulsions pour traiter diverses sources de bruit et prévenir la survenue d'erreurs. En prévenant les erreurs, la nécessité d'un post-traitement coûteux est éliminée.
L'image suivante illustre les méthodes de suppression des erreurs automatisées par Fire Opal Performance Management.
La fonction offre deux primitives, Sampler et Estimator, et les entrées et sorties des deux étendent la spécification implémentée pour les primitives IBM Quantum V2.
Benchmarks
Les résultats de benchmarking algorithmique publiés démontrent une amélioration significative des performances pour divers algorithmes, notamment Bernstein-Vazirani, la transformée de Fourier quantique, la recherche de Grover, l'algorithme d'optimisation approximative quantique (QAOA) et le solveur variationnel quantique de valeurs propres (VQE). La suite de cette section fournit plus de détails sur les types d'algorithmes que tu peux exécuter, ainsi que les performances et temps d'exécution attendus.
Les études indépendantes suivantes montrent comment Performance Management de Q-CTRL permet la recherche algorithmique à une échelle record :
- Parametrized Energy-Efficient Quantum Kernels for Network Service Fault Diagnosis — apprentissage de noyaux quantiques jusqu'à 50 qubits
- Tensor-based quantum phase difference estimation for large-scale demonstration — estimation de phase quantique jusqu'à 33 qubits
- Hierarchical Learning for Quantum ML: Novel Training Technique for Large-Scale Variational Quantum Circuits — chargement de données quantiques jusqu'à 21 qubits
Le tableau suivant fournit un guide approximatif sur la précision et les temps d'exécution issus de benchmarkings antérieurs sur ibm_fez. Les performances sur d'autres appareils peuvent varier. Le temps d'utilisation est basé sur une hypothèse de 10 000 shots par circuit. Le « Nombre de qubits » indiqué n'est pas une limite stricte, mais représente des seuils approximatifs où tu peux t'attendre à une précision de solution extrêmement constante. Des problèmes de plus grande taille ont été résolus avec succès, et les tests au-delà de ces limites sont encouragés.
| Exemple | Nombre de qubits | Précision | Mesure de précision | Temps total (s) | Utilisation Runtime (s) | Primitive (Mode) |
|---|---|---|---|---|---|---|
| Bernstein–Vazirani | 50Q | 100 % | Taux de succès (pourcentage d'exécutions où la bonne réponse est la chaîne de bits ayant le plus grand nombre d'occurrences (le comptage le plus élevé)) | 10 | 8 | Sampler |
| Transformée de Fourier quantique | 30Q | 100 % | Taux de succès (pourcentage d'exécutions où la bonne réponse est la chaîne de bits ayant le plus grand nombre d'occurrences (le comptage le plus élevé)) | 10 | 8 | Sampler |
| Estimation de phase quantique | 30Q | 99,9998 % | Précision de l'angle trouvé : 1- abs(real_angle - angle_found)/pi | 10 | 8 | Sampler |
| Simulation quantique : modèle d'Ising (15 étapes) | 20Q | 99,775 % | (défini ci-dessous) | 60 (par étape) | 15 (par étape) | Estimator |
| Simulation quantique 2 : dynamique moléculaire (20 points temporels) | 34Q | 96,78 % | (défini ci-dessous) | 10 (par point temporel) | 6 (par point temporel) | Estimator |
Définition de la précision de la mesure d'une valeur d'espérance — la métrique est définie comme suit :
où = valeur d'espérance idéale, = valeur d'espérance mesurée, = valeur idéale maximale, et = valeur idéale minimale. est simplement la moyenne de la valeur de sur plusieurs mesures.
Cette métrique est utilisée car elle est invariante aux décalages globaux et à la mise à l'échelle de la plage de valeurs atteignables. En d'autres termes, que tu décales la plage des valeurs d'espérance possibles vers le haut ou vers le bas, ou que tu augmentes l'étendue, la valeur de doit rester cohérente.
Premiers pas
Fire Opal Performance Management utilise Qiskit v2.0.0, qui est la version recommandée. Les versions supportées sont Qiskit >=v2.0.0.
Authentifie-toi avec ta clé API IBM Quantum Platform, et sélectionne la Qiskit Function comme suit. (Cet extrait suppose que tu as déjà sauvegardé ton compte dans ton environnement local.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# This cell is hidden from users. It hides the "...You have imported samplomatic..." warning.
import warnings

warnings.filterwarnings("ignore", message=".*You have imported samplomatic*")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
perf_mgmt = catalog.load("q-ctrl/performance-management")
Si tu souhaites utiliser un backend que cette fonction ne prend pas encore en charge, contacte Q-CTRL pour ajouter le support.
Primitive Estimator
Exemple avec l'Estimator
Utilise la primitive Estimator de Fire Opal Performance Management pour déterminer la valeur d'espérance d'une seule paire circuit-observable.
En plus des packages qiskit-ibm-catalog et qiskit, tu utiliseras également le package numpy pour exécuter cet exemple. Tu peux installer ce package en décommentant la cellule suivante si tu exécutes cet exemple dans un notebook utilisant le noyau IPython.
# %pip install numpy
1. Créer le circuit
À titre d'exemple, génère un opérateur hermitien aléatoire et un observable à fournir en entrée à la fonction Performance Management.
import numpy as np
from qiskit.circuit.library import iqp
from qiskit.quantum_info import random_hermitian, SparsePauliOp

n_qubits = 50

# Generate a random circuit
mat = np.real(random_hermitian(n_qubits, seed=1234))
circuit = iqp(mat)
circuit.measure_all()

# Define observables as a string
observable = SparsePauliOp("Z" * n_qubits)
# Create PUB tuple
estimator_pubs = [(circuit, observable)]
2. Exécuter le circuit
Exécute le circuit et définis éventuellement le backend et le nombre de shots.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
# Run the circuit using Estimator
qctrl_estimator_job = perf_mgmt.run(
    primitive="estimator",
    pubs=estimator_pubs,
    backend_name=backend_name,
)
Tu peux utiliser les API Qiskit Serverless que tu connais déjà pour vérifier le statut de ta charge de travail Qiskit Function :
qctrl_estimator_job.status()
'QUEUED'
3. Récupérer le résultat
# Retrieve the counts from the result list
result = qctrl_estimator_job.result()
Les résultats ont le même format qu'un résultat Estimator :
import numpy

result_str = str(result)

with numpy.printoptions(threshold=200):
    print(
        f"The result of the submitted job had {len(result)} PUB "
        f"and has a value:\n {result[0]}\n"
    )

print("The associated PubResult of this job has the following DataBins:")
print(f"{result[0].data}\n")

print(f"And this DataBin has attributes: {result[0].data.keys()}")

print("The expectation values measured from this PUB are:")
print(f"{result[0].data.evs}")
The result of the submitted job had 1 PUB
The result of the submitted job had 1 PUB and has a value:
 PubResult(data=DataBin(evs=0.0195, stds=0.9998098569228051), metadata={'precision': None})

The associated PubResult of this job has the following DataBins:
DataBin(evs=0.0195, stds=0.9998098569228051)

And this DataBin has attributes: dict_keys(['evs', 'stds'])
The expectation values measured from this PUB are:
0.0195
Primitive Sampler
Exemple avec le Sampler
Utilise la primitive Sampler de Fire Opal Performance Management pour exécuter un circuit Bernstein–Vazirani. Cet algorithme, utilisé pour trouver une chaîne cachée à partir des sorties d'une fonction boîte noire, est un algorithme de benchmarking courant car il n'existe qu'une seule réponse correcte. 1. Créer le circuit
Définis la bonne réponse à l'algorithme, la chaîne de bits cachée, et le circuit Bernstein–Vazirani. Tu peux ajuster la largeur du circuit en modifiant simplement circuit_width.
import qiskit

circuit_width = 35
hidden_bitstring = "1" * circuit_width

# Create circuit, reserving one qubit for BV oracle
bv_circuit = qiskit.QuantumCircuit(circuit_width + 1, circuit_width)
bv_circuit.x(circuit_width)
bv_circuit.h(range(circuit_width + 1))
for input_qubit, bit in enumerate(reversed(hidden_bitstring)):
    if bit == "1":
        bv_circuit.cx(input_qubit, circuit_width)
bv_circuit.barrier()
bv_circuit.h(range(circuit_width + 1))
bv_circuit.barrier()
for input_qubit in range(circuit_width):
    bv_circuit.measure(input_qubit, input_qubit)

# Create PUB tuple
sampler_pubs = [(bv_circuit,)]
2. Exécuter le circuit
Exécute le circuit et définis éventuellement le backend et le nombre de shots.
# Run the circuit using Sampler
qctrl_sampler_job = perf_mgmt.run(
    primitive="sampler",
    pubs=sampler_pubs,
    backend_name=backend_name,
)
Vérifie le statut de ta charge de travail Qiskit Function ou récupère les résultats comme suit :
# Print the ID so you can use it later, if necessary
print(qctrl_sampler_job.job_id)

qctrl_sampler_job.status()
60fe2fa1-a860-43e4-8615-c6ac4180f93b
'QUEUED'
3. Récupérer le résultat
# Retrieve the job results
sampler_result = qctrl_sampler_job.result()
# Get results for the first (and only) PUB
pub_result = sampler_result[0]
counts = pub_result.data.c.get_counts()

print("Counts for the meas output register (limited to 30 results):")
for i, (bitstring, count) in enumerate(counts.items()):
    if i >= 50:
        print(f"  ... ({len(counts) - 30} more items)")
        break
    print(f"  {bitstring}: {count}")
Counts for the meas output register (limited to 30 results):
  11111111111111111111111111111111111: 1661
  11111111111111111111111111110111111: 60
  11111111111111111111111111111101111: 54
  11111111111111111111111111111110111: 54
  11111111111111011111111111111111111: 46
  11111111111111111110111111111111111: 44
  11111111111111111111111101111111111: 42
  11111111111111111111111110111111111: 42
  11111111111111110111111111111111111: 41
  11111111111111111111111111111111101: 39
  11111111111111111111101111111111111: 38
  11111111111111111111110111111111111: 38
  11111111111111111111111111101111111: 37
  11111111111111111111111111111111110: 36
  11111111111110111111111111111111111: 35
  11111111111111111111111111111011111: 32
  11111111111111101111111111111111111: 32
  01111111111111111111111111111111111: 27
  11111111111111111011111111111111111: 23
  11111111101111111111111111111111111: 22
  11111111111111111111111111111111011: 21
  11111111011111111111111111111111111: 20
  00000000000000011111111111111111111: 18
  11111111111111111111110101111111111: 18
  00000001111111111111111111111111111: 17
  11111111001111111111111111111111111: 16
  11101111111111111111111111111111111: 16
  11111111111101111111111111111111111: 16
  00000101111111111111111111111111111: 13
  11111111111111111111111011111111111: 13
  11111111111111111111111110101111111: 13
  11111111111111111101111111111111111: 12
  10111111111111111111111111111111111: 12
  11111111111111111111111110001111111: 12
  00000000000000000011111111111111111: 11
  11111111111111111111111111111110110: 10
  00000000000000000000000001111111111: 10
  11111111111011111111111111111111111: 9
  11111111111111101011111111111111111: 9
  00000000011111111111111111111111111: 8
  10101111111111111111111111111111111: 8
  00000000000000000000000001011111111: 8
  11111111111111111111111111111111001: 8
  00000111111111111111111111111111111: 7
  11111111111111111111111111111101110: 7
  11111111110111111111111111111111111: 7
  00000000000001011111111111111111111: 6
  00000000000000001111111111111111111: 6
  00000000000000000001011111111111111: 6
  11111111111111111111111111011111111: 6
  ... (1050 more items)
3. Tracer les principales chaînes de bits
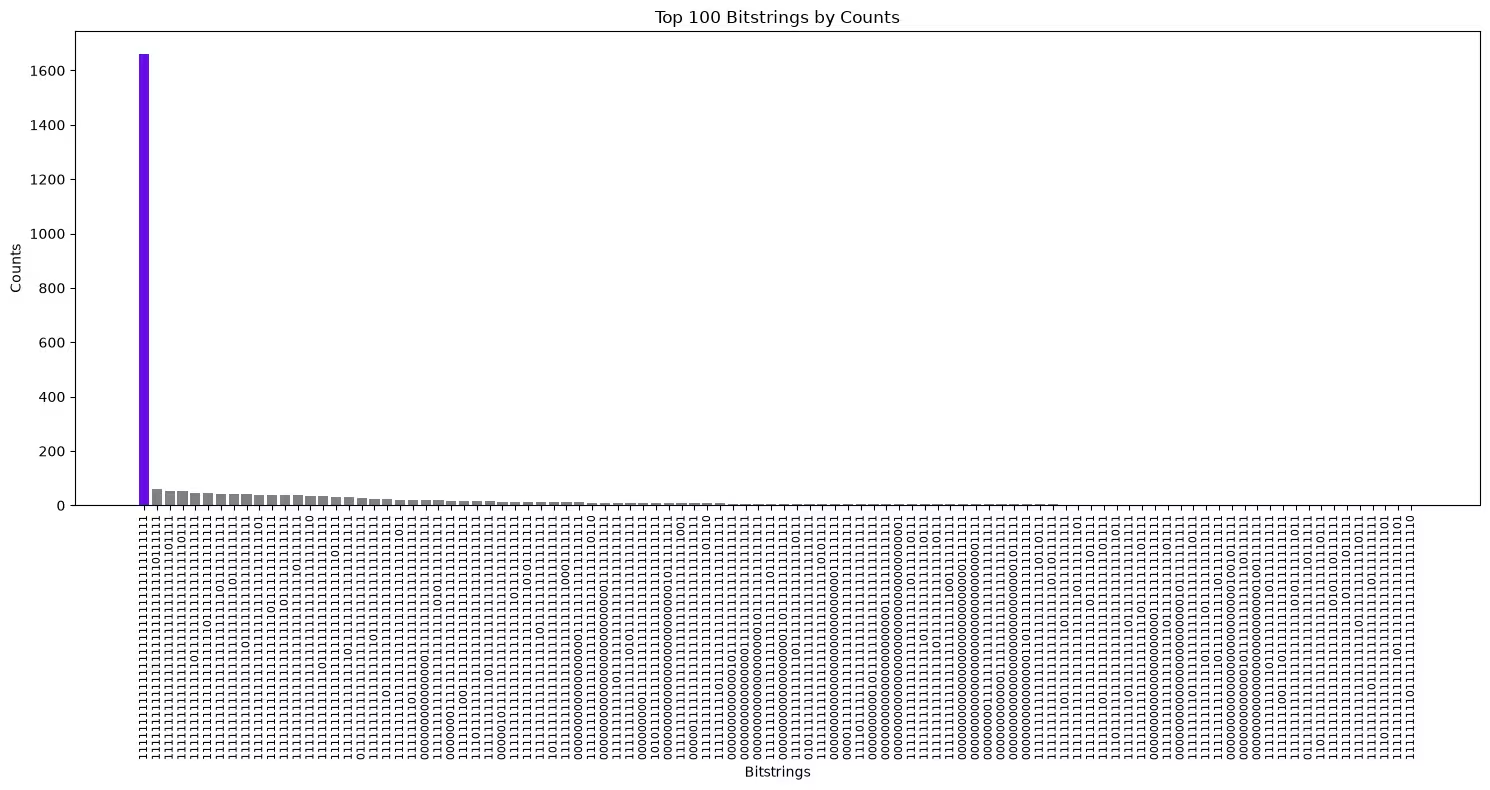
Trace la chaîne de bits ayant le plus grand nombre d'occurrences (le comptage le plus élevé) pour vérifier si la chaîne cachée est bien le mode.
import matplotlib.pyplot as plt

def plot_top_bitstrings(counts_dict, hidden_bitstring=None):
    # Sort and take the top 100 bitstrings
    top_100 = sorted(counts_dict.items(), key=lambda x: x[1], reverse=True)[
        :100
    ]
    if not top_100:
        print("No bitstrings found in the input dictionary.")
        return

    # Unzip the bitstrings and their counts
    bitstrings, counts = zip(*top_100)

    # Assign colors: purple if the bitstring matches hidden_bitstring,
    # otherwise gray
    colors = [
        "#680CE9" if bit == hidden_bitstring else "gray" for bit in bitstrings
    ]

    # Create the bar plot
    plt.figure(figsize=(15, 8))
    plt.bar(
        range(len(bitstrings)), counts, tick_label=bitstrings, color=colors
    )

    # Rotate the bitstrings for better readability
    plt.xticks(rotation=90, fontsize=8)
    plt.xlabel("Bitstrings")
    plt.ylabel("Counts")
    plt.title("Top 100 Bitstrings by Counts")

    # Show the plot
    plt.tight_layout()
    plt.show()
La chaîne de bits cachée est surlignée en violet, et elle devrait être la chaîne de bits ayant le plus grand nombre d'occurrences (le comptage le plus élevé).
plot_top_bitstrings(counts, hidden_bitstring)
Journal des modifications
-
2026-02-20 : Avis de dépréciation — le champ de métadonnées
provider_job_idssera déprécié dans 30 jours dans la version 0.13.0. Les utilisateurs peuvent accéder à l'identifiant de tâche via la méthodejob_id()du service Qiskit Runtime. -
2026-02-11 : Prise en charge de
ibm_miamiajoutée, et métadonnées d'exécution ajoutées auPubResult.
Obtenir de l'aide
Pour toute question ou problème, contacte Q-CTRL.
Étapes suivantes
-
Demande l'accès à Q-CTRL Performance Management.
-
Consulte la référence API pour cette Qiskit Function.
-
Essaie le tutoriel Modèle d'Ising en champ transverse avec Performance Management de Q-CTRL.
-
Essaie le tutoriel Estimation de phase quantique avec les Qiskit Functions de Q-CTRL
-
Consulte l'étude de cas Mitsubishi Chemical Corp.
-
Consulte l'étude de cas d'une banque anonymisée.
-
Consulte l'étude de cas BlueQubit.