QESEM : une Qiskit Function par Qedma
Consulte la référence de l'API
Versions des packages
Le code de cette page a été développé à l'aide des exigences suivantes. Nous recommandons d'utiliser ces versions ou des versions plus récentes.
qiskit[all]~=2.5.0
qiskit-ibm-runtime~=0.47.0
Les Qiskit Functions sont une fonctionnalité expérimentale réservée aux utilisateurs des plans IBM Quantum® Premium, Flex et On-Prem (via l'API IBM Quantum Platform). Elles sont en version préliminaire et susceptibles d'évoluer.
Vue d'ensemble
Bien que les unités de traitement quantique aient considérablement progressé ces dernières années, les erreurs dues au bruit et aux imperfections du matériel existant restent un défi central pour les développeurs d'algorithmes quantiques. À mesure que le domaine s'approche de calculs quantiques à l'échelle utilitaire impossibles à vérifier classiquement, des solutions garantissant une suppression du bruit précise deviennent de plus en plus importantes. Pour relever ce défi, Qedma a développé l'atténuation d'erreurs quantiques (QESEM), intégrée de façon transparente sur IBM Quantum Platform en tant que Qiskit Function.
Avec QESEM, tu peux exécuter tes circuits quantiques sur des QPU bruités pour obtenir des résultats précis et sans erreur, avec des surcoûts en temps QPU très efficaces, proches des limites fondamentales. Pour ce faire, QESEM exploite un ensemble de méthodes propriétaires développées par Qedma pour la caractérisation et la réduction des erreurs. Les techniques de réduction des erreurs comprennent l'optimisation des portes, la transpilation tenant compte du bruit, la suppression d'erreurs (ES) et l'atténuation d'erreurs non biaisée (EM). Grâce à cette combinaison de méthodes basées sur la caractérisation, tu peux obtenir des résultats fiables et sans erreur pour des circuits quantiques génériques de grand volume, ce qui ouvre la voie à des applications autrement inaccessibles.
Pour une description complète des composants sous-jacents ainsi qu'une démonstration à l'échelle utilitaire, consulte l'article Reliable high-accuracy error mitigation for utility-scale quantum circuits.
Description
Tu peux utiliser la fonction QESEM de Qedma pour estimer et exécuter facilement tes circuits avec suppression et atténuation des erreurs, en atteignant des volumes de circuits plus grands et des précisions plus élevées. Pour utiliser QESEM, tu fournis un circuit quantique, un ensemble d'observables à mesurer, une précision statistique cible pour chaque observable, ainsi qu'un QPU choisi. Avant d'exécuter le circuit jusqu'à la précision cible, tu peux estimer le temps QPU nécessaire à partir d'un calcul analytique qui ne nécessite aucune exécution de circuit. Une fois satisfait de l'estimation du temps QPU, tu peux exécuter le circuit avec QESEM.
Lorsque tu exécutes un circuit, QESEM lance un protocole de caractérisation du dispositif adapté à ton circuit, ce qui produit un modèle de bruit fiable pour les erreurs survenant dans le circuit. Sur la base de cette caractérisation, QESEM met d'abord en œuvre une transpilation tenant compte du bruit pour mapper le circuit d'entrée sur un ensemble de qubits et de portes physiques, minimisant ainsi le bruit affectant l'observable cible. Cela inclut les portes nativement disponibles (CX/CZ sur les dispositifs IBM®), ainsi que des portes supplémentaires optimisées par QESEM, formant le jeu de portes étendu de QESEM. QESEM exécute ensuite un ensemble de circuits ES et EM basés sur la caractérisation sur le QPU et collecte leurs résultats de mesure. Ces résultats sont ensuite post-traités classiquement pour fournir une valeur d'espérance non biaisée et une barre d'erreur pour chaque observable, correspondant à la précision demandée.
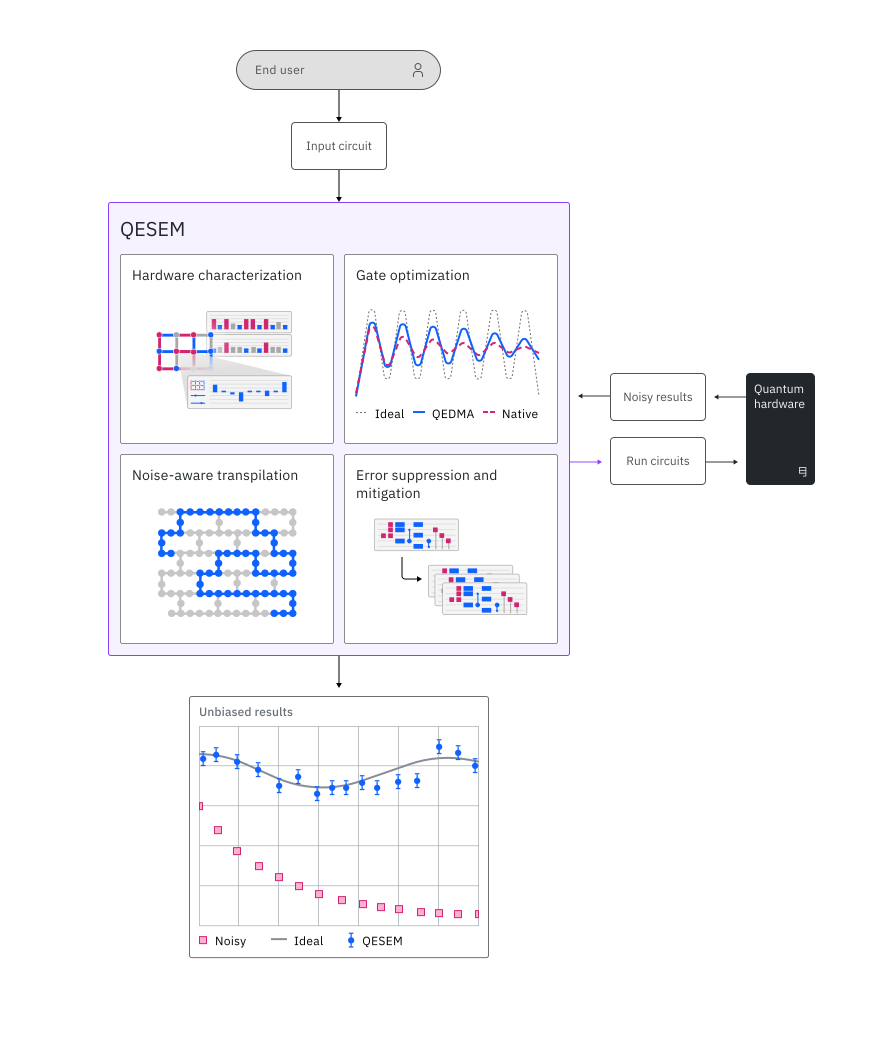 QESEM a démontré sa capacité à fournir des résultats de haute précision pour une variété d'applications quantiques et sur les plus grands volumes de circuits réalisables aujourd'hui. QESEM offre les fonctionnalités suivantes pour l'utilisateur, illustrées dans la section des benchmarks ci-dessous :
- Précision garantie : QESEM produit des estimations non biaisées des valeurs d'espérance des observables. Sa méthode EM est dotée de garanties théoriques qui — combinées à la caractérisation de pointe de Qedma — assurent que l'atténuation converge vers la sortie du circuit sans bruit, à la précision spécifiée par l'utilisateur. Contrairement à de nombreuses méthodes EM heuristiques sujettes à des erreurs systématiques ou des biais, la précision garantie de QESEM est essentielle pour assurer des résultats fiables pour des circuits et des observables génériques.
- Passage à l'échelle sur de grands QPU : Le temps QPU de QESEM dépend des volumes de circuits, mais est par ailleurs indépendant du nombre de qubits. Qedma a démontré QESEM sur les plus grands dispositifs quantiques disponibles aujourd'hui, notamment les dispositifs IBM Quantum Eagle à 127 qubits et Heron à 133 qubits.
- Indépendant de l'application : QESEM a été démontré sur une variété d'applications, notamment la simulation hamiltonienne, VQE, QAOA et l'estimation d'amplitude. Tu peux saisir n'importe quel circuit quantique et observable à mesurer, et obtenir des résultats précis et sans erreur. Les seules limitations sont dictées par les spécifications matérielles et le temps QPU alloué, qui déterminent les volumes de circuits accessibles et les précisions de sortie. En revanche, de nombreuses solutions de réduction des erreurs sont spécifiques à une application ou font appel à des heuristiques non contrôlées, ce qui les rend inapplicables pour des circuits et des applications génériques.
- Jeu de portes étendu : QESEM prend en charge les portes à angles fractionnaires et fournit des portes à angles fractionnaires optimisées par Qedma sur les dispositifs IBM Quantum Heron et Eagle. Ce jeu de portes étendu permet une compilation plus efficace et ouvre des volumes de circuits jusqu'à 2 fois plus grands par rapport à la compilation CX/CZ par défaut.
- Observables multi-bases : QESEM prend en charge des observables d'entrée composées de nombreuses chaînes de Pauli non commutatives, comme les hamiltoniens génériques. Le choix des bases de mesure et l'optimisation de l'allocation des ressources QPU (shots et circuits) sont alors effectués automatiquement par QESEM pour minimiser le temps QPU requis pour la précision demandée. Cette optimisation, qui tient compte des fidélités matérielles et des taux d'exécution, te permet d'exécuter des circuits plus profonds et d'obtenir de meilleures précisions.
Benchmarks
QESEM a été testé sur une grande variété de cas d'utilisation et d'applications. Les exemples suivants peuvent t'aider à évaluer quels types de charges de travail tu peux exécuter avec QESEM.
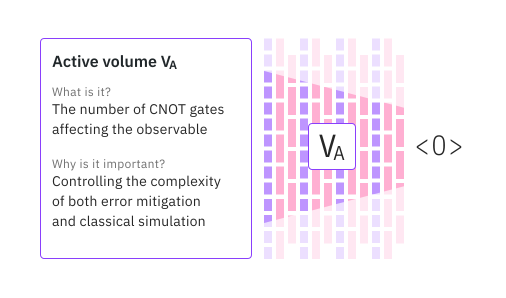
Un indicateur clé pour quantifier la difficulté tant de l'atténuation des erreurs que de la simulation classique pour un circuit et un observable donnés est le volume actif : le nombre de portes CNOT affectant l'observable dans le circuit. Le volume actif dépend de la profondeur et de la largeur du circuit, du poids de l'observable, et de la structure du circuit, qui détermine le cône de lumière de l'observable. Pour plus de détails, consulte l'exposé du IBM Quantum Summit 2024. QESEM apporte une valeur particulièrement grande dans le régime de grand volume, en fournissant des résultats fiables pour des circuits et des observables génériques.
| Application | Nombre de qubits | Dispositif | Description du circuit | Précision | Temps total | Utilisation runtime |
|---|---|---|---|---|---|---|
| Circuit VQE | 8 | Eagle (r3) | 21 couches au total, 9 bases de mesure, chaîne 1D | 98% | 35 min | 14 min |
| Kicked Ising | 28 | Eagle (r3) | 3 couches uniques x 3 pas, topologie heavy-hex 2D | 97% | 22 min | 4 min |
| Kicked Ising | 28 | Eagle (r3) | 3 couches uniques x 8 pas, topologie heavy-hex 2D | 97% | 116 min | 23 min |
| Simulation hamiltonienne de Trotter | 40 | Eagle (r3) | 2 couches uniques x 10 pas de Trotter, chaîne 1D | 97% | 3 heures | 25 min |
| Simulation hamiltonienne de Trotter | 119 | Eagle (r3) | 3 couches uniques x 9 pas de Trotter, topologie heavy-hex 2D | 95% | 6,5 heures | 45 min |
| Kicked Ising | 136 | Heron (r2) | 3 couches uniques x 15 pas, topologie heavy-hex 2D | 99% | 52 min | 9 min |
La précision est mesurée ici relativement à la valeur idéale de l'observable : , où « » est la précision absolue de l'atténuation (définie par l'entrée de l'utilisateur) et est la valeur de l'observable pour le circuit sans bruit. « Utilisation runtime » mesure l'utilisation du benchmark en batch mode (somme de l'utilisation des jobs individuels), tandis que « temps total » mesure l'utilisation en session mode (temps réel de l'expérience), ce qui inclut les temps de calcul classique et de communication supplémentaires. QESEM est disponible en exécution dans les deux modes, afin que tu puisses tirer le meilleur parti de tes ressources disponibles.
Les circuits Kicked Ising à 28 qubits simulent le quasi-cristal à temps discret étudié par Shinjo et al. (voir arXiv 2403.16718 et Q2B24 Tokyo) sur trois boucles connectées d'ibm_kawasaki. Les paramètres de circuit utilisés ici sont , avec un état initial ferromagnétique . L'observable mesuré est la valeur absolue de la magnétisation . L'expérience Kicked Ising à l'échelle utilitaire a été exécutée sur les 136 meilleurs qubits d'ibm_fez ; ce benchmark particulier a été exécuté à l'angle de Clifford , auquel le volume actif croît lentement avec la profondeur du circuit — ce qui, combiné aux hautes fidélités du dispositif, permet d'atteindre une grande précision en peu de temps.
Les circuits de simulation hamiltonienne de Trotter correspondent à un modèle d'Ising en champ transverse à angles fractionnaires : et respectivement (voir Q2B24 Tokyo). Le circuit à l'échelle utilitaire a été exécuté sur les 119 meilleurs qubits d'ibm_brisbane, tandis que l'expérience à 40 qubits a été exécutée sur la meilleure chaîne disponible. La précision est rapportée pour la magnétisation ; des résultats de haute précision ont également été obtenus pour des observables de poids plus élevé.
Le circuit VQE a été développé en collaboration avec des chercheurs du Center for Quantum Technology and Applications du Deutsches Elektronen-Synchrotron (DESY). L'observable cible ici était un hamiltonien constitué d'un grand nombre de chaînes de Pauli non commutatives, ce qui met en valeur les performances optimisées de QESEM pour les observables multi-bases. L'atténuation a été appliquée à un ansatz optimisé classiquement ; bien que ces résultats ne soient pas encore publiés, des résultats de même qualité seront obtenus pour différents circuits ayant des propriétés structurelles similaires.
Premiers pas
Authentifie-toi à l'aide de ta clé API IBM Quantum Platform, et sélectionne la Qiskit Function QESEM comme suit. (Cet extrait suppose que tu as déjà sauvegardé ton compte dans ton environnement local.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import qiskit
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
# load the function
qesem_function = catalog.load("qedma/qesem")
Exemples
Exemple de job d'estimation du temps
Le job d'estimation du temps est utile pour estimer le temps QPU nécessaire pour un pub et un backend_name donnés. backend_name peut également être défini sur n'importe quel backend simulateur ; par exemple, fake_fez.
QESEM utilise une méthode d'atténuation d'erreurs quasi-probabiliste basée sur la caractérisation. Cette méthode a un surcoût en temps QPU qui évolue approximativement comme :
Où est le volume actif du circuit, est la précision cible, et est l'infidélité des portes natives.
Note que "estimate_time_only": "empirical" utilise quelques minutes de temps QPU pour estimer le temps nécessaire au job (si le backend est un appareil réel ; s'il s'agit d'un simulateur, aucun temps QPU n'est utilisé). Cela prend généralement environ 5 minutes, mais pas plus de 10 minutes. Si l'infidélité change radicalement entre le job d'estimation empirique du temps et le job d'atténuation, le temps QPU changera également radicalement.
Pour commencer, essaie cet exemple de base qui estime le temps QPU nécessaire pour exécuter QESEM pour un pub donné :
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
backend_name = "fake_fez"

circ = qiskit.QuantumCircuit(5)
circ.cx(0, 1)
circ.cx(2, 3)
circ.cx(1, 2)
circ.cx(3, 4)

avg_magnetization = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("Z", [q], 1 / 5) for q in range(5)], num_qubits=5
)
other_observable = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("ZZ", [0, 1], 1.0), ("XZ", [1, 4], 0.5)], num_qubits=5
)

time_estimation_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    options={
        "estimate_time_only": "empirical",
    },
    backend_name=backend_name,  # example: "fake_fez", "ibm_fez"
)
time_estimate_result = (
    time_estimation_job.result()
)  # a list of results per pub (circuit)
L'extrait de code suivant décrit comment récupérer différentes métriques d'exécution du job d'estimation du temps (lorsque estimate_time_only est défini) :
pub_result = time_estimate_result[0]

print(
    f"The estimated QPU time for mitigation for this PUB is: {pub_result.metadata['time_estimation_sec']}"
)
print(
    f"The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
)
print(
    f"Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
)
print(f"Total shots: {pub_result.metadata['total_shots']}")
print(f"Resource usage breakdown: {pub_result.metadata['resource_usage']}")
The estimated QPU time for mitigation for this PUB is: 300
The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): 0
Gates fidelity measured during the experiment: {'CZ': 0.9951354916722668, 'ID1Q': 0.9991246627329172}
Total shots: 220000
Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 33.6066133165732, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 184.53575124032795, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
Lorsque l'estimation empirique du temps est activée, QESEM exécute un petit nombre de circuits pour fournir une estimation plus précise du temps QPU. Les résultats d'atténuation de ces circuits sont disponibles dans le champ empirical_estimation_mitigation_results du job.
Comme ces résultats proviennent d'un échantillon limité de circuits, ils sont nettement moins précis que les résultats finaux obtenus à partir du job complet d'atténuation QESEM. Cependant, lorsque le circuit est petit ou que la précision cible est faible, l'atténuation effectuée pendant l'estimation empirique du temps peut être suffisante pour atteindre la précision souhaitée, et le job d'atténuation complet peut ne pas être nécessaire.
Le champ empirical_estimation_mitigation_results est une liste d'objets PrimitiveResult par paramètre d'entrée. Si le circuit n'est pas paramétré, la liste aura une longueur de 1.
empirical_estimation_mitigation_results = time_estimate_result[0].metadata[
    "empirical_estimation_mitigation_results"
][0]  # a list per parameter
print("Partial results for the observables:")

print(
    f"    Mitigated expectation values: {empirical_estimation_mitigation_results.data.evs}"
)
print(
    f"    Mitigated error bars: {empirical_estimation_mitigation_results.data.stds}"
)
print(
    f"    Number of shots used for mitigation: {empirical_estimation_mitigation_results.metadata['mitigation_shots']}"
)
transpiled_circ = empirical_estimation_mitigation_results.metadata[
    "transpiled_circ"
]
print(f"    Qubit mapping: {transpiled_circ['qubit_maps']}")
print(
    f"    Number of measurement bases: {transpiled_circ['num_measurement_bases']}\n"
)

# results per obs
emp_obs_results = empirical_estimation_mitigation_results.metadata["results"][
    0
]
# print(f"Results for each observable: {results}")
print("Results for each observable:")

for i, (obs_array, result_dict) in enumerate(emp_obs_results):
    # obs_array, result_dict = results
    print(f"Observable {i+1}: {obs_array}")
    print(
        f"    QESEM mitigated value: {result_dict['qesem']['value']} \u00b1 {result_dict['qesem']['error_bar']}"
    )
Partial results for the observables:
    Mitigated expectation values: [1.00347302 1.00693905]
    Mitigated error bars: [0.00304061 0.00714276]
    Number of shots used for mitigation: 180000
    Qubit mapping: [[[0, 136], [1, 143], [2, 142], [3, 141], [4, 140]]]
    Number of measurement bases: 2

Results for each observable:
Observable 1: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
    QESEM mitigated value: 1.003473015776871 ± 0.0030406128032204015
Observable 2: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
    QESEM mitigated value: 1.0069390542613554 ± 0.0071427606736885925
Exemple de job d'atténuation QESEM
L'exemple suivant exécute un job QESEM :
sample_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    backend_name=backend_name,  # example: "ibm_fez"
    # options = {
    #     "estimate_time_only": "empirical",
    #     "default_precision": 0.2,  # Default precision is applied to all pubs that don't have a precision specified, see API reference for more details
    #     "max_execution_time": 3600,  # You can specify a maximum QPU time in seconds, see API reference for more details
    #     "transpilation_level": "standard",  # "minimal_with_layout_opt" for minimal transpilation, see API reference for more details
    #     "parallel_execution": True,  # True for parallel execution, see API reference for more details
    # },
)
Pour une description détaillée de chaque champ d'entrée et option, consulte la référence de l'API QESEM. Tu peux utiliser les API Qiskit Serverless habituelles pour vérifier le statut de ta charge de travail Qiskit Function ou récupérer les résultats :
# Print the ID so you can use it later, if necessary
print(sample_job.job_id)
print(sample_job.status())
sample_result = sample_job.result()
3ac6b2df-15b0-4dc0-8f48-cf14bd20a1c8
DONE
L'extrait de code suivant montre comment récupérer les résultats d'atténuation et les métriques d'exécution. Ces données contiennent des informations essentielles permettant de mieux comprendre comment différents paramètres influencent l'exécution de QESEM. Elles peuvent également être utiles lors de la rédaction d'un article basé sur tes recherches.
for pub_idx, pub_result in enumerate(
    sample_result
):  # each element in the list is a result for a different pub, here we sent only one pub
    print(f"\nPUB {pub_idx}:")
    print(
        f"  The QPU time that this job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
    )
    print(
        f"  Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
    )
    print(f"  Total shots: {pub_result.metadata['total_shots']}")
    print(
        f"  Number of shots used for mitigation: {pub_result.metadata['mitigation_shots']}"
    )
    print(
        f"  Resource usage breakdown: {pub_result.metadata['resource_usage']}"
    )
PUB 0:
  The QPU time that this job took is (here it is 0 because we used fake_fez): 0.0
  Gates fidelity measured during the experiment: {'CZ': 0.9953704216147041, 'ID1Q': 0.9991834123567518}
  Total shots: 446000
  Number of shots used for mitigation: 194000
  Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 32.52745003718883, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 257.850521848537, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
Dans metadata["results"], les résultats sont regroupés d'abord par instance de circuit, puis par observable.
print("Full QESEM mitigation results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")

    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata.get("noisy_results")
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")

    print("  Transpiled circuits:")
    for circ_idx, transpiled_circ in enumerate(
        pub_result.metadata["transpiled_circs"]
    ):
        print(f"    Circuit {circ_idx}:")
        # print(f"      Circuit: \n {transpiled_circ['circuit']}") # not printing it because it's long but you can see the transpiled circuit itself
        print(f"      Qubit mapping: {transpiled_circ['qubit_maps']}")
        print(
            f"      Measurement bases: {transpiled_circ['num_measurement_bases']}"
        )

    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Full QESEM mitigation results:

PUB 0:
  Mitigated expectation values: [1.00648343 1.00636289]
  Mitigated error bars: [0.00253812 0.00693586]
  Unmitigated expectation values: [0.98031429 0.96357143]
  Unmitigated error bars: [0.00124128 0.00578812]
  Transpiled circuits:
    Circuit 0:
      Qubit mapping: [[[0, 140], [1, 141], [2, 142], [3, 143], [4, 136]]]
      Measurement bases: 2
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 1.0064834305181962 ± 0.002538119914534849
        Unmitigated value: 0.9803142857142859 ± 0.0012412835813609938
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0063628870614818 ± 0.006935859820870656
        Unmitigated value: 0.9635714285714285 ± 0.005788121870526659
Répartition des principaux résultats :
mitigated: la valeur d'espérance QESEM entièrement atténuée.unmitigated: le résultat brut de bruit physique, sans atténuation d'erreurs.
Résultats d'extrapolation heuristique QESEM
Dans une exécution QESEM standard avec un seul flottant precision, les résultats incluent également des points de mise à l'échelle du bruit automatiquement disponibles, utilisés pour l'heuristique QESEM. Ces points sont calculés sans ressources QPU supplémentaires.
L'échelle 1.0 représente le niveau de bruit du dispositif physique avec atténuation de la lecture (REM), tandis que l'échelle 2.0 est le point complémentaire à bruit amplifié, également avec REM. Ces points sont utilisés pour produire le résultat qesem_heuristic.
-
qesem_heuristic: une estimation de type ZNE calculée à partir des données à bruit mis à l'échelle disponibles. Actuellement, cette méthode utilise l'extrapolation exponentielle. -
noise_scaling.results_with_REM: valeurs d'espérance à différentes échelles de bruit, toutes avec atténuation de la lecture (REM).
Un détail subtil mais important est que le résultat à l'échelle 1.0 n'est pas identique au résultat unmitigated. Les deux correspondent au niveau de bruit du dispositif physique, mais le point à l'échelle 1.0 inclut l'atténuation de la lecture, tandis que unmitigated ne l'inclut pas.
print("QESEM heuristic results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"  Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"    Observable {obs_idx}: {obs_array}")
            qesem_heuristic = result_dict["qesem_heuristic"][0]
            print("      QESEM heuristic:")
            print(
                f"        Value: {qesem_heuristic['value']} ± {qesem_heuristic['error_bar']}"
            )
            print(
                f"        Extrapolation: {qesem_heuristic['extrapolation']}"
            )
            print(
                f"        Scale factors: {qesem_heuristic['scale_factors']}"
            )
            noise_scaling = result_dict["noise_scaling"]
            print("      Noise scaling results:")
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QESEM heuristic results:

PUB 0:
  Circuit 0:
    Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
      QESEM heuristic:
        Value: 1.0008161638888535 ± 0.0038859458884403964
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9918395459270772 ± 0.0012565417579355634
          Scale factor 2.0: 0.982943441922748 ± 0.0028919278067695018
    Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
      QESEM heuristic:
        Value: 0.9960853148925298 ± 0.013811635038961175
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9902860583785115 ± 0.005921236914723409
          Scale factor 2.0: 0.984520565414274 ± 0.006909522262347639
Les exemples suivants se concentrent sur les entrées et résultats spécifiques à la fonctionnalité, ils n'affichent donc pas les métriques d'exécution complètes à chaque fois. Les métadonnées de haut niveau présentées précédemment, telles que total_qpu_time, gate_fidelities, total_shots, mitigation_shots, et resource_usage, sont également disponibles pour ces jobs.
Certaines variables des exemples précédents, y compris le backend, les observables et les paramètres du circuit de base, sont réutilisées ci-dessous par souci de concision.
Tous les exemples suivants peuvent également être exécutés avec une estimation empirique du temps. Pour l'activer, passe "estimate_time_only": "empirical" dans les options de la fonction.
Exemple de circuit paramétré
De nombreux algorithmes évaluent le même circuit à plusieurs valeurs de paramètres. Envoyer le circuit paramétré comme un seul job QESEM permet à QESEM de partager la caractérisation et la calibration entre les instances de circuit, ce qui peut réduire le surcoût en temps QPU par rapport à l'exécution de jobs séparés.
Soumettre un circuit paramétré nécessite d'utiliser le niveau de transpilation "minimal_with_layout_opt".
Les circuits soumis à ce niveau doivent déjà être exprimés à l'aide des portes de base du backend, selon le backend. À ce niveau, QESEM conserve la structure soumise aussi proche que possible du circuit d'entrée, respecte les barrières lors de la layerification (regroupement des opérations en couches de portes à deux qubits parallèles), et gère toujours automatiquement la correspondance matérielle avec des qubits haute fidélité et la connectivité de l'appareil.
En pratique, cela signifie que tu devrais transpiler les circuits vers les portes de base du backend cible avant la soumission. Un exemple simple de transpilation de portes de base est présenté ci-dessous.
QESEM ne prend actuellement en charge qu'un seul observable par ensemble de paramètres. Les deux lignes de paramètres ci-dessous sont associées (zip) aux deux observables : la première ligne est mesurée avec avg_magnetization, et la seconde avec other_observable.
# Transpile to the backend basis gates only. With minimal_with_layout_opt, QESEM handles hardware mapping/connectivity and observable layout internally.
from qiskit_ibm_runtime.fake_provider import FakeFez

backend = FakeFez()
basis = backend.operation_names
print(basis)

param0 = qiskit.circuit.Parameter("param0")
param1 = qiskit.circuit.Parameter("param1")
parametrized_circ = qiskit.QuantumCircuit(5)
parametrized_circ.rx(param0, 0)
parametrized_circ.rx(param1, 1)
parametrized_circ.cx(0, 1)
parametrized_circ.cx(2, 3)
parametrized_circ.cx(1, 2)
parametrized_circ.cx(3, 4)

parametrized_circ = qiskit.transpile(
    parametrized_circ, basis_gates=basis, optimization_level=1
)
parametrized_parameter_values = [[0.5, 0.1], [0.0, 0.6]]
parametrized_observables = [avg_magnetization, other_observable]

parametrized_job = qesem_function.run(
    pubs=[
        (
            parametrized_circ,
            parametrized_observables,
            parametrized_parameter_values,
            0.1,
        )
    ],
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
    },
)
print(parametrized_job.job_id)
print(parametrized_job.status())
d1b0e29b-196c-4896-aec6-44a268ebd874
DONE
parametrized_result = parametrized_job.result()
print("Parameterized circuit QESEM results:")

for pub_idx, pub_result in enumerate(parametrized_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each parameter value:")
    for param_idx, param_results in enumerate(pub_result.metadata["results"]):
        print(
            f"    Parameter set {param_idx}: {parametrized_parameter_values[param_idx]}"
        )
        for obs_idx, (obs_array, result_dict) in enumerate(param_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Parameterized circuit QESEM results:

PUB 0:
  Mitigated expectation values: [0.92392021 0.82517653]
  Mitigated error bars: [0.00565281 0.00616016]
  Unmitigated expectation values: [0.9028     0.78771429]
  Unmitigated error bars: [0.00335142 0.00925413]
  Results for each parameter value:
    Parameter set 0: [0.5, 0.1]
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.923920210615709 ± 0.005652811570890183
        Unmitigated value: 0.9028 ± 0.0033514176105045447
    Parameter set 1: [0.0, 0.6]
      Observable 0: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 0.8251765289285893 ± 0.006160161743353999
        Unmitigated value: 0.7877142857142858 ± 0.009254130564027902
Exemple multi-pub
L'exécution multi-pub est utile lorsque tu veux exécuter plusieurs circuits liés en un seul job QESEM. Comme l'exécution paramétrée, cela peut réduire le surcoût, car QESEM peut partager la caractérisation et la calibration entre les instances de circuit au lieu de la répéter dans des jobs séparés.
Cela est particulièrement utile pour les circuits ayant une structure de couches partagée, tels que les charges de travail de type Trotter, où différents circuits réutilisent les mêmes couches uniques. Dans ce cas, les exécuter ensemble peut réduire le coût de caractérisation par rapport à des jobs QESEM indépendants.
Les jobs multi-pub nécessitent "transpilation_level": "minimal_with_layout_opt". Comme dans l'exemple paramétré, les circuits doivent être transpilés vers les portes de base du backend cible avant la soumission. QESEM gère ensuite en interne la connectivité de l'appareil, la disposition et la correspondance avec des qubits haute fidélité.
Chaque PUB ci-dessous contient un circuit et les deux mêmes observables utilisés précédemment dans le notebook, de sorte que le PrimitiveResult renvoyé contient un PubResult par circuit d'entrée.
L'exemple ci-dessous utilise deux circuits Trotter simples avec le même motif de couches : circ_a a une couche Trotter, et circ_b répète le même motif de couches deux fois. Cela rend la structure partagée explicite.
def make_trotter_circuit(num_qubits, num_layers, zz_angle=0.2, x_angle=0.1):
    trotter_circ = qiskit.QuantumCircuit(num_qubits)
    for _ in range(num_layers):
        for q in range(num_qubits):
            trotter_circ.rx(x_angle, q)
        trotter_circ.barrier()
        for q in range(0, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
        for q in range(1, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
    return trotter_circ

circ_a = make_trotter_circuit(num_qubits=5, num_layers=1)
circ_b = make_trotter_circuit(num_qubits=5, num_layers=2)
multi_pubs = [
    (
        qiskit.transpile(qci, basis_gates=basis, optimization_level=1),
        [avg_magnetization, other_observable],
    )
    for qci in [circ_a, circ_b]
]

multi_circ_job = qesem_function.run(
    pubs=multi_pubs,
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
        "default_precision": 0.1,
    },
)
print(multi_circ_job.job_id)
print(multi_circ_job.status())
e34565b8-7262-4133-a120-de42ce624a99
DONE
multi_circ_result = multi_circ_job.result()
print("Multi-pub QESEM results:")

for pub_idx, pub_result in enumerate(multi_circ_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Multi-pub QESEM results:

PUB 0:
  Mitigated expectation values: [0.99502406 1.02209332]
  Mitigated error bars: [0.00483819 0.00707488]
  Unmitigated expectation values: [0.96934286 0.97271429]
  Unmitigated error bars: [0.00124855 0.00617294]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.9950240647925642 ± 0.004838188086259301
        Unmitigated value: 0.9693428571428573 ± 0.0012485470362492692
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0220933230604674 ± 0.007074884384355636
        Unmitigated value: 0.9727142857142859 ± 0.006172939375512439

PUB 1:
  Mitigated expectation values: [0.98850017 1.02555188]
  Mitigated error bars: [0.0077912  0.01672652]
  Unmitigated expectation values: [0.93682857 0.95371429]
  Unmitigated error bars: [0.00156245 0.00665735]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.988500171577252 ± 0.007791203181151346
        Unmitigated value: 0.9368285714285716 ± 0.001562451883089579
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.02555188098689 ± 0.016726524388086233
        Unmitigated value: 0.9537142857142858 ± 0.006657345655544263
Exemple de réglage quasi-probabiliste des erreurs (QET)
Le réglage quasi-probabiliste des erreurs (QET) demande des valeurs d'espérance à des facteurs d'échelle de bruit sélectionnés. Cela est utile pour les études personnalisées de mise à l'échelle du bruit et les flux de travail d'extrapolation à bruit nul (Zero-Noise Extrapolation). L'échelle 1.0 correspond au niveau de bruit physique, les valeurs entre 0.0 et 1.0 réduisent partiellement le bruit, et les valeurs supérieures à 1.0 amplifient le bruit.
Pour utiliser QET avec la Qiskit Function, transmets un dictionnaire comme précision du PUB. Le dictionnaire associe chaque échelle de bruit demandée à sa précision cible. Les résultats des facteurs d'échelle renvoyés sont stockés dans noise_scaling.results_with_REM et incluent l'atténuation de la lecture. Le point à l'échelle 1.0 n'est donc pas identique à la valeur non atténuée, car 1.0 inclut l'atténuation de la lecture alors que unmitigated ne l'inclut pas.
Lorsqu'une échelle est demandée, QESEM renvoie également l'échelle complémentaire autour de 1.0 sans utilisation supplémentaire du QPU. Par exemple, demander 0.5 peut aussi renvoyer 1.5, et demander 1.3 peut aussi renvoyer 0.7. La précision sur l'échelle complémentaire n'est pas garantie.
noise_scale_precision = {0.5: 0.15, 1.3: 0.2}

qet_job = qesem_function.run(
    pubs=[
        (
            circ,
            [avg_magnetization, other_observable],
            None,
            noise_scale_precision,
        )
    ],
    backend_name=backend_name,
    options={"max_execution_time": 300},
)
print(qet_job.job_id)
print(qet_job.status())
8195fa58-f037-4651-8715-36ce1cdc5521
DONE
qet_result = qet_job.result()
print("QET noise-scaling results:")

for pub_idx, pub_result in enumerate(qet_result):
    print(f"\nPUB {pub_idx}:")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            noise_scaling = result_dict["noise_scaling"]
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QET noise-scaling results:

PUB 0:
  Unmitigated expectation values: [0.97822857 0.96171429]
  Unmitigated error bars: [0.00123812 0.00672958]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 0.9938730340199383 ± 0.0032116907357568275
          Scale factor 0.7: 0.9963976191853445 ± 0.00036300258869586616
          Scale factor 1.0: 0.9898115079506586 ± 0.0012525947426560995
          Scale factor 1.3: 0.9864667065580341 ± 0.002633221613518526
          Scale factor 1.5: 0.9838755527197551 ± 0.002948417797996015
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 1.0006538544450332 ± 0.002121742014777343
          Scale factor 0.7: 1.0004159801523036 ± 0.0021671375357823794
          Scale factor 1.0: 0.9898058846339917 ± 0.00690183710903159
          Scale factor 1.3: 0.9948946719997267 ± 0.002146532859610311
          Scale factor 1.5: 0.9927220368192772 ± 0.0020875057190323882
Récupérer les messages d'erreur
Si le statut de ta charge de travail est ERROR, utilise job.result() pour récupérer le message d'erreur comme suit :
# Get the result and truncate for readability
result = sample_job.result()
result_str = str(result)
max_length = 500  # Adjust this value as necessary

if len(result_str) > max_length:
    truncated = (
        result_str[:max_length]
        + f"... (truncated {len(result_str) - max_length} characters)"
    )
else:
    truncated = result_str

print(truncated)
PrimitiveResult([PubResult(data=DataBin(evs=np.ndarray(<shape=(2,), dtype=float64>), stds=np.ndarray(<shape=(2,), dtype=float64>), shape=(2,)), metadata={'gate_fidelities': {'CZ': 0.9979444718552628, 'ID1Q': 0.9991994239814883}, 'total_shots': 498600, 'mitigation_shots': 223400, 'transpiled_circs': [{'circuit': 'OPENQASM 3.0;\ninclude "stdgates.inc";\nbit[76] c0;\nqubit[76] q0;\nrx(0) q0[54];\nrx(0) q0[59];\nrx(0) q0[75];\nrz(pi/2) q0[54];\nrz(pi/2) q0[59];\nrz(pi/2) q0[75];\nrx(pi/2) q0[54];\nr... (truncated 3771 characters)
Obtenir de l'aide
L'équipe de support Qedma est là pour t'aider ! Si tu rencontres des problèmes ou si tu as des questions sur l'utilisation de la Qiskit Function QESEM, n'hésite pas à nous contacter. Notre équipe de support qualifiée et disponible est prête à t'aider pour toute question technique ou toute demande d'information.
Tu peux nous envoyer un e-mail à support@qedma.com pour obtenir de l'aide. Merci d'inclure autant de détails que possible sur le problème que tu rencontres afin que nous puissions te fournir une réponse rapide et précise. Tu peux également contacter ton représentant POC Qedma dédié par e-mail ou par téléphone.
Pour nous aider à te répondre plus efficacement, veille à nous fournir les informations suivantes lorsque tu nous contactes :
-
Une description détaillée du problème
-
L'identifiant du job
-
Tout message d'erreur ou code pertinent
Nous nous engageons à te fournir un support rapide et efficace pour t'assurer la meilleure expérience possible avec notre Qiskit Function.
Nous cherchons toujours à améliorer notre produit et nous accueillons volontiers tes suggestions ! Si tu as des idées sur la façon dont nous pourrions améliorer nos services ou des fonctionnalités que tu aimerais voir, envoie-nous tes suggestions à support@qedma.com.
Étapes suivantes
-
Consulter la référence API pour cette Qiskit Function.
-
Essaie le tutoriel Simuler le modèle d'Ising à champ incliné en 2D avec la fonction QESEM.