Mitigation d'erreurs
Cette leçon présente le contexte de diverses techniques de mitigation d'erreurs afin d'aider les utilisateurs à développer une intuition de la manière et du moment où elles sont le plus utiles. Il est important de noter que les applications modernes de ces techniques s'appuieront sur des outils plus sophistiqués, comme Samplomatic, Shaded Lightcones et Executor. Ces workflows seront abordés dans des leçons ultérieures.
Cette vidéo donne un aperçu des techniques de mitigation d'erreurs. Le texte ci-dessous ajoute des détails et explore ces méthodes avec Qiskit.
Aperçu des techniques de mitigation d'erreurs
La mitigation d'erreurs désigne tout processus qui tente de réduire les effets des erreurs dans les calculs quantiques après qu'elles se sont produites. Elle diffère de la suppression, qui tente d'empêcher les erreurs, et de la correction d'erreurs, qui encode l'information sur de nombreux qubits physiques et vérifie la cohérence de cette information pour la préserver dans un seul qubit logique. Tout au long de cette leçon, les techniques de mitigation d'erreurs se comprennent au mieux comme des méthodes pour construire de meilleurs estimateurs des valeurs moyennes idéales ou de meilleurs échantillonneurs de distributions de probabilité, et non comme des méthodes de correction des états quantiques pendant l'exécution. Nous examinerons ci-dessous les méthodes de mitigation d'erreurs, toutes disponibles dans Qiskit et ses addons, et qui sont des outils prometteurs dans la quête de l'avantage quantique.
L'extinction des erreurs de lecture par twirling (TREX) rend le processus de mesure aléatoire en appliquant des opérations de Pauli choisies au hasard avant la mesure, puis en annulant classiquement leurs effets connus sur les chaînes de bits observées. Sous des hypothèses adéquates sur le bruit de mesure, cela convertit le canal d'erreur de lecture en une forme plus simple et plus symétrique, plus facile à calibrer et à mitiger.
La mitigation des mesures sans matrice (M3) est une technique de mitigation des erreurs de mesure évolutive qui évite de construire explicitement la matrice d'assignation ou son inverse.
L'extrapolation à bruit nul (ZNE) approxime la valeur qu'aurait une observable en l'absence de bruit en amplifiant artificiellement le bruit d'un facteur connu, puis en extrapolant vers le cas sans bruit. Cela exige que le bruit évolue de manière prévisible. Cette prévisibilité peut nécessiter d'autres méthodes abordées dans cette leçon (étirement d'impulsions, repliement de portes et amplification probabiliste des erreurs (PEA)).
L'annulation probabiliste des erreurs (PEC) est l'une des techniques de mitigation d'erreurs les plus puissantes, mais aussi les plus coûteuses en calcul. Elle apprend le comportement du bruit du système et tente de l'annuler en construisant statistiquement une estimation non biaisée du calcul idéal. La PEC produit des observables corrigées statistiquement, et non des résultats corrigés d'erreurs.
Nous allons maintenant approfondir chacune de ces méthodes.
M3
Les erreurs de mesure sont l'une des sources de bruit les plus persistantes et les plus spécifiques au matériel dans les appareils quantiques à court terme. Même lorsqu'un état quantique est préparé et évolue correctement, l'étape finale de lecture peut rapporter de façon erronée le véritable résultat de la base computationnelle. Ces erreurs proviennent d'une discrimination imparfaite entre les états physiques correspondant à et , de la relaxation pendant la mesure et d'imperfections de l'électronique de mesure. En conséquence, la distribution observée de chaînes de bits est souvent une version déformée de la vraie distribution (idéale), avec une probabilité réattribuée à tort entre les résultats.
La mitigation des mesures traite ce problème en modélisant explicitement la façon dont les résultats de mesure sont mal assignés. Dans la formulation standard, ce comportement est capturé par une matrice d'assignation , dont les éléments représentent la probabilité d'enregistrer le résultat alors que l'état de base réel était . Si le bruit de mesure est classique et stationnaire, le vecteur de probabilités observé est relié à la distribution idéale par une simple relation linéaire,
Note que la matrice d'assignation est une application stochastique classique, et non un canal quantique. Elle agit sur des lectures classiques, et non sur les états quantiques sous-jacents qui ont été échantillonnés pour obtenir ces lectures.
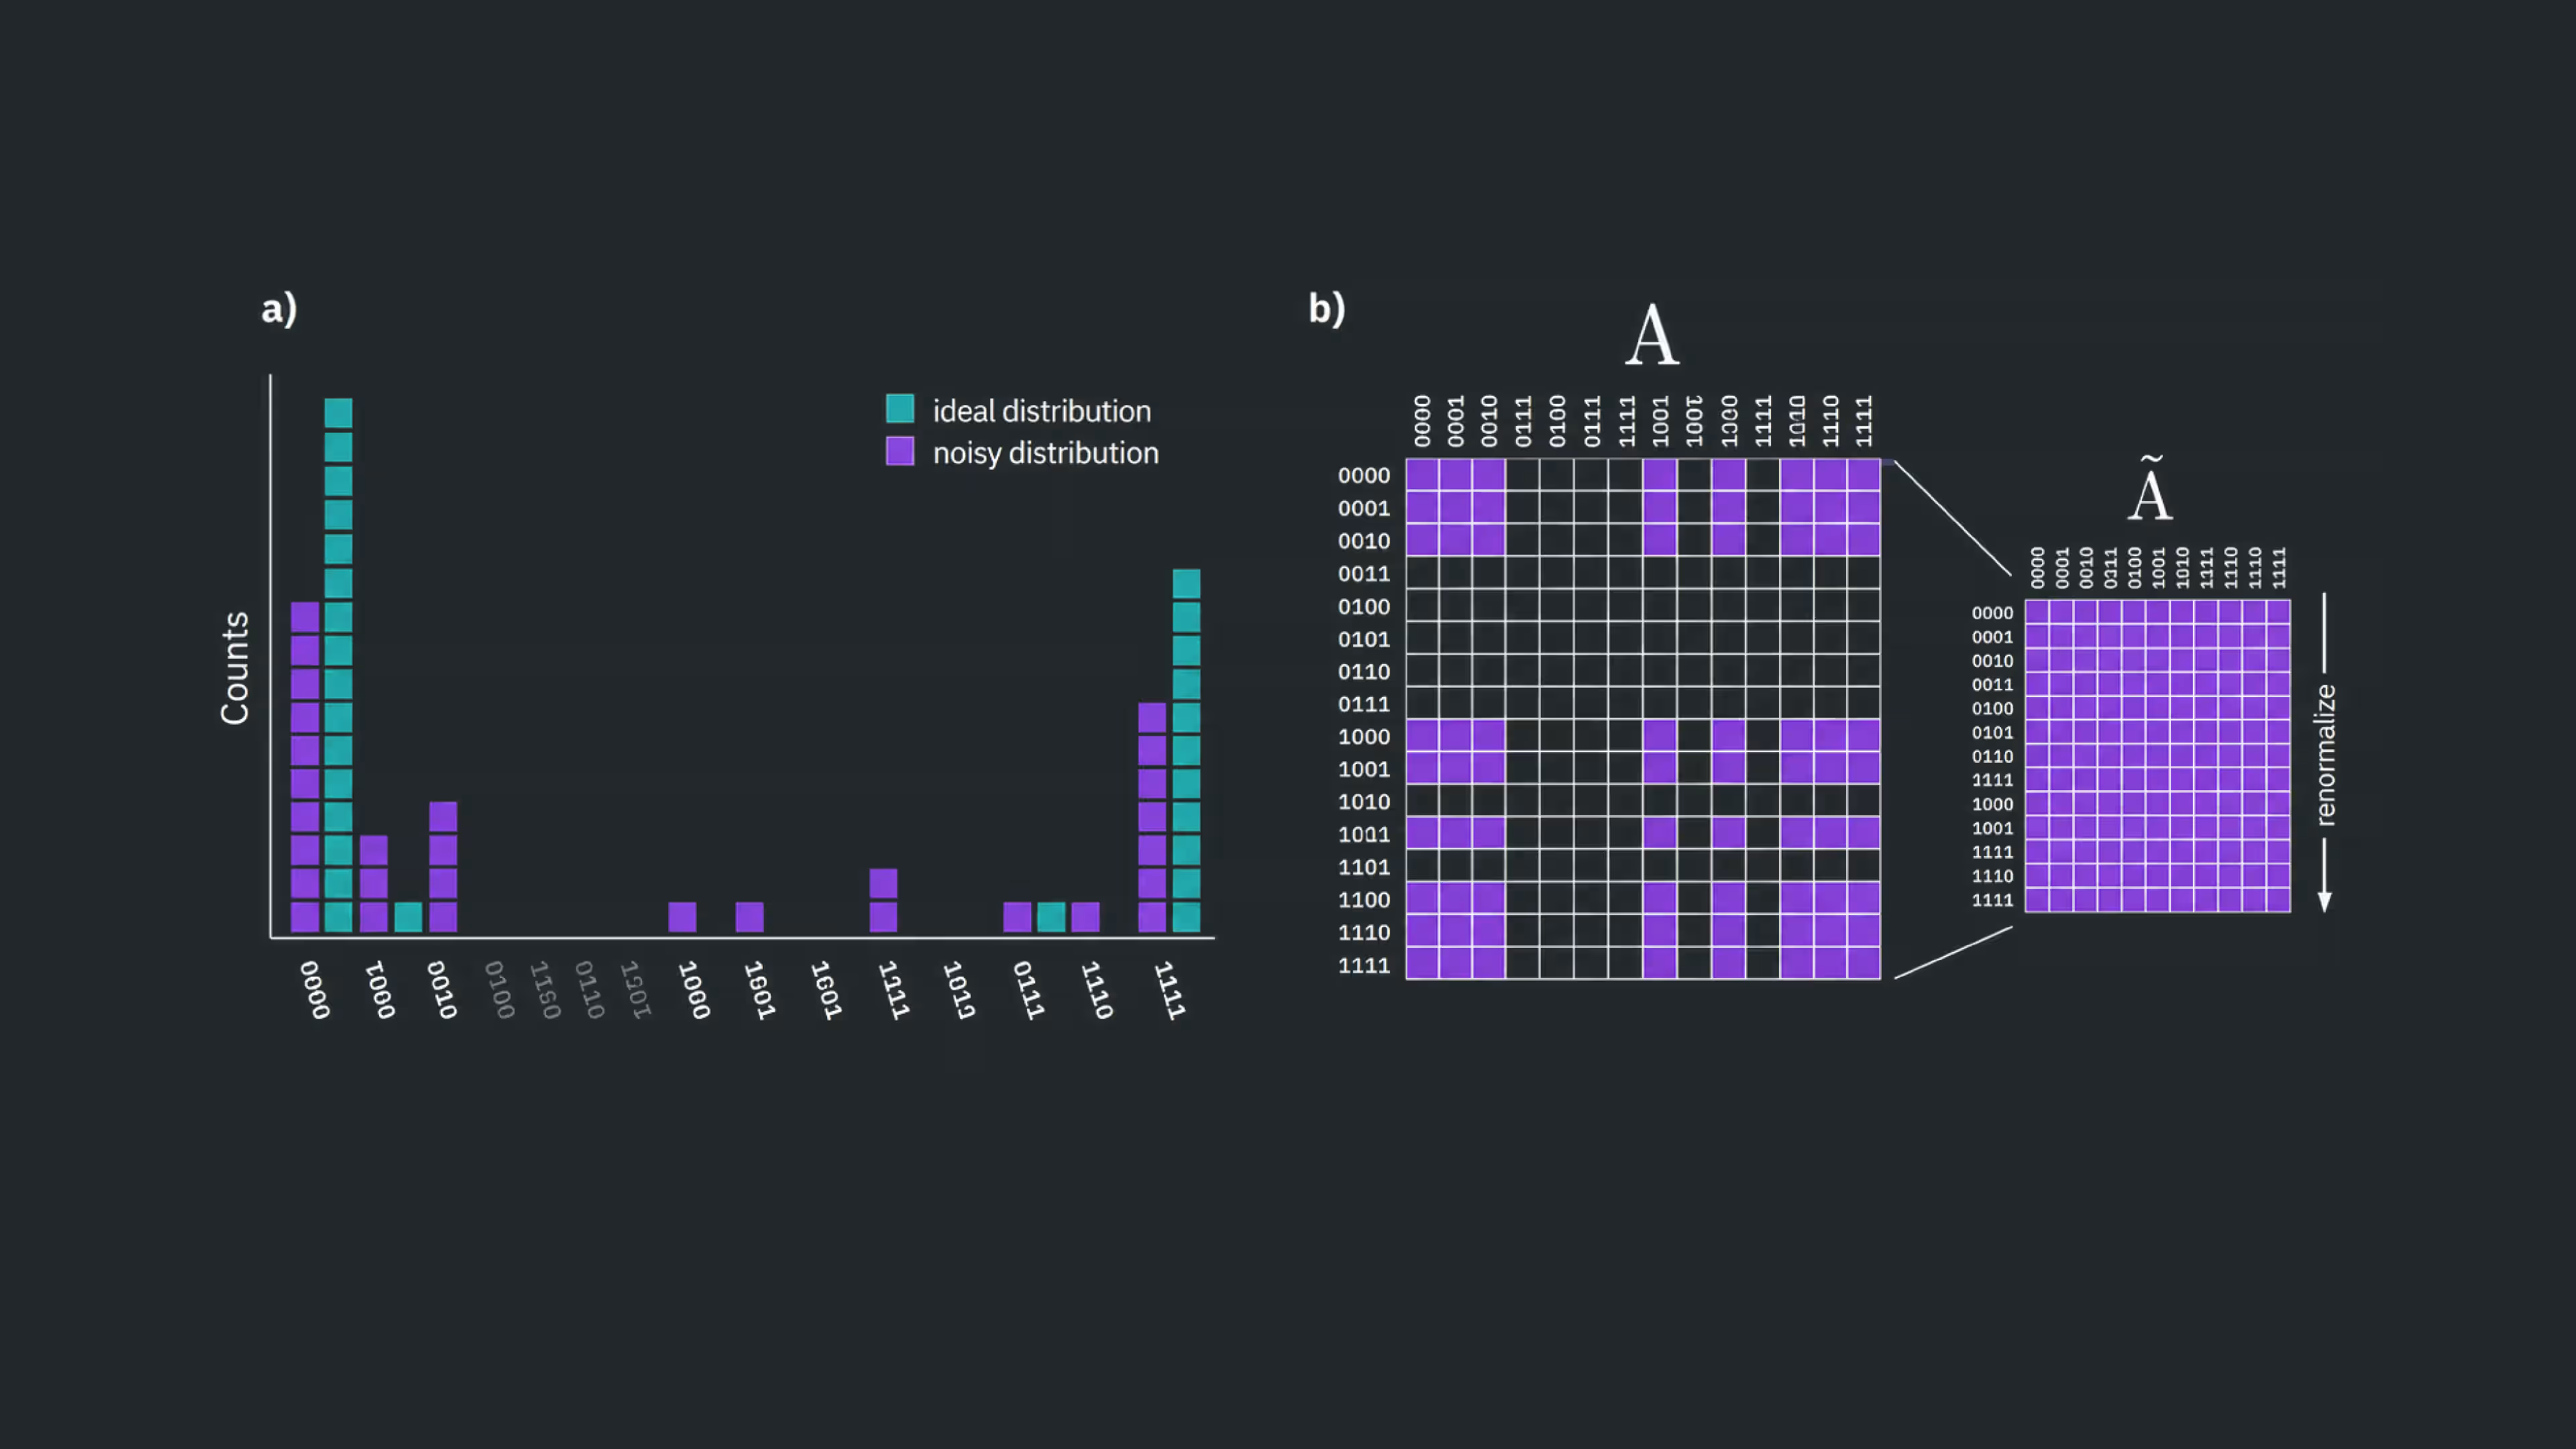
La mitigation des mesures sans matrice (M3) utilise cette structure pour construire une estimation mitigée de sans jamais former ni inverser la matrice complète , ce qui serait irréalisable pour un grand nombre de qubits. À la place, M3 exploite le fait que de nombreuses charges de travail quantiques à court terme produisent des distributions très piquées ou de faible entropie, de sorte que la mitigation se concentre uniquement sur le sous-ensemble de résultats qui contribuent de manière significative à la distribution observée.
Pour construire le modèle d'assignation, des expériences de calibration supplémentaires doivent être exécutées sur le matériel quantique. Elles consistent généralement à préparer des états connus de la base computationnelle et à enregistrer la façon dont le système de mesure les rapporte. Le surcoût de calibration croît avec le nombre de qubits mesurés, tandis que le coût de calcul de la mitigation dépend de la structure de la distribution observée. Ce coût est bien inférieur à celui qu'exigerait la caractérisation explicite de la matrice d'assignation complète . Bien que ce surcoût de calibration soit réel, il est léger par rapport aux techniques au niveau du circuit comme l'extrapolation à bruit nul ou l'annulation probabiliste des erreurs, ce qui fait de M3 un outil pratique et largement utilisé pour mitiger les erreurs de lecture dans les expériences quantiques à court terme.
Note que la calibration n'est utile que dans la mesure où le processus de mesure reste suffisamment stable entre les exécutions de calibration et l'expérience cible.
Nous allons d'abord traiter un cas simple à la main pour illustrer son fonctionnement, puis utiliser les outils intégrés à Qiskit pour montrer l'utilisation de M3 à une échelle plus réaliste.
Petit exemple M3
Nous commençons par construire un simple état de Bell.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Nous pouvons utiliser un simulateur avec un modèle de bruit, car nous limitons cet exemple à un très petit circuit. Nous configurons explicitement notre modèle de bruit avec une erreur de lecture de la forme :
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Ces taux d'erreur de lecture sont bien plus élevés que ceux observés sur les véritables ordinateurs quantiques IBM®. Ces valeurs élevées ont été choisies à des fins pédagogiques, afin que nous puissions voir clairement l'effet de M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Nous pouvons exécuter le circuit sur le simulateur bruité pour observer les effets de l'erreur de lecture.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
Dans notre exemple jouet, nous avons défini l'erreur de lecture pour notre modèle de bruit. Mais avec un véritable ordinateur quantique, l'erreur de lecture n'est pas connue a priori. Elle doit être estimée expérimentalement. Pour cela, nous créons des circuits qui préparent un qubit dans un état connu de la base computationnelle, ou , puis le mesurent. En l'absence d'erreur de lecture, nous mesurerions exactement l'état préparé. En collectant des statistiques à partir de ces mesures, nous pouvons construire une matrice d'assignation décrivant l'erreur de lecture. Dans cet exemple jouet, elle devrait ressembler à celle que nous avons définie.
Pour un système plus réaliste, il faudrait accumuler des statistiques pour chaque qubit physique. Ce n'est parfois pas trivial, car la transpilation fait correspondre un circuit abstrait au matériel et le numéro du qubit change. Nous y reviendrons dans l'exemple suivant. Dans cet exemple de simulateur, nous avons assigné le même modèle d'erreur de lecture à chaque qubit, donc une seule caractérisation suffit.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Note que cela est très proche de la matrice d'erreur de lecture utilisée pour construire le simulateur.
Encore une fois, sur un véritable ordinateur quantique, nous aurions des statistiques de ce type pour plusieurs qubits physiques. Pour ce simulateur, nous supposons que les deux qubits ont des erreurs de lecture identiques et indépendantes, ce qui nous permet de construire la matrice d'assignation à deux qubits A_2q comme un produit tensoriel des matrices à un qubit correspondantes. Note également que le but de M3 n'est pas de construire la matrice d'assignation entière. M3 se concentre plutôt sur le sous-ensemble de résultats qui contribuent de manière significative à la distribution observée. Nous construirons la matrice entière pour notre très petit exemple afin de voir comment cela fonctionne. L'implémentation de M3 dans qiskit-ibm-runtime est plus sophistiquée que cet exemple jouet, car elle doit gérer de nombreux qubits aux caractéristiques de lecture distinctes tout en évitant de construire la matrice d'assignation complète.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
Pour cet exemple, nous supposons que les erreurs de lecture sur différents qubits sont indépendantes, ce qui permet de construire la matrice d'assignation à deux qubits comme un produit tensoriel des matrices à un qubit correspondantes.
Nous obtenons les résultats bruts et mitigés pour les comparer.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
À ce stade, nous avons caractérisé expérimentalement la façon dont le processus de mesure déforme les probabilités des résultats idéaux. Notre objectif est maintenant d'annuler cette déformation et d'appliquer la correction obtenue aux probabilités brutes.
Comme nous effectuons une inversion linéaire plutôt qu'une correction physique, les « probabilités » obtenues ne sont pas toujours nécessairement positives. De très petites quasi-probabilités négatives sont attendues et reflètent le fait que la mitigation des mesures produit un estimateur plutôt qu'une distribution de probabilité physique.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Nous les convertissons en comptages pour le tracé.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Enfin, nous examinons les distributions brute, mitigée et idéale. Les « comptages » mitigés ci-dessous ne sont qu'une aide à la visualisation obtenue en remettant à l'échelle les quasi-probabilités mitigées.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
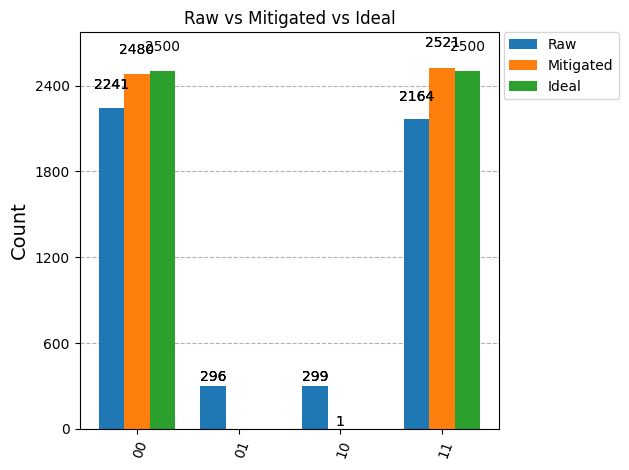
Clairement, les résultats mitigés par M3 sont beaucoup plus proches des distributions idéales, et nous pouvons voir pourquoi.
Appliquer M3 à des workflows plus réalistes est bien plus complexe. Considère :
- Les véritables ordinateurs quantiques contiennent de nombreux qubits physiques, chacun avec ses propres caractéristiques d'erreur de lecture. Ces erreurs doivent être modélisées et combinées de manière appropriée.
- La matrice d'assignation complète croît exponentiellement avec le nombre de qubits et devient rapidement impraticable à construire explicitement. C'est pourquoi M3 se concentre sur le sous-ensemble de résultats qui contribuent de manière significative à la distribution observée plutôt que de construire la matrice d'assignation entière.
- Pour les problèmes réels qui nous intéressent, la distribution idéale peut ne pas être connue.
Pour toutes ces raisons, le workflow de mitigation complet est encapsulé dans l'addon Qiskit mthree.
Exemple M3 plus grand
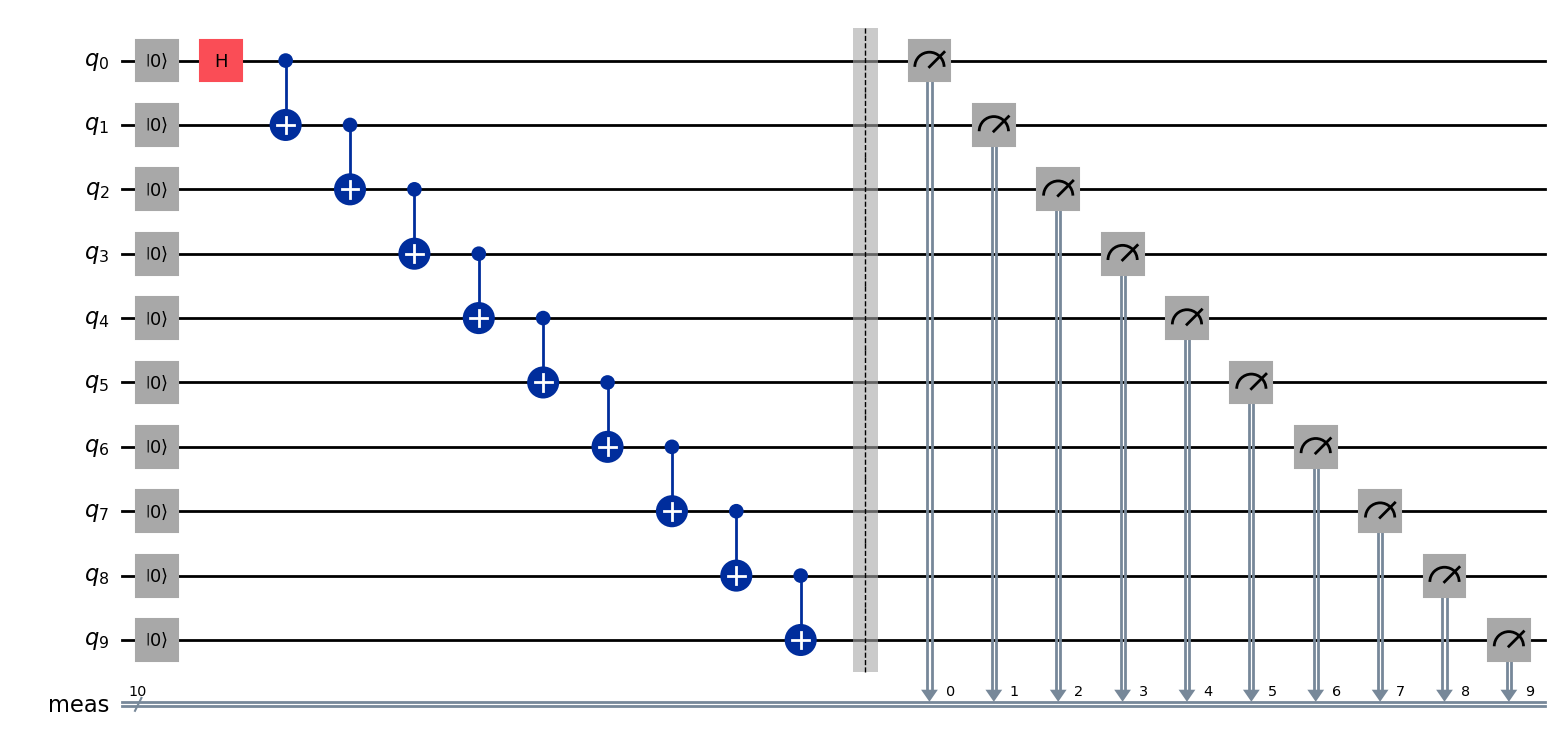
Nous appliquons maintenant M3 à un circuit plus grand, pour lequel déterminer à la main le sous-espace pertinent de serait fastidieux, mais qui reste assez simple pour que nous connaissions la distribution idéale : un état GHZ. Nous commençons par importer le paquet mthree et définir un circuit quantique GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
Pour l'exécuter sur un véritable ordinateur quantique, nous importons qiskit_ibm_runtime et d'autres paquets nécessaires. Nous utilisons SamplerV2 pour obtenir une distribution des sorties.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Nous transpilons maintenant le circuit pour notre Backend. Nous fixons ici le niveau d'optimisation à 0 afin de nous concentrer sur les effets de M3, sans ajouter d'outils supplémentaires. Cela signifie que la fidélité finale ne sera pas représentative de ce qui est réalisable sur le matériel IBM Quantum® avec l'ensemble complet des outils disponibles, mais cela nous permet de nous concentrer précisément sur l'utilité de M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Nous configurons maintenant le Sampler, en désactivant à nouveau les techniques supplémentaires de suppression d'erreurs telles que le découplage dynamique et le twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Enfin, nous exécutons notre job.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Nous pouvons extraire les comptages bruts du circuit ci-dessus.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Nous exécutons maintenant mthree sur notre Backend pour caractériser le modèle d'assignation utilisé pour la mitigation des mesures. Nous remettons à l'échelle la distribution brute à l'aide de cette information. Note que cela peut parfois produire de très petites probabilités négatives (d'où le terme quasi-probabilités).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
La correction mthree produit des quasi-probabilités plutôt que des comptages. Nous pouvons les remettre à l'échelle en comptages à la main. La fonction utilitaire ci-dessous convertit en comptages et arrondit à des valeurs entières. De plus, pour les grands circuits, il y aura de nombreuses chaînes erronées avec très peu de comptages, mais qui encombrent un histogramme. La seconde fonction utilitaire ci-dessous élimine toutes les chaînes ayant moins de comptages qu'un seuil que nous choisissons, afin de nous donner une vue claire des termes dominants de la distribution.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Nous pouvons aussi produire facilement la distribution théorique idéale, dans laquelle les états tout-zéro et tout-un ont des probabilités égales et tous les autres résultats une probabilité nulle, pour comparaison.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Enfin, nous pouvons visualiser nos résultats.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
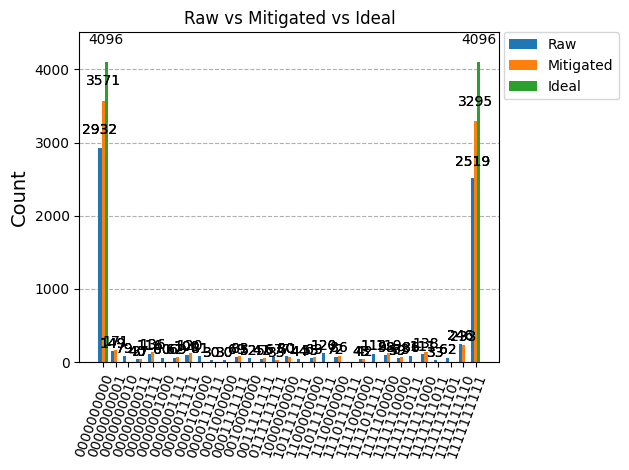
Les résultats mitigés sont plus proches de la distribution idéale que les résultats non mitigés. Nous pouvons mieux le quantifier en utilisant les comptages des chaînes de bits idéales.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Cet outil simple a amélioré notre fidélité de 26 % par rapport à la fidélité non mitigée, avec un surcoût assez faible. M3 peut clairement être très précieux. Mais le circuit GHZ a été choisi comme bon cas d'usage, car il est très piqué sur deux états de sortie. Certains problèmes donnent des comptages plus uniformément répartis (états à haute entropie). Pour des circuits très profonds avec de nombreux qubits, les erreurs de portes et le bruit non liés aux erreurs de mesure conduiront souvent à un état à haute entropie. Dans de tels cas, M3 opère sur un espace d'états assez grand. Il y a trois approches possibles :
(1) Accepter qu'il s'agit d'une limite de M3.
(2) Note que la borne supérieure de l'espace de la matrice formée par M3 est num_shots num_shots, plutôt que , la première étant beaucoup plus petite pour un grand nombre de qubits .
(3) Avec une grande prudence seulement, supprimer les chaînes de bits de très faible probabilité des comptages bruts fournis à M3. Cela peut introduire un biais, et la limitation du support de tes états peut gêner la convergence dans des approches comme la méthode de Krylov. Cela ne doit être fait que lorsque tu sais exactement pourquoi tu le fais et peux anticiper tous ses effets. C'est pourquoi un tel élagage n'est pas une fonctionnalité intégrée de M3.
Pour en savoir plus sur l'addon Qiskit mthree, consulte des exemples, les instructions d'installation, le contexte et les références d'API dans sa documentation.
Extinction des erreurs de lecture par twirling (TREX)
L'extinction des erreurs de lecture par twirling (TREX) est une technique de mitigation des erreurs de mesure utilisée sur les ordinateurs quantiques modernes. Son objectif est de supprimer le biais introduit par les erreurs de lecture classiques sans exiger la caractérisation complète ni l'inversion de la matrice d'assignation des mesures.
TREX n'est pas une correction d'erreurs et n'améliore pas la fidélité de l'état. Elle garantit plutôt que les estimateurs de valeurs moyennes sont non biaisés vis-à-vis du bruit de lecture, à l'erreur statistique près, en moyennant sur des bases de mesure aléatoires et en remettant à l'échelle. Sur le matériel IBM Quantum, TREX est la méthode de mitigation par défaut pour l'estimation de valeurs moyennes et correspond à resilience_level = 1 dans la primitive Estimator d'IBM Quantum.
Nature des erreurs de lecture sur le matériel supraconducteur
Sur les qubits supraconducteurs d'IBM, les erreurs de lecture sont dominées par :
-
Des probabilités de basculement de bit asymétriques (par exemple, plus fréquemment que l'inverse)
-
Une relaxation dépendant de l'état pendant la mesure elle-même
-
Une diaphonie légère mais non négligeable entre résonateurs de lecture voisins
Il est important de noter que ces erreurs peuvent souvent être modélisées comme un processus stochastique classique agissant sur les résultats de mesure. TREX exploite une idée standard issue de l'adaptation du bruit : la randomisation (twirling) de la procédure de mesure. TREX se déroule généralement en deux étapes :
-
Twirling et « détwirling » classique
-
Remise à l'échelle des valeurs moyennes à l'aide de circuits de calibration
Supposons qu'une valeur moyenne de l'observable soit reliée à des estimations bruitées, comme suit :
où est un facteur fixe qui met à l'échelle l'estimation et est un biais issu des sources décrites ci-dessus. Nous utilisons ici pour rappeler que nous ne traitons ici que l'erreur de lecture ; il reste l'erreur de portes à considérer.
Juste avant la mesure, chaque qubit est conjugué de façon aléatoire avec un opérateur de Pauli (comme I ou X). Les résultats de mesure sont ensuite détwirlés classiquement.
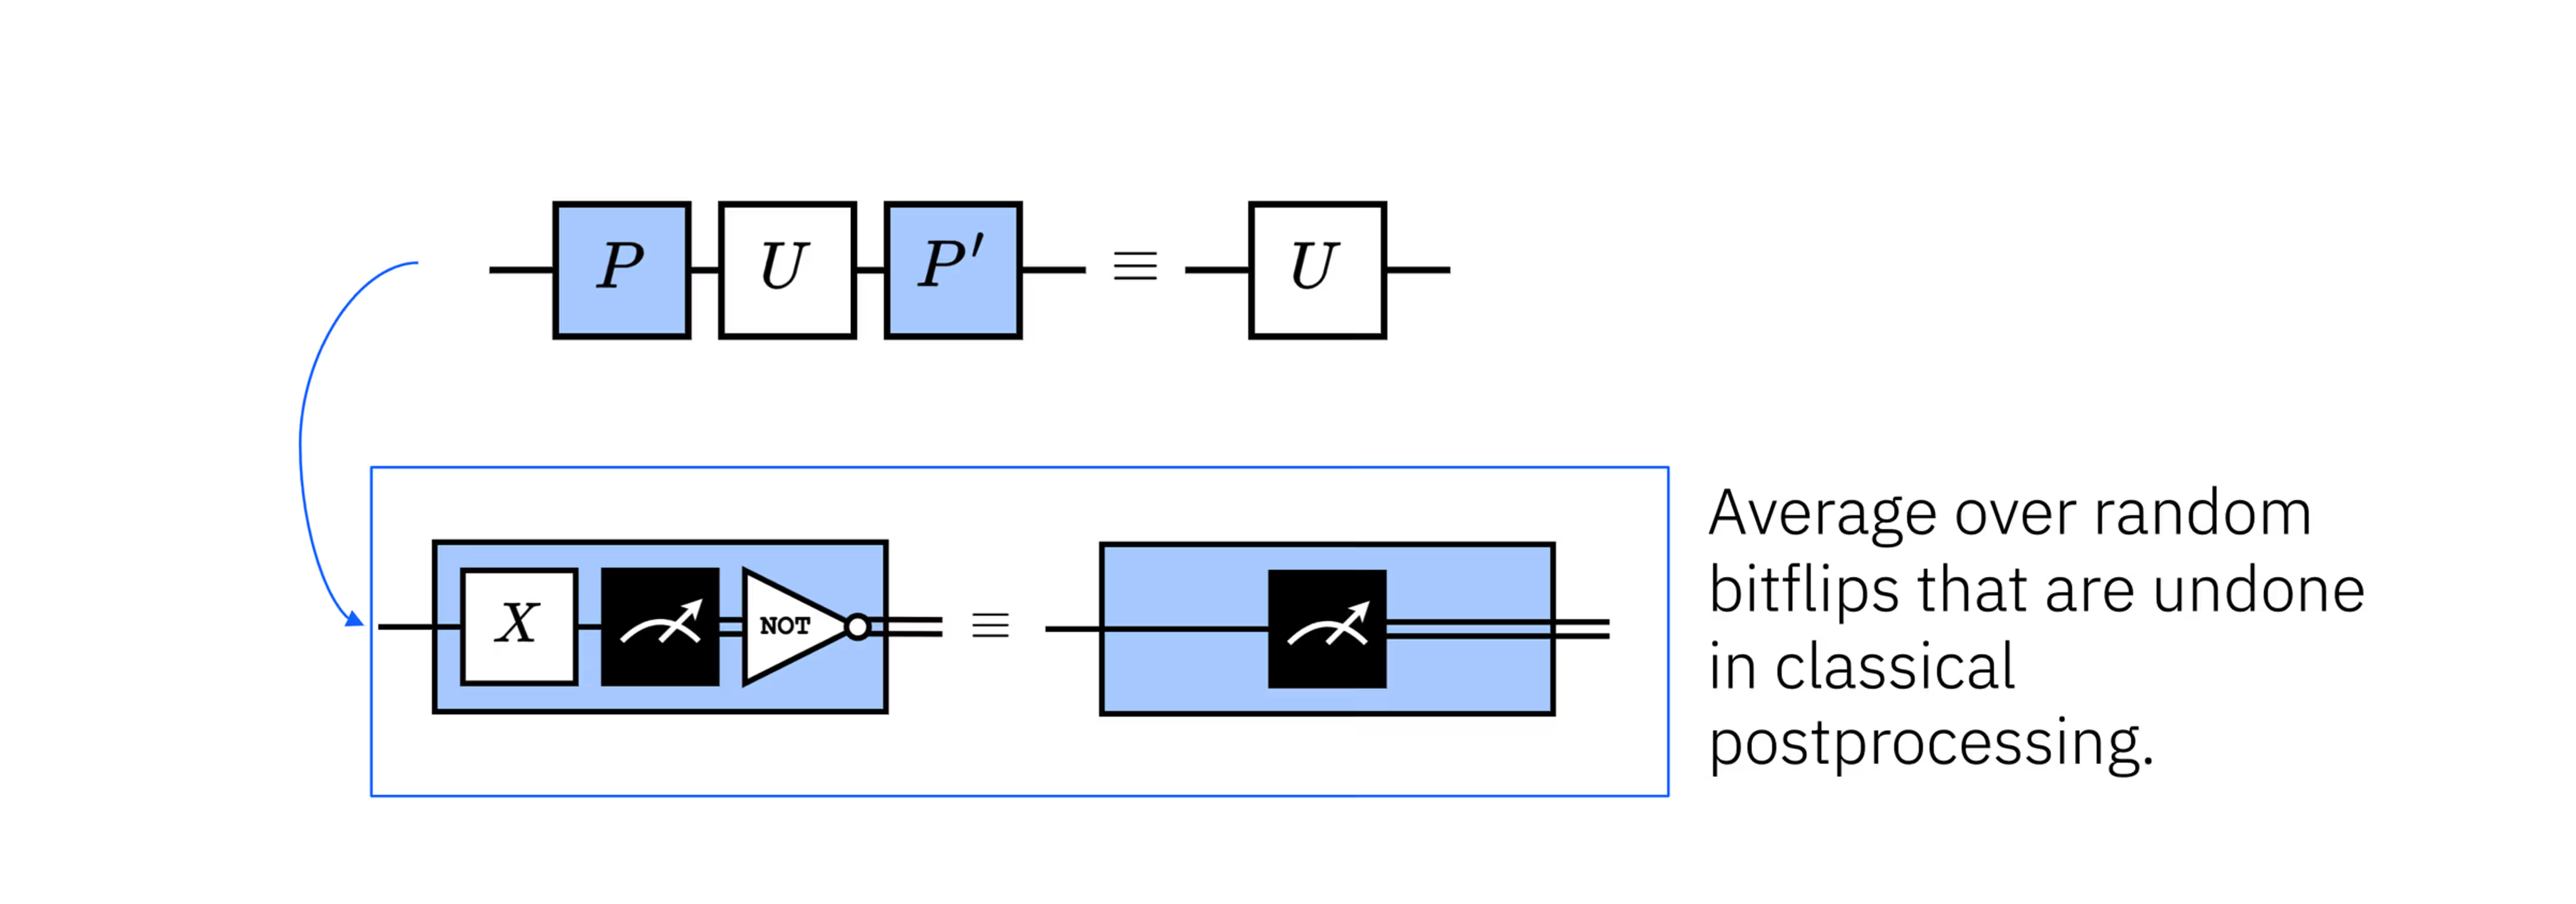
Le moyennage sur ces randomisations symétrise le canal de lecture. En conséquence, les asymétries systématiques du processus de lecture sont converties en un canal d'erreur plus symétrique, dont l'effet restant peut être traité par la calibration et la remise à l'échelle. En termes simples, si par exemple il y avait un biais en faveur de l'état , il nous manquerait certaines mesures de . En appliquant le twirling autour de la mesure, nous échangeons au hasard le résultat logique associé au processus de lecture physique, puis nous annulons cet échange classiquement ensuite. Le moyennage sur de nombreuses mesures aléatoires de ce type supprime la préférence systématique pour un résultat rapporté plutôt que pour l'autre. Cela supprime le biais de mesure dominant sous les hypothèses du modèle TREX, de sorte que nous avons :
Cependant, les valeurs moyennes peuvent encore nécessiter une remise à l'échelle. La seconde étape consiste à utiliser des circuits de calibration (des circuits aux résultats connus) pour estimer le facteur d'échelle . Celui-ci peut ensuite servir à obtenir une estimation grandement améliorée.
Les valeurs moyennes des observables de Pauli deviennent des estimateurs non biaisés de leurs valeurs idéales. Aucun modèle de bruit explicite n'est appris ni inversé, c'est pourquoi TREX est numériquement stable et peu coûteuse. Là encore, l'erreur de portes n'a pas été traitée ici.
Dans l'estimation d'une valeur moyenne de l'observable , il peut y avoir une variance due à l'échantillonnage fini, de nombreux types d'erreurs incohérentes et cohérentes, ainsi qu'un biais, , dû à l'erreur de lecture. Ce biais provient de sources comme les transitions asymétriques dont nous avons parlé. En pratique, ce biais est généralement bien modélisé comme un canal stochastique classique agissant après l'évolution quantique. TREX transforme le canal de mesure effectif de sorte que l'estimateur de soit non biaisé vis-à-vis de l'erreur de lecture. C'est relativement facile à voir avec l'exemple le plus simple de portes de twirling : X. S'il y a une asymétrie entre et , mais que nous échangeons au hasard l'état qui est lu (en rebasculant plus tard, classiquement), alors cela supprime évidemment l'asymétrie systématique (même si l'échantillonnage fini signifie qu'il peut subsister une légère asymétrie stochastique dans la mesure). En pratique, les portes de twirling pour TREX ne se limitent pas à I et X, mais cela suffit pour une explication.
TREX nous permet d'obtenir une estimation d'une valeur moyenne exempte de biais dû à l'erreur de lecture. Il peut encore subsister un biais provenant d'une autre source (comme une sur-rotation cohérente) ; TREX ne cible que la lecture. Comme TREX remplace le biais systématique par une symétrisation aléatoire, elle convertit généralement le biais en variance stochastique supplémentaire, ce qui augmente la variance de l'estimateur à coût d'échantillonnage fixe.
Vérifie ta compréhension
Supposons que nous utilisions Estimator sur un circuit qui a préparé l'état pour l'estimation de . Supposons en outre que des erreurs de mesure fassent que les résultats correspondant à soient rapportés comme dans 10 % des cas, tandis que les résultats correspondant à ne sont rapportés comme que dans 1 % des cas. L'asymétrie entre ces erreurs de rapport introduit un biais de mesure.
(a) En l'absence de telles erreurs de mesure, quelle serait la valeur moyenne idéale de l'observable ?
(b) Avec les erreurs de mesure ou de lecture asymétriques, quelle est la valeur moyenne de l'observable ?
(c) Considère un ensemble limité de portes de twirling de Pauli : I et X. Suppose que I et X sont appliquées aléatoirement avec une probabilité de 50 % sur plusieurs shots. Les mêmes taux d'erreur de mesure s'appliquent toujours. La porte de Pauli (I ou X) est ensuite annulée classiquement. Dresse un tableau de tous les résultats possibles et de leurs probabilités, dus à la superposition initiale, aux erreurs de mesure asymétriques et aux portes de Pauli assignées aléatoirement.
(d) Utilise le tableau pour déterminer la valeur moyenne avec la stratégie de twirling.
(e) Compare les valeurs moyennes : idéale, sans twirling et avec twirling.
(f) Qu'est-ce qui a été omis de ce traitement et se trouve dans une application complète de TREX ?
Réponse
(a) Tu peux simplement utiliser l'intuition et la symétrie pour dire que . Pour le montrer explicitement :
(b) L'état peut s'effondrer sur ou sur lors de la mesure, chacun avec 50 % de chances. Mais parmi les 50 % qui s'effondrent sur l'état , 1 % (soit 0,5 % de tous les cas) seront rapportés à tort comme . Parmi les 50 % qui s'effondrent sur , 10 % (soit 5 % de tous les cas) seront rapportés à tort comme . Cela nous laisse avec :
- 54,5 %
- 45,5 % En ignorant tous les autres types d'erreurs possibles, nous obtiendrions une estimation de
(c)
| Pauli | Résultat de mesure idéal | Résultat après Pauli | Erreur de lecture | Annuler Pauli | Résultat final rapporté | Probabilité |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Aucune | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Aucune | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Aucune | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Aucune | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) D'après les parties précédentes, nous connaissons les valeurs moyennes de Z dans chacun des états finaux. Il suffit de calculer la moyenne pondérée :
(e) Dans ce cas très simple, notre application du twirling a retrouvé exactement la valeur moyenne idéale. Ce n'est pas typique. Ce qui est typique, c'est que le twirling annule des biais comme ceux introduits par les transitions asymétriques et renvoie une valeur moyenne plus proche de l'idéale.
(f) Il s'agit d'une application d'un modèle jouet. Plusieurs choses peuvent manquer. Notamment, nous n'avons pas exécuté ici de circuits de calibration pour estimer un facteur de remise à l'échelle . Cela est généralement nécessaire.
Détails d'implémentation
TREX est appliquée automatiquement lorsqu'on utilise la primitive EstimatorV2 avec resilience_level = 1 (la valeur par défaut). Note qu'elle n'est pas appliquée automatiquement à la primitive Sampler, car Sampler renvoie des distributions de probabilité complètes plutôt que des valeurs moyennes.
Lorsque TREX est activée, le runtime génère des variantes de circuits avec twirling de mesure en insérant des Pauli à un qubit aléatoires immédiatement avant la mesure. Le post-traitement classique inverse ces Pauli. Ces variantes de circuits sont aléatoires d'un shot à l'autre et aussi d'un qubit à l'autre au sein d'un shot. Toutes les variantes de circuits sont ensuite combinées en un seul estimateur.
TREX est très évolutive. Elle nécessite des circuits de calibration supplémentaires, de sorte que le surcoût d'échantillonnage est généralement un petit facteur constant (souvent 2 à 4x). Mais la mitigation est spécifique à l'observable et ne préserve pas la distribution.
TREX est conçue pour s'intégrer proprement à de nombreuses méthodes de suppression et de mitigation d'erreurs, notamment les suivantes :
-
Découplage dynamique (DD) : agit pendant les temps d'inactivité, orthogonal à la mitigation de la lecture.
-
Twirling de portes ou de Pauli : souvent complémentaire ; TREX repose déjà sur le twirling mais ne cible que le bruit de lecture.
-
Extrapolation à bruit nul (ZNE) : la ZNE cible le bruit des portes, tandis que TREX gère le biais de mesure. Cette combinaison est utilisée au niveau de résilience 2.
-
Amplification probabiliste des erreurs et annulation probabiliste des erreurs dans les workflows Estimator.
Cependant, certaines méthodes ne peuvent pas (ou ne devraient pas) être combinées avec TREX :
-
Correction de probabilités au niveau de Sampler : TREX ne renvoie pas de probabilités de chaînes de bits corrigées.
-
Mitigation a posteriori sur des données TREX déjà mitigées : une double correction peut réintroduire du biais.
Combiner TREX avec une mitigation de lecture basée sur une matrice d'assignation comme M3 est délicat. M3 suppose un canal de mesure fixe. TREX randomise délibérément la mesure, ce qui invalide l'hypothèse utilisée par M3. En ce sens, tu ne peux pas simplement combiner ces techniques. Cependant, si tu appliques le twirling de mesure pendant la calibration utilisée dans M3, tu pourras peut-être tirer parti simultanément d'une approche de type matrice d'assignation et d'une approche de mitigation par twirling (même si cette approche de twirling n'est pas tout à fait la même que TREX). C'est un thème récurrent lorsqu'on combine des techniques de mitigation et de suppression : ajouter des techniques aveuglément échoue ; les ajouter avec soin, de sorte qu'elles se « connaissent » les unes les autres, peut fonctionner et être très bénéfique.
TREX garantit uniquement des valeurs moyennes exemptes de biais dus aux erreurs de lecture ; il ne réduit pas la variance, et il ne protège pas non plus contre d'autres types de biais. Il ne corrige certainement pas toutes les erreurs. Cependant, il s'agit souvent d'une amélioration substantielle, et elle est atteignable avec un surcoût bien inférieur à celui d'autres méthodes qui nécessitent d'apprendre des modèles de bruit complets. TREX est souvent la mitigation de lecture la moins coûteuse et la plus robuste disponible, ce qui en fait un excellent choix par défaut dans les expériences.
TREX avec Qiskit
Ici, nous créons un circuit simple à deux qubits et nous utilisons Estimator pour estimer la valeur moyenne d'une observable très simple, ZX. La valeur moyenne idéale est 1. Nous comparerons les valeurs moyennes avec et sans TREX.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Crée le circuit quantique simple.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Transpile le circuit à l'aide d'un pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Applique à l'observable la même disposition (layout) que celle issue de la transpilation.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Exécute l'expérience sur un vrai ordinateur quantique. Nous commençons avec reslience_level = 1 ; c'est la valeur par défaut, mais nous l'avons rendue explicite pour distinguer les deux cas.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Maintenant, nous réglons resilience_level sur 0 pour exécuter sans TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
La valeur moyenne est nettement plus proche de l'idéal (1) avec TREX, comme prévu. Bien sûr, il s'agissait d'une seule valeur moyenne sur un seul qubit. Nous préparons maintenant un circuit utilisant des portes non-Clifford et de nombreux qubits pour tester si l'amélioration apportée par TREX reste robuste dans un cadre différent.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Ici, l'angle de rotation n'a rien de spécial. Nous avons simplement choisi une superposition inégale quelconque de et afin de sonder les effets de transitions erronées asymétriques et la façon dont TREX les traite. Étant donné cet état, la valeur moyenne idéale de Z sur chaque qubit, en l'absence de toute erreur (de lecture ou autre), serait :
Nous espérons donc obtenir des valeurs moyennes proches de -0.924 sur tous les qubits. Nous verrons si TREX améliore chaque valeur moyenne individuellement et aussi s'il améliore la moyenne sur l'ensemble des qubits.
Vérifie ta compréhension
Vérifie la valeur moyenne ci-dessus par un calcul direct.
Réponse
Nous transpilons à l'aide d'un pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Nous construisons maintenant une observable par qubit afin de pouvoir estimer les vingt valeurs moyennes en un seul workflow. Autrement dit, pour le qubit d'indice , nous voulons une observable composée uniquement d'identités , sauf à la position , où nous voulons un . N'oublie pas d'appliquer aussi ta disposition transpilée à tes observables.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Nous pouvons maintenant exécuter. La cellule de code ci-dessous utilise le session mode ; si tu n'as pas accès aux sessions, tu peux le remplacer par le batch mode pour exécuter le même workflow, mais avec d'éventuels temps d'attente dans la file entre les circuits.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Nous comparons ici les erreurs absolues moyennes avec et sans TREX.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
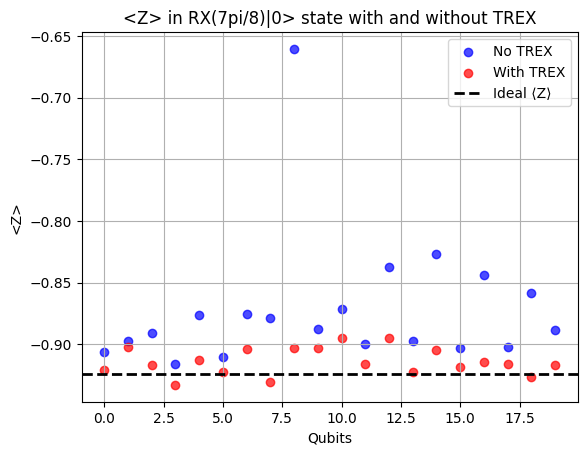
TREX semble clairement avoir aidé. La valeur moyenne sur chaque qubit s'est améliorée, à la seule exception du qubit 16. Une telle valeur aberrante est normale. Nous pouvons quantifier l'effet global de TREX sur le circuit en prenant les valeurs moyennes.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
En moyenne, TREX a rapproché nos résultats d'environ 2,9 % des résultats idéaux, et nous a laissé avec un résultat qui, en moyenne, ne diffère de l'idéal théorique que de 0,4 %. C'est excellent, et cette amélioration à faible surcoût est exactement la raison pour laquelle TREX est la mitigation d'erreurs par défaut dans Estimator. Mais nous devons encore une fois souligner que TREX supprime un biais de l'erreur de lecture, sans corriger toutes nos erreurs. Nous avons choisi un état initial qui avait de bonnes chances d'être affecté par l'asymétrie de la lecture. L'effet aurait été différent si nous avions préparé chaque qubit dans un état différent. Pour un argument trivial montrant que cela doit être le cas, imagine ce qui se passerait si nous laissions chaque qubit dans l'état fondamental . Il n'y aurait aucune occasion d'observer (ou de corriger) une asymétrie de l'erreur de lecture entre les états et .
Extrapolation à bruit nul (ZNE)
L'extrapolation à bruit nul (ZNE) est l'une des techniques de mitigation d'erreurs les plus utilisées. La stratégie générale est aussi facile à comprendre, même si les détails de sa mise en œuvre sont complexes. ZNE fonctionne ainsi :
-
Exécuter un circuit cible à plusieurs « niveaux de bruit » — des modifications du circuit qui font évoluer son bruit de façon prévisible
-
Estimer l'observable d'intérêt pour chaque échelle de bruit.
-
Extrapoler jusqu'à un bruit nul à l'aide d'un modèle d'ajustement (linéaire, polynomial, exponentiel, etc.).
Le résultat est une estimation de ce qu'aurait été l'observable dans la limite de bruit nul impliquée par le modèle d'extrapolation.
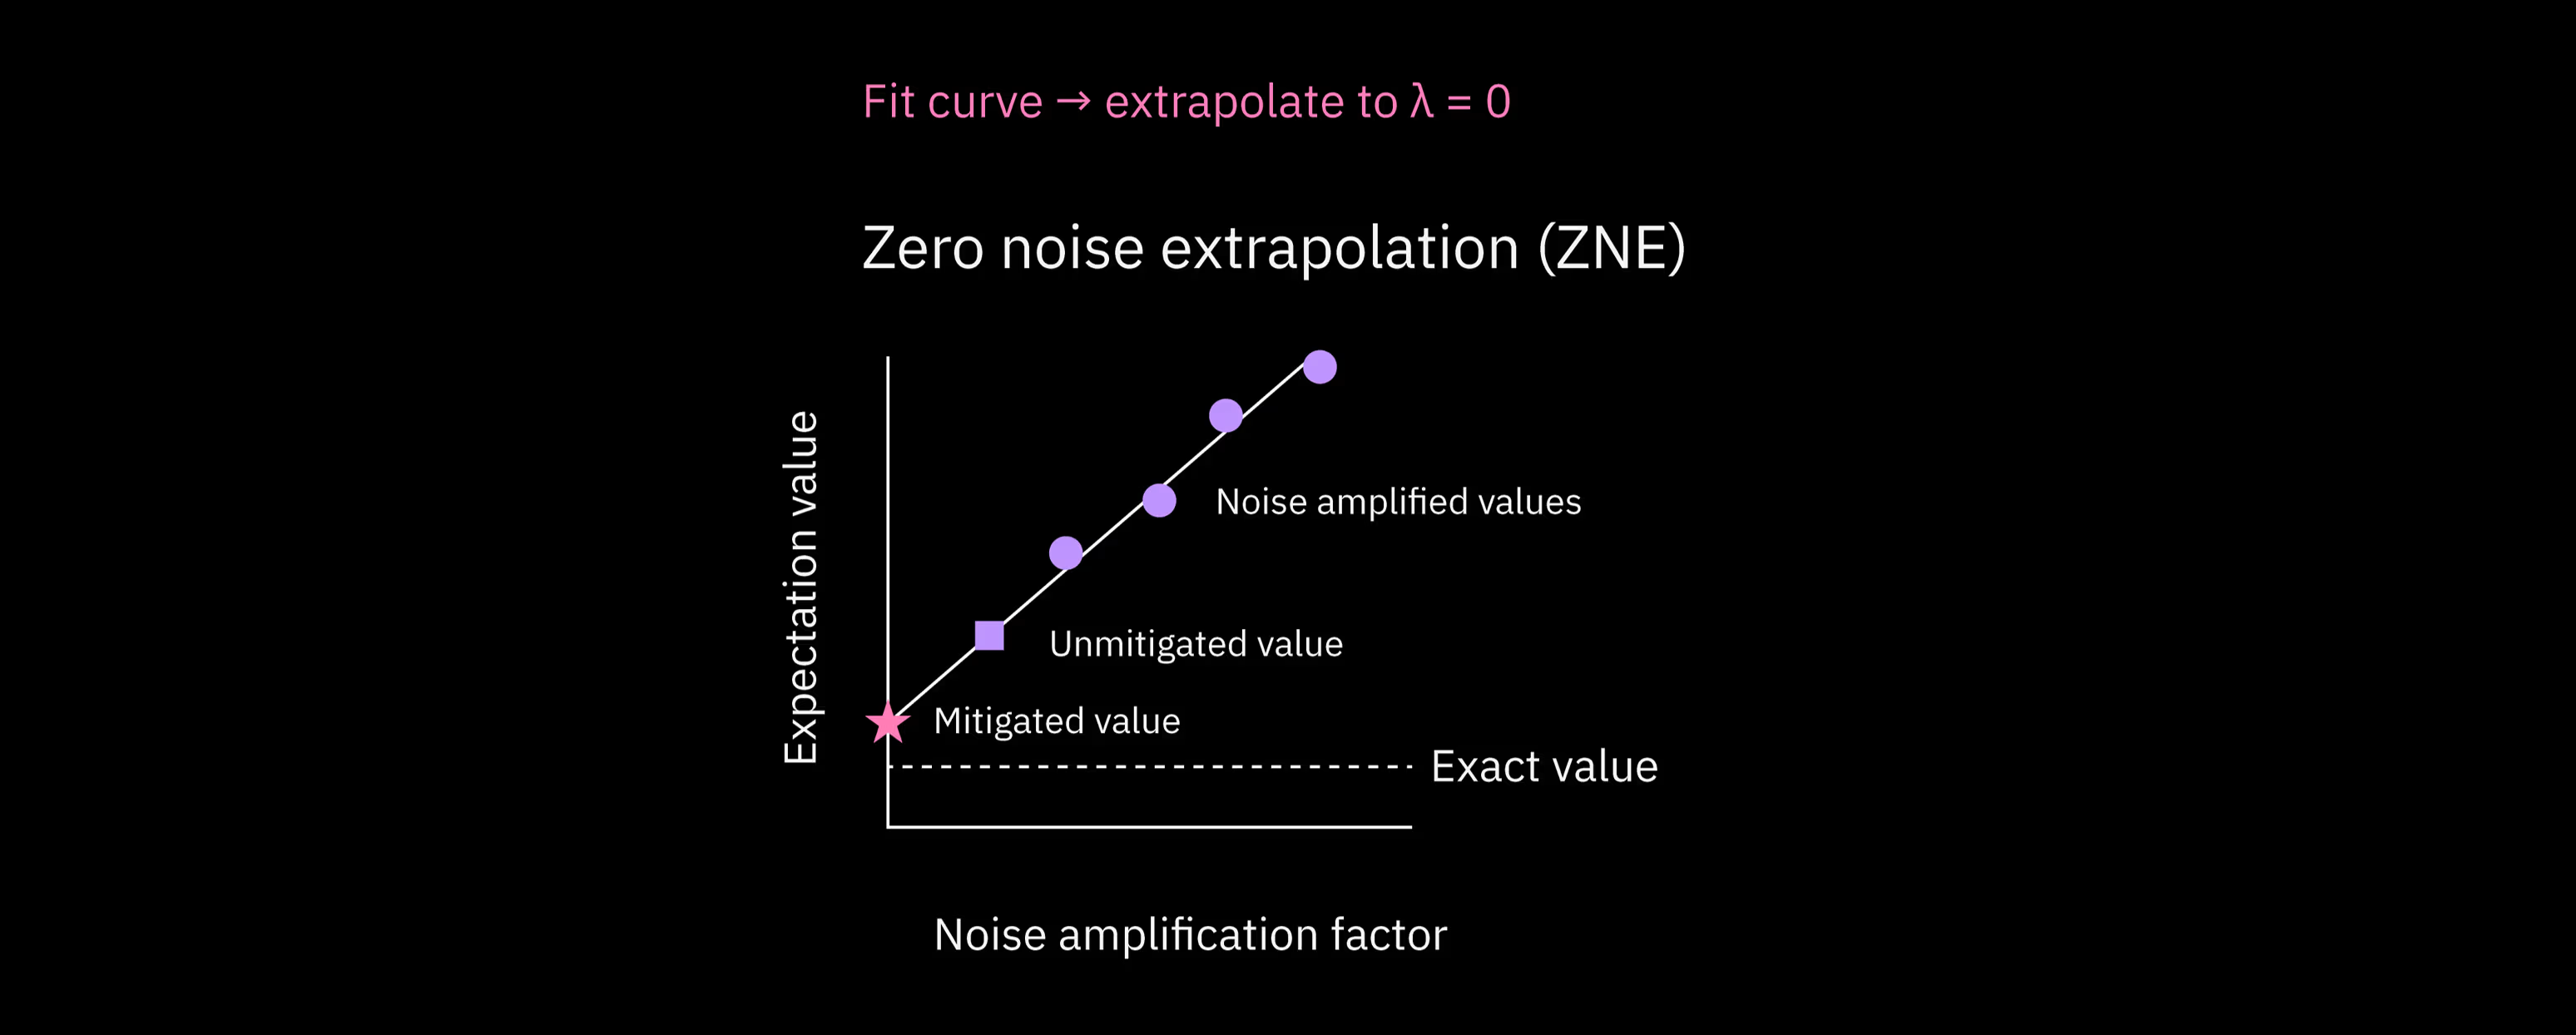
ZNE ne garantit pas que le bruit augmente de façon régulière ou linéaire lorsque nous modifions les circuits. En revanche, il suppose que la mise à l'échelle du bruit est suffisamment bien conduite pour permettre l'extrapolation. La complexité de ZNE réside dans la manière de modifier les circuits pour satisfaire au mieux cette hypothèse. Nous examinerons quelques approches dans cette leçon.
Mise à l'échelle des ressources de ZNE
Dans ZNE, le surcoût est principalement un surcoût quantique. Autrement dit, pour obtenir des valeurs moyennes à niveaux de bruit, tu dois réaliser ton expérience sur circuits, chacun avec de nombreux shots. Pour maintenir une précision statistique fixe, le nombre total d'échantillons augmente généralement à mesure que des circuits à bruit amplifié sont ajoutés.
Le nombre de niveaux de bruit que tu examines, , dépend de la méthode utilisée pour mettre le bruit à l'échelle. Pour une technique simple d'amplification du bruit (appelée « gate-folding », présentée ci-dessous), est généralement compris entre 3 et 5. Une autre méthode (l'amplification probabiliste du bruit (PNA)) autorise des facteurs de bruit non entiers et aboutit généralement à des niveaux de bruit plus faibles que le gate-folding. Le surcoût total évolue approximativement ainsi :
où est le nombre de shots de référence. Il faut aussi garder à l'esprit que si l'amplification du bruit implique des portes répétées, la profondeur du circuit peut augmenter d'un facteur proportionnel à la valeur d'amplification du bruit. L'augmentation du bruit liée à la profondeur accrue est précisément le but recherché, mais garde en tête la profondeur totale.
ZNE est bien adapté aux problèmes pour lesquels les points suivants s'appliquent :
-
Tu as besoin d'une méthode de mitigation généraliste, efficace sur de nombreux types d'erreurs.
-
La profondeur du circuit n'est pas trop grande ; ZNE échoue lorsque le circuit amplifié devient trop bruité pour être extrapolé.
-
Tu peux tolérer un surcoût d'exécution modéré en échange d'une meilleure précision.
En pratique, cela rend ZNE idéal pour de nombreux circuits variationnels, pour l'estimation de valeurs moyennes et pour d'autres algorithmes quantiques à court terme. Il est implémenté dans Estimator via resilience_level = 2. Note que ZNE extrapole dans un espace où il y a un unique résultat en fonction du bruit sur l'ensemble du circuit. Cela signifie qu'il se prête aux problèmes d'estimation, mais pas aux problèmes d'échantillonnage. Il n'est pas conçu pour fonctionner sur des distributions de chaînes de bits.
Facteurs de bruit
Comment peut-on exactement augmenter le niveau de bruit dans un circuit ? Il existe deux grandes méthodes, bien que de nombreuses variantes existent.
-
Remplacer une porte ou un bloc de portes par . Comme les portes des ordinateurs quantiques sont unitaires, nous savons que , de sorte que logiquement : . Cependant, chaque répétition de ou de ajoute une erreur semblable ou identique, ce qui nous permet d'augmenter les niveaux de bruit/d'erreur. Note que le remplacement présenté ci-dessus nous fait passer du bruit d'origine de la porte (niveau de bruit 1) à trois fois ce niveau de bruit dans (niveau de bruit 3). En pratique, nous pouvons répéter les deux dernières portes fois : pour obtenir un niveau de bruit . C'est ce qu'on appelle le gate folding, et c'est une technique d'amplification du bruit très courante.
-
Il existe d'autres méthodes pour augmenter le niveau de bruit, comme l'amplification probabiliste des erreurs (PEA). Avec PEA, nous apprenons d'abord un modèle de bruit adapté au circuit, généralement exprimé sous la forme d'un canal de Pauli. Le bruit est ensuite amplifié en échantillonnant à partir d'une version remise à l'échelle de ce canal de bruit appris. En ajustant l'échantillonnage, tu peux faire varier continûment l'intensité effective du bruit, y compris vers des valeurs non entières.
En pratique, le gate folding permet d'amplifier les erreurs de façon très fiable, mais il peut aussi conduire à des circuits très profonds. Si tu n'as besoin que de trois niveaux de bruit (1, 3 et 5), cela signifie multiplier la profondeur de ton circuit par 5 tout en obtenant encore des résultats raisonnables. Ainsi, si ton circuit cible a, une fois transpilé, une profondeur à deux qubits de 60 ou plus, PEA est probablement mieux adapté que le gate-folding.
Les portes peuvent être repliées soit localement (c'est-à-dire que tu répètes pour chaque porte à deux qubits dès qu'elle apparaît), soit regroupées en un bloc de portes que l'on répète (comme pour les portes ). Le repliement local est souvent préférable au regard des hypothèses faites par ZNE, mais les deux sont possibles.
Le traitement statistique des résultats à bruit amplifié dans ZNE comporte beaucoup de subtilités. Par exemple, à cinq fois le niveau de bruit, tes résultats auront certainement une variance plus élevée et seront moins fiables. Faut-il leur donner le même poids qu'aux points de données à plus faible bruit ? Non. Cependant, pour voir ZNE en action, nous ignorerons une partie de cette complexité dans une expérience avec un modèle simplifié, dans laquelle nous construirons les circuits repliés à la main et ferons une extrapolation naïve à poids égaux pour illustrer les étapes clés. Mais nous ferons suivre cela d'une expérience utilisant la fonctionnalité ZNE intégrée à Qiskit, et nous verrons qu'elle gère bien mieux la complexité que nous laissons de côté.
ZNE à la main
Nous commençons par choisir un circuit quantique et une observable pour lesquels nous pouvons calculer la valeur moyenne idéale en l'absence de bruit et d'erreurs. Nous choisissons un état GHZ , avec un nombre pair de qubits. Notre observable est . Nous faisons ce choix pour plusieurs raisons :
- La valeur moyenne est triviale à calculer dans le cas idéal. Comme le nombre de qubits est pair, on obtient soit un
1pour chaque , multipliés entre eux, soit un-1pour chaque , multipliés entre eux un nombre pair de fois. - Elle sera assez sensible aux erreurs et au bruit, puisqu'une seule erreur sur un qubit peut faire basculer le résultat global de ce shot de +1 à -1.
- La valeur moyenne est loin de 0. ZNE peut rencontrer des difficultés lorsque la valeur moyenne idéale est très proche de zéro, car des niveaux de bruit élevés tendent à randomiser les résultats, les rendant aussi souvent positifs que négatifs. Il en résulte que les niveaux de bruit élevés finissent par donner des valeurs proches de l'idéal ; cela peut rendre l'extrapolation très délicate.
Avec cette motivation en tête, construisons nos circuits.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Note la subtilité suivante : ici, . Même si le gate folding a été présenté comme composé d'opérateurs de la forme , ici cette même structure ressemble à CNOT CNOT CNOT.
Vérifions que notre circuit d'indice est bien le circuit GHZ normal :
ghz_amp[0].draw("mpl")
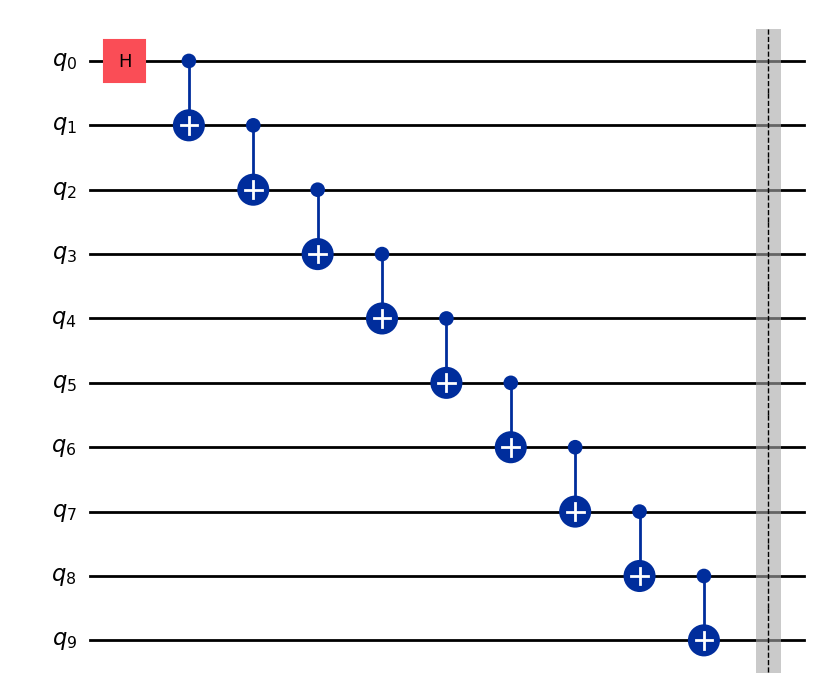
Tu peux examiner les autres circuits pour vérifier qu'ils ont la structure attendue.
Nous construisons maintenant nos observables.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Nous construisons un pass manager et l'appliquons à nos circuits. Nous prenons ensuite les dispositions (layouts) et les appliquons à nos observables.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Mets en forme les pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Nous exécutons maintenant Estimator. Nous voudrions nous concentrer sur le rôle de ZNE, et nous pourrions donc vouloir régler resilience_level = 0 pour éviter de confondre les effets du twirling avec l'effet de ZNE. Cependant, nous voulons aussi comparer notre ZNE « à la main » aux paramètres ZNE intégrés à Qiskit, qui incluent le twirling. Nous réglons donc ici resilience_level = 1. Régler resilience_level = 2 invoque les paramètres ZNE de Qiskit, que nous utiliserons bientôt.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Nous affichons maintenant les niveaux de bruit et les valeurs moyennes.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
C'est ici que nous nous montrons les plus désinvoltes : nous réalisons un ajustement linéaire sur ces données sans prêter attention à la variance de chaque valeur obtenue, et sans essayer de prédire théoriquement si l'ajustement doit être linéaire. Là encore, le ZNE intégré fait un bien meilleur travail que ce que nous faisons à la main.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Nous traçons cela avant de l'interpréter.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
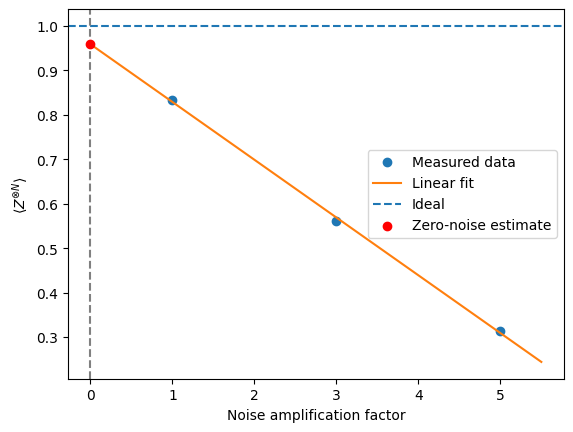
Lors de la création de cette leçon, l'extrapolation au cas de bruit nul nous a donné une valeur moyenne de 0.959. Tes valeurs peuvent différer. C'est nettement mieux que la valeur moyenne du circuit brut, 0.83, soit environ 13 % plus proche de la valeur idéale. Mais tu peux aussi voir que nous utilisons un point de données où la valeur moyenne était descendue à 0.31. Ce point de données est évidemment de moins bonne qualité. Si ce point avait reçu un poids plus faible dans notre approximation linéaire, et que la droite avait été ajustée davantage sur les deux premiers points de données, nous pouvons voir que l'estimation extrapolée à zéro aurait été plus élevée (plus proche de la valeur idéale). Ce type de considération est géré automatiquement dans le ZNE intégré à Estimator.
ZNE intégré à Estimator
Voyons maintenant ce qui se passe lorsque nous utilisons la fonctionnalité ZNE intégrée à Estimator. Nous commençons par définir un circuit GHZ simple, sans aucun gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Nous définissons la même observable qu'auparavant.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Nous définissons à nouveau un pass manager, en utilisant optimization_level = 1. Nous reviendrons sur ce choix plus bas.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Transpile le circuit et applique la disposition aux observables.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Nous exécutons Estimator avec ZNE et twirling, et nous comparons les résultats à notre implémentation de ZNE à la main. En particulier, nous les comparons au résultat sans ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Nous pouvons récupérer les valeurs pour chaque facteur de bruit avec la syntaxe job_zne.result()[0].data.evs_noise_factors. Comme précédemment, nous pourrions naïvement utiliser ces résultats pour obtenir un ajustement linéaire et extrapoler au cas de bruit nul, mais l'estimateur avec resilience_level = 2 a déjà fait un meilleur travail, en tenant compte de la variance et d'autres considérations. Ci-dessous, nous montrons ce que donnerait une extrapolation linéaire, et ce que le ZNE intégré a réellement donné.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
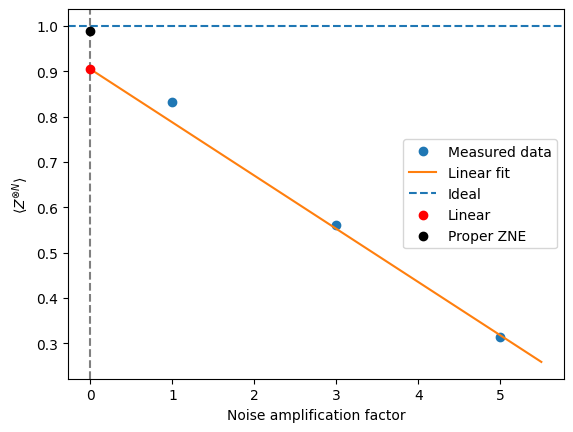
Nous voyons que le ZNE intégré a amélioré notre estimation de plus de 15 %, et a fonctionné nettement mieux que notre tentative à la main.
Avant de poursuivre, note que tout au long de cette exploration de ZNE, nous avons réglé optimization_level = 1 dans le pass manager. Des niveaux d'optimisation plus élevés réduisent l'erreur, et cette réduction peut parfois rendre l'évolution des erreurs moins prévisible. Comme souvent, il y a un équilibre : réduire les erreurs, sauf quand tu les augmentes intentionnellement d'un facteur connu.
Combiner les méthodes
ZNE repose sur les éléments suivants :
-
Un paramètre d'amplification du bruit bien défini
-
Une évolution suffisamment régulière et prévisible des valeurs moyennes avec
-
Le même canal de bruit effectif, à des intensités différentes
-
Aucun biais introduit qui n'évolue pas avec
ZNE se combine proprement avec les techniques qui suppriment les biais non évolutifs (comme M3) ou qui rendent le bruit plus régulier (comme le twirling), mais entre en conflit avec les techniques qui tentent soit d'annuler entièrement le bruit (PEC), soit de le remodeler dynamiquement (DD).
En particulier, M3 traite uniquement l'erreur de mesure/lecture, qui en pratique peut être considérée comme séparée des erreurs de portes (qui sont l'objet des processus d'amplification des erreurs dans ZNE). M3 est largement indépendant du gate folding ; il peut être combiné proprement avec ZNE. TREX est très similaire, et peut être combiné avec ZNE.
Le Pauli twirling se concentre bien sur les portes, contrairement à M3 et TREX. Cependant, rappelle-toi que le Pauli twirling ne mitige pas directement l'erreur/le bruit ; il le transforme plutôt pour le rendre plus prévisible. Le Pauli twirling pourrait en fait être bénéfique pour le processus ZNE en rendant l'évolution des erreurs de portes plus linéaire, et donc l'extrapolation plus précise.
Le dynamical decoupling (DD) est plus nuancé. DD modifie dynamiquement le comportement du bruit en annulant partiellement certaines erreurs grâce à l'ajout de séquences de portes. S'il est possible de construire les circuits de telle sorte que DD se comporte de la même façon même lorsque des portes ou des blocs sont repliés, alors en principe on pourrait combiner ZNE et DD, mais en pratique DD perturbe parfois l'amplification. Si tu veux les combiner, voici des points à considérer :
- DD est-il appliqué de manière cohérente à tous les niveaux de bruit ?
- Le repliement préserve-t-il la structure de DD ?
- L'amplification du bruit qui en résulte se comporte-t-elle toujours de façon monotone ?
La dernière méthode de mitigation d'erreurs que nous aborderons en tant qu'approche autonome n'est pas compatible avec ZNE : l'annulation probabiliste des erreurs.
Annulation probabiliste des erreurs (PEC)
Contrairement à ZNE ou à la mitigation de mesure, PEC tente d'annuler le bruit au niveau des portes en reconstruisant en moyenne le canal idéal. L'annulation probabiliste des erreurs (PEC) est la technique de mitigation d'erreurs la plus puissante et la plus coûteuse abordée dans cette leçon. PEC est construite autour de l'inversion explicite du canal de bruit, réalisée de façon statistique plutôt que physique. PEC fonctionne ainsi :
-
Caractériser le modèle de bruit en termes d'une base d'« opérations d'erreur ».
-
Exprimer l'inverse du canal de bruit comme une distribution de quasi-probabilités sur des opérations physiques.
-
Échantillonner cette distribution pendant l'exécution du circuit afin de construire statistiquement une estimation non biaisée du calcul idéal.
Sur le plan conceptuel, PEC est comme une correction d'erreurs virtuelle — elle « annule » le bruit en combinant des opérations bruitées selon des schémas aléatoires soigneusement pondérés. Sur le plan procédural, cependant, PEC n'est pas étroitement liée à la correction ou à la détection d'erreurs par des codes. L'estimation non biaisée de la valeur moyenne idéale, sans bruit, qu'offre PEC se paie par un surcoût d'échantillonnage très important et une forte dépendance à une caractérisation précise du bruit.
Sur les ordinateurs quantiques IBM, PEC se voit mieux comme un outil de précision que comme une couche de mitigation généraliste : elle est la plus appropriée pour les petits circuits ou de petites portions de circuits plus grands, les tâches de benchmarking et les études de haute précision où un surcoût quantique élevé est acceptable.
Caractériser le canal de bruit
Dans PEC, chaque porte idéale d'un circuit quantique est modélisée comme un canal unitaire idéal suivi d'un processus de bruit. Soit la matrice densité de l'état quantique. La porte idéale est représentée par une matrice unitaire , qui induit un canal quantique :
Sur du matériel réel, cette évolution idéale est corrompue par le bruit. Nous modélisons l'implémentation physique de la porte comme un canal bruité effectif :
où est un canal de bruit qui capture les erreurs stochastiques associées à la porte. Dans toute cette discussion, , et sont des applications linéaires agissant sur des opérateurs densité. Le canal idéal est unitaire et réversible, tandis que le canal de bruit (et donc ) est une application complètement positive et préservant la trace (CPTP).
PEC suppose que le canal de bruit est connu ou approximativement connu. Sur le matériel IBM Quantum, cette information est généralement obtenue à partir des données de calibration de l'appareil, des taux d'erreur déduits d'expériences de benchmarking et de modèles de bruit simplifiés comme des approximations de Pauli ou dépolarisantes pour de petits ensembles de portes. Bien que PEC ne requière pas un modèle de bruit parfaitement exact, ses performances se dégradent rapidement à mesure que le canal de bruit supposé s'écarte du comportement réel du matériel.
Décomposition en quasi-probabilités du canal de bruit inverse
L'idée centrale de PEC est d'annuler en moyenne l'effet du bruit en construisant une approximation stochastique de l'inverse du canal de bruit. Formellement, le but est d'appliquer une application linéaire qui annule approximativement , de sorte que :
en moyenne sur de nombreuses exécutions du circuit.
L'inverse est défini ici comme l'inverse algébrique de considéré comme un superopérateur linéaire agissant sur des opérateurs. Cet inverse n'existe que si est de rang plein ; les processus de bruit non inversibles ne peuvent pas être exactement mitigés par PEC.
Lorsque l'inversion est possible, PEC exprime le canal de bruit inverse comme une combinaison linéaire d'opérations physiquement implémentables :
Ici, chaque est une opération bruitée qui peut être exécutée sur le matériel (typiquement des portes natives ou de courtes séquences de portes), et les coefficients réels forment une distribution de quasi-probabilités. Contrairement aux probabilités ordinaires, les coefficients peuvent être négatifs ou dépasser 1.
La norme de quasi-probabilité :
quantifie le coût de l'inversion du bruit. Pour tout canal de bruit non trivial, . Sur le matériel IBM Quantum, cette décomposition est généralement réalisée :
- par porte ou par petit ensemble de portes,
- en supposant des modèles de bruit restreints (souvent des approximations diagonales de Pauli),
- en utilisant les opérations natives spécifiques du Backend et les contraintes d'ordonnancement.
Reconstruction Monte Carlo du circuit idéal
Pour estimer la valeur moyenne d'une observable , PEC utilise un échantillonnage Monte Carlo basé sur la décomposition ci-dessus. Pour chaque occurrence d'une porte bruitée dans le circuit, la procédure suivante est appliquée :
-
Sélectionner aléatoirement une opération avec la probabilité :
-
Attribuer un poids classique :
-
Exécuter le circuit bruité randomisé obtenu sur le Backend quantique.
-
Multiplier le résultat mesuré par le produit de tous les poids accumulés.
-
Moyenner les résultats pondérés sur de nombreuses exécutions du circuit.
L'estimateur obtenu satisfait
à condition que le modèle de bruit décrive fidèlement le matériel. PEC n'introduit donc aucun biais systématique en moyenne, mais remplace le biais par une grande variance statistique. Chaque exécution produit une estimation bruitée mais pondérée ; ce n'est qu'après avoir moyenné de nombreuses exécutions de ce type que la valeur moyenne idéale émerge.
Interprétation conceptuelle
PEC est parfois décrite comme une correction d'erreurs virtuelle. Bien que cette formulation ne soit pas entièrement incorrecte, il ne faut pas la confondre avec une véritable correction d'erreurs quantique. PEC n'implique ni encodage logique, ni extraction de syndrome, ni rétroaction en temps réel. Les erreurs ne sont ni évitées ni corrigées pendant l'exécution du circuit.
À la place, PEC annule le bruit statistiquement, en combinant de nombreuses réalisations bruitées du circuit avec des poids classiques signés, de sorte que les erreurs ne s'annulent qu'après un post-traitement classique. L'information n'est pas protégée pendant l'exécution ; les résultats idéaux sont reconstruits après coup.
Mise à l'échelle des ressources et coût
Le coût dominant de PEC provient de l'amplification de la variance. La variance de l'estimateur PEC évolue ainsi :
ce qui implique :
Cette mise à l'échelle est fondamentale et ne peut pas être améliorée par un post-traitement classique.
Pour les circuits contenant de nombreuses portes bruitées, chaque porte contribue par un facteur , ce qui fait croître la norme de quasi-probabilité totale approximativement de façon multiplicative :
où est la profondeur du circuit. Sur le matériel IBM Quantum, cela conduit généralement à une croissance exponentielle du coût d'échantillonnage avec la profondeur du circuit, avec une sensibilité particulièrement forte aux erreurs des portes à deux qubits. Cette évolution impose des limites pratiques à l'applicabilité de PEC.
PEC n'est actuellement praticable que lorsque l'une ou la totalité des conditions suivantes sont remplies :
-
Les circuits sont très petits ou peu profonds (souvent portes),
-
Les modèles de bruit sont simples et bien validés (par exemple, le bruit de Pauli),
-
Un coût statistique élevé est acceptable,
-
L'objectif est la précision plutôt que le débit.
Pour cette raison, PEC est souvent appliquée à :
-
Des sous-circuits isolés au sein de workflows plus vastes,
-
Des étapes d'évolution sur de courtes durées,
-
Des routines de préparation d'état ou de mesure,
-
Des expériences de benchmarking et de validation.
La pile logicielle IBM (IBM Quantum Compute et les outils de mitigation d'erreurs) le reflète en traitant PEC comme une option spécialisée, et non comme une couche de mitigation par défaut.
Les cas d'usage typiques de PEC comprennent :
-
Benchmarking de précision du matériel quantique,
-
Vérification de petits algorithmes quantiques,
-
Chimie quantique de haute précision sur des systèmes réduits,
-
Vérification croisée de ZNE ou d'autres méthodes de mitigation.
Relation de PEC avec les autres méthodes de mitigation
De nombreuses autres techniques de mitigation sacrifient la précision au profit de la scalabilité ; PEC fait exactement le contraire, en privilégiant la précision avant tout.
Comme PEC peut n'être utilisée que sur un sous-circuit, il est particulièrement important de se demander quelles autres méthodes de mitigation peuvent lui être combinées. Pour raisonner clairement sur la compatibilité avec PEC, il est utile de classer les techniques selon ce qu'elles font au bruit. Considère ces catégories générales :
-
Annulation du bruit : tentative d'inverser les canaux d'erreur
-
Mise à l'échelle du bruit : augmentation délibérée du bruit pour extrapoler
-
Remodelage du bruit : modification de la structure ou du spectre du bruit
-
Suppression du biais : correction des erreurs qui ne varient pas avec le bruit des Gates
PEC se situe clairement dans la catégorie (1). Toute méthode qui modifie ou remet à l'échelle le canal de bruit doit être examinée avec soin.
Tableau récapitulatif (vue d'ensemble)
| Technique | Compatible avec PEC | Remarques |
|---|---|---|
| ZNE | Non | Annuler contre mettre à l'échelle, et parfois adapter l'erreur |
| Pauli twirling | Oui (avec précaution) | Affecte le comportement de l'erreur, mais peut faciliter son apprentissage |
| TREX | Oui | Aucun chevauchement dans le workflow. Entièrement compatible. |
| Dynamical decoupling | Généralement non | Modifie le canal d'erreur |
PEC et ZNE traitent les mêmes sources d'erreur (erreurs de Gates) avec des hypothèses ou des flux de travail mutuellement incompatibles, ou les deux. Par exemple, dans ZNE, on suppose que l'erreur peut être développée en fonction d'un paramètre :
et que l'erreur peut être effectivement mise à l'échelle pour modéliser ce développement. PEC annulerait justement l'erreur sur laquelle repose la mise à l'échelle. Le paramètre perdrait tout sens. Une autre façon de voir les choses :
-
Appliquer ZNE avant PEC modifie le canal de bruit que tu essaies d'inverser.
-
Appliquer PEC avant ZNE supprime le bruit même sur lequel ZNE s'appuie pour extrapoler.
PEC et ZNE doivent être considérées comme des paradigmes de mitigation d'erreur alternatifs, et non comme des couches composables. Les comparer côte à côte est instructif, alors que les combiner ne l'est pas.
PEC et Pauli twirling sont généralement compatibles et souvent bénéfiques. Le twirling peut aider PEC dans la mesure où il convertit les erreurs cohérentes en erreurs de Pauli stochastiques. Cela simplifie le canal de bruit, ce qui le rend plus facile à représenter et à inverser. Pour PEC, c'est extrêmement précieux, pour les raisons suivantes :
-
Les décompositions en quasi-probabilités sont beaucoup plus simples pour les canaux de Pauli
-
La norme de quasi-probabilité est souvent nettement plus petite
-
La variance d'échantillonnage est réduite
De nombreuses démonstrations de PEC supposent ou intègrent un bruit soumis au Pauli twirling. Il est important de préciser que le Pauli twirling ne mitige pas les erreurs à lui seul ; il remodèle le bruit sous une forme que l'annulation probabiliste d'erreurs peut traiter plus efficacement.
PEC peut et doit être combinée avec TREX. Ces approches sont entièrement compatibles et jouent des rôles orthogonaux. TREX n'agit qu'à la mesure, supprime le biais de lecture via des twirls aléatoires du canal de mesure, et n'affecte ni le bruit des Gates ni la dynamique du Circuit. PEC agit sur le bruit des Gates. Comme l'erreur de mesure est additive plutôt que compositionnelle, elle est indépendante des séquences de Gates. Il est sûr, et souvent souhaitable, d'appliquer TREX en parallèle de PEC.
L'ordre de ces méthodes est celui auquel tu pourrais t'attendre :
- Exécuter le Circuit randomisé de PEC
- Appliquer TREX pour mitiger l'erreur de lecture
- Appliquer la pondération et la moyenne de PEC
PEC et DD sont généralement incompatibles, sauf si la caractérisation du bruit utilisée pour PEC est effectuée avec DD actif. PEC suppose que est stationnaire, reproductible et caractérisable avec précision. DD remodèle explicitement le canal de bruit dans le temps en modulant les interactions système-environnement et en introduisant des effets de minutage d'impulsions non triviaux. En conséquence, le bruit effectif avec DD n'est pas le même canal que sans DD. Cela est encore compliqué par le fait que le canal de bruit peut dépendre fortement de l'ordonnancement du Circuit. Au final, l'inversion du bruit devient mal définie ou invalide.
Il est théoriquement possible de caractériser le bruit avec DD actif et de construire un modèle PEC en conséquence, mais c'est très avancé et ce n'est pas actuellement un workflow recommandé.
Appliquer PEC à la main
PEC est complexe et il n'est pas recommandé de l'implémenter à la main. Néanmoins, nous voulons dérouler les calculs d'une application de base sur un seul Qubit pour comprendre les étapes du processus. Nous choisissons un état mixte mais non trivial afin de bien voir les effets numériques.
Prenons un Qubit qui devrait se trouver dans l'état pur
La matrice densité idéale est :
Nous avons choisi cette matrice densité parce qu'elle n'est pas diagonale et ne concerne qu'un seul Qubit, ce qui permet de l'examiner « à la main ».
Nous appliquons maintenant un modèle de bruit très simple mais réaliste : un canal dépolarisant à un Qubit, de faible intensité .
Pour simplifier les calculs, prenons . Ce canal est complètement positif et préserve la trace (CPTP), comme il se doit. C'est un canal de bruit réaliste pour du matériel réel, ou du moins pour décrire une partie du bruit. De plus, ce canal de bruit est analytiquement inversible, en tant qu'application linéaire. En d'autres termes, il existe une matrice inverse, mais cela ne signifie pas que cette matrice correspond à un canal physique CPTP, et elle ne correspond certainement pas à une unitaire qui pourrait être implémentée sur du matériel.
Appliquons maintenant notre canal de bruit dépolarisant à notre matrice densité à un Qubit, ce qui donne :
Avec : et .
So:
En l'appliquant à notre état :
Calculons explicitement :
C'est toujours une matrice densité physique, et sa trace vaut toujours un — mais elle est désormais plus mélangée.
Calculons maintenant le canal inverse idéal, en étant bien préparés à la possibilité qu'il ne soit pas physique. Nous vérifierons si c'est le cas. Mathématiquement, l'application linéaire inverse est :
Si cette action inverse était elle-même un canal physique valide, nous serions tentés de l'implémenter exactement. Bien sûr, il faudrait encore trouver comment l'implémenter à l'aide d'opérations unitaires et d'étapes classiques, mais ce serait l'objectif. Cependant, il s'avère qu'elle n'est pas CPTP, et rien ne garantit en général que de telles applications inverses soient CPTP. C'est essentiel pour notre discussion, car c'est la raison d'être de PEC.
Tu peux peut-être voir qu'elle n'est pas CPTP rien qu'en la regardant. Une vérification infaillible consiste à l'appliquer à une matrice densité et à voir si elle renvoie des résultats physiques. Nous laissons cela en exercice pour vérifier ta compréhension.
Vérifie ta compréhension
Vérifie si l'application inverse ci-dessus est CPTP en l'appliquant à une nouvelle matrice densité :
Interprète les résultats comme physiques ou non physiques.
Réponse
En tant que matrice densité physique, cela correspond à une probabilité classique supérieure à 1 que le système soit dans l'état et à une probabilité négative qu'il soit dans l'état . Cette application peut clairement produire des matrices densité absurdes. De plus, on voit par inspection que les valeurs propres de la matrice densité obtenue sont 1.0625 et -0.0625, ce qui signifie que toutes les valeurs propres ne sont pas positives. L'application n'est donc pas « complètement positive », le « CP » de CPTP.
Vérifie ta compréhension
Vérifie par un calcul explicite que l'opération inverse ci-dessus annule le canal de bruit et restitue l'état sans bruit.
Réponse
Appliquons-la à l'état bruité :
C'est exactement l'état d'origine (à l'arrondi près).
Nous le répétons pour être absolument clairs : nous ne pouvons pas inverser exactement le canal de bruit ; l'inverse n'est pas CPTP, ni un canal physique valide. Cependant, nous pouvons effectivement inverser le canal sous forme de combinaison linéaire de canaux physiques.
Pour le canal dépolarisant :
où : , etc.
L'inverse peut s'écrire :
with:
-
= canaux de Clifford implémentables physiquement
-
= quasi-probabilités
-
Some
C'est l'idée centrale de PEC :
-
Échantillonner les canaux selon ∣
-
Attribuer des signes aux résultats de mesure
-
Les valeurs moyennes convergent vers la valeur sans bruit
Nous appliquons PEC « à la main » à l'estimation de en utilisant la matrice densité et nous voyons si nous pouvons retrouver les résultats de . Pour , nous attendons :
Notons aussi que pour la matrice densité bruitée, nous obtenons :
C'est le bon ordre de grandeur, mais très éloigné du cas idéal.
Voyons maintenant comment, avec le processus PEC, nous pouvons reconstruire la valeur moyenne non biaisée à partir de la matrice densité bruitée. Dans les workflows réels, cela est probabiliste et automatisé. Dans ce workflow « à la main », nous choisirons des valeurs probabilistes réalistes, mais peut-être commodes pour notre présentation. Cela ne doit pas être interprété comme une affirmation que PEC est parfaite. Il s'agit simplement de te montrer un scénario plausible qui pourrait se produire à l'intérieur des packages PEC.
Rappelons que notre canal de bruit est de la forme :
L'inverse peut s'écrire (exactement) :
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Pour cette introduction, il est plus simple de se concentrer sur l'effet du canal sur notre matrice densité. Cela nous permet de travailler avec des objets familiers comme les matrices densité et les valeurs moyennes. Pour cela, considérons ce qui doit être vrai des effets de cette opération inverse sur notre processus d'estimation : l'estimateur produit par PEC doit être normalisé et non biaisé. Cela correspond à deux conditions :
-
Normalisation : pour garantir que cette opération ne change pas l'échelle de l'observable, nous exigeons que . Pour comprendre pourquoi, nous pourrions soit considérer l'action de l'inverse sur une matrice densité, soit considérer son action sur la valeur moyenne d'un objet trivial comme lui-même.
-
Calibration : dans un workflow réel, nous utilisons des Circuits de calibration pour apprendre le comportement du bruit au niveau des Gates. Nous utilisons ensuite cette connaissance du bruit au niveau des Gates, ainsi que la linéarité des valeurs moyennes, pour appliquer le modèle de bruit appris au Circuit plus grand. Dans notre cas, nous sommes partis de la connaissance artificielle que la valeur moyenne idéale est . Mais il serait très facile de trouver un état pour lequel nous savons théoriquement que ce serait la valeur idéale, puis d'utiliser de vraies mesures pour la calibration. Un point clé est que, pour PEC, on n'apprend généralement pas un modèle de bruit complet de tout le Circuit. On apprend plutôt des modèles de bruit locaux pour des Gates ou des couches de Circuit individuelles, et on les utilise pour construire la décomposition en quasi-probabilités.
Nous utilisons ces conditions pour déterminer et . Nous considérons l'ansatz
and apply it to an arbitrary single-qubit density matrix .
Rappelons que les canaux de Pauli agissent par conjugaison :
L'application de à donne :
En prenant la trace, nous obtenons :
Chaque opérateur de Pauli est unitaire, de sorte que la conjugaison préserve la trace :
Therefore,
Pour que l'estimateur PEC soit normalisé, l'application inverse effective doit préserver la trace de toutes les matrices densité. C'est-à-dire que nous exigeons :
Cela implique la contrainte de normalisation :
Mais dans notre cas, cela donne la condition :
Nous utilisons maintenant les informations de calibration pour relier la valeur moyenne observée à la valeur idéale connue.
Or equivalently,
En résolvant nos deux conditions pour et , nous obtenons :
Ces coefficients ont pour somme 1, mais l'un d'eux est négatif.
Nous pouvons retrouver la valeur moyenne idéale en modifiant aléatoirement le Circuit, en mesurant, en multipliant le résultat par un poids signé, puis en faisant la moyenne. En particulier, aucune matrice densité n'est reconstruite et aucun canal inverse n'est implémenté physiquement.
L'étape clé : c'est PEC
Pour notre intensité de bruit , le canal inverse peut s'écrire :
Faits importants :
-
Les coefficients ont pour somme 1
-
Un coefficient est négatif
-
Chaque terme est implémentable physiquement
-
La négativité est reportée dans le post-traitement classique
Nous formons une distribution d'échantillonnage à partir des valeurs absolues des poids :
(pour chacun de X, Y, Z)
Poids total :
Pour obtenir les probabilités d'échantillonnage, divise par W.
| Opération | Probabilité | Signe |
|---|---|---|
| Ne rien faire () | 1.1875 / 1.375 ≈ 0.864 | + |
| Appliquer X | 0.0625 / 1.375 ≈ 0.045 | - |
| Appliquer Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Appliquer Z | 0.0625 / 1.375 ≈ 0.045 | - |
Le signe provient du coefficient d'origine, pas de la probabilité.
Chaque shot se compose des étapes suivantes :
-
Préparer l'état
-
Laisser le matériel appliquer le Circuit bruité
-
Choisir aléatoirement une opération dans le tableau ci-dessus selon les probabilités associées
-
Apply it
-
Mesurer , ce qui donne
-
Multiplier le résultat par
-
Enregistrer ce nombre
Voyons maintenant des exemples de plusieurs shots.
Shot 1 (cas de l'identité)
Supposons que l'opération choisie aléatoirement soit l'identité (ou, de façon équivalente : ne rien faire). D'après les arguments et le tableau ci-dessus, cela se produit dans 86,4 % des cas. Comme le coefficient de dans l'inverse du canal de bruit est positif, nous sélectionnons le signe . Notre mesure de Z pourrait tout aussi bien donner . Supposons qu'elle donne .
La contribution corrigée par PEC de ce shot serait :
Shot 2 (à nouveau l'identité)
Supposons que nous obtenions à nouveau comme opération aléatoire (le signe du terme est donc toujours au départ), mais que cette fois notre mesure de Z donne . Cette fois, la contribution est :
Shot 3 (X choisi)
Cette fois, notre opération aléatoire est X. Ce terme de l'inverse est négatif, donc nous gardons un signe . Nous appliquons X puis mesurons Z. Là encore, nous pourrions obtenir l'une ou l'autre valeur propre ; disons que nous obtenons . La contribution de ce terme est :
Shot 4 (Z choisi)
L'opération aléatoire est Z. Cela nous donne un signe d'après le tableau. Supposons que nous mesurions Z et obtenions . La contribution est :
Shot 5 (Y choisi)
L'opération aléatoire est Y. Cela nous donne un signe d'après le tableau. Supposons que nous mesurions Z et obtenions . La contribution est :
Moyenne des résultats
Imaginons que nous collections de nombreux résultats pondérés par PEC de ce type :
Par construction, nous appliquons l'identité dans 86,4 % des cas. Nous appliquons chacune des autres Gates dans 4,5 % des cas. Dans un workflow réel, nous ne connaissons ni les états sous-jacents précis, ni l'ensemble du canal de bruit. Mais nous connaissons le facteur de pondération ci-dessus, ainsi que la probabilité relative avec laquelle nous appliquons chaque opération. Dans un workflow réel, nous nous appuyons sur la matrice densité inconnue pour obtenir les résultats de mesure. Nous allons vérifier ici que cette procédure donnerait les bons résultats.
Nous voulons calculer la moyenne de toutes les mesures pondérées et signées, y compris les applications d'opérateurs de Pauli avant la mesure. Appelons le nombre total de shots. Appelons l'ensemble des shots pour lesquels le Pauli a été appliqué et utilisons pour indexer ces shots. Appelons le résultat de mesure du shot sous l'application du Pauli. Nous pouvons écrire cette moyenne ainsi :
L'opérateur de Pauli est appliqué de façon probabiliste avec la probabilité . Dans la limite d'un grand nombre de shots,
Nous pouvons l'utiliser pour écrire :
où est la valeur moyenne de Z uniquement sur l'ensemble des shots où a été appliqué. C'est utile parce que nous savons ce que chacune de ces valeurs moyennes doit valoir d'après la matrice densité. Là encore, dans un workflow réel, elle proviendrait de la mesure, et non d'une matrice densité connue.
Vérifie ta compréhension
Vérifie les valeurs moyennes ci-dessus par le calcul ou par un raisonnement logique.
Réponse
Y et Z se déroulent exactement comme ci-dessus.
Nous pouvons maintenant réécrire notre valeur moyenne globale ainsi :
Si nous connaissons les paramètres et du bruit de nos Gates (ou davantage de paramètres pour des canaux de bruit plus complexes), cela suffit pour déterminer (1) le facteur de poids global et (2) les probabilités avec lesquelles nous devons appliquer les opérateurs de Pauli. Ce que montre le résultat ci-dessus, c'est qu'en procédant ainsi, nous atténuons le bruit et retrouvons des valeurs moyennes non biaisées. La moyenne sur tous ces shots a convergé vers , alors même que :
-
Les shots individuels apportent des contributions supérieures à ±1
-
Certains shots ont un poids statistique négatif
-
Chaque opération quantique était physique
Aperçu du workflow PEC
Dans la PEC, toutes les étapes exécutées sur l'ordinateur quantique sont :
-
Apprentissage du bruit
-
Préparation de l'état pour ton Circuit cible
-
Application probabiliste de Gates de Pauli, comme décrit ci-dessus
-
Measurement
L'application de bruit inverse effective est réalisée statistiquement lors du post-traitement classique. Cela permet une inversion plus générale de canaux de bruit qui aurait sinon nécessité des étapes non physiques, comme des probabilités négatives.
Le prix à payer est la variance. Chaque shot avait auparavant une « magnitude » égale aux magnitudes des résultats de mesure possibles . Après mise à l'échelle par le facteur de poids , sa magnitude est (1,375 dans notre exemple ci-dessus).
C'est l'origine du surcoût d'échantillonnage de la PEC.
PEC intégrée
Nous allons maintenant utiliser la PEC telle qu'elle est intégrée aux primitives IBM Quantum. Il est essentiel ici de distinguer la PEC complète au niveau des Gates d'un modèle local d'apprentissage du bruit pour une PEC plus scalable, qui est celui utilisé par les primitives IBM Quantum. Le surcoût de la PEC complète limiterait son application à de petits Circuits. C'est acceptable, mais il est plus utile de disposer d'un outil capable de passer à l'échelle jusqu'à une taille à laquelle le calcul quantique devient précieux pour des problèmes du monde réel. Pour cette raison, les primitives IBM Quantum utilisent une PEC par couche, fondée sur un modèle de bruit de Pauli-Lindblad appris, avec des garde-fous de scalabilité agressifs. Dans cette implémentation de la PEC, le bruit est appris par couche de Circuit répétée, et non par instance de Gate, et le modèle de bruit est twirlé de Pauli, local et markovien. Les Gates de Clifford sont absorbées dans le modèle de bruit, tandis que les Gates non Clifford dominent le coût de l'atténuation. Le surcoût d'échantillonnage est plafonné pour éviter des explosions exponentielles.
Nous appliquerons la PEC intégrée aux primitives IBM Quantum à deux échelles : petite (six qubits) et moyenne (30 qubits), afin de voir comment le coût reste maîtrisé dans cette version de la PEC. Pour chaque taille d'expérience, nous comparerons aussi explicitement les résultats de la PEC à ceux sans atténuation, avec la ZNE, et à la valeur idéale.
Nous commençons par importer quelques paquets nécessaires.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Nous choisissons une observable à estimer. L'observable ci-dessous est l'hamiltonien d'une chaîne de spins de type Ising, avec un couplage aux plus proches voisins uniquement dans la composante de leur interaction, et un terme à un seul qubit en , comme dû à un champ externe selon .
Il n'y a pas de raison particulière de choisir cet hamiltonien. Nous avons simplement besoin d'une combinaison d'une observable et d'un Circuit non triviale pour que l'atténuation d'erreurs puisse faire son travail. Nous mettons explicitement l'hamiltonien à l'échelle (à l'aide des coefficients), en divisant par le nombre de qubits afin que l'énergie reste du même ordre de grandeur lorsque nous augmentons le nombre de qubits. Nous commençons avec seulement six.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Comme pour le choix de l'hamiltonien, le Circuit de préparation d'état ci-dessous n'est pas choisi pour des raisons physiques. Il est plutôt choisi pour avoir une profondeur à deux qubits suffisante et suffisamment de Gates non Clifford pour que la PEC puisse être utile. Rien ne permet de penser que ce Circuit soit une bonne approximation de l'état fondamental de cette chaîne de spins, par exemple.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
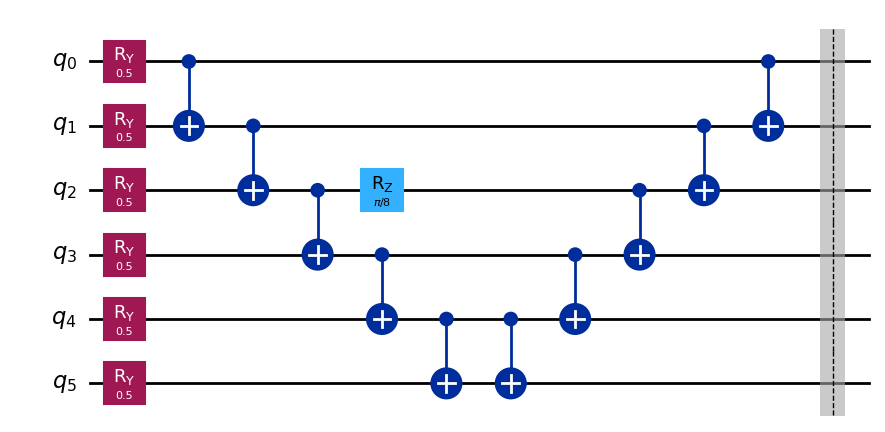
Nous transpilons notre Circuit et appliquons le layout obtenu à nos observables.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Nous obtenons la valeur moyenne idéale à l'aide du simulateur Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Nous nous attendons à ce que les autres valeurs idéales soient de taille similaire. Nous exécutons maintenant ceci sur un véritable ordinateur quantique IBM sans aucune atténuation d'erreurs.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Nous appliquons maintenant la ZNE au même problème.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Enfin, nous appliquons la PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Ci-dessous, nous traçons nos résultats et les comparons.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
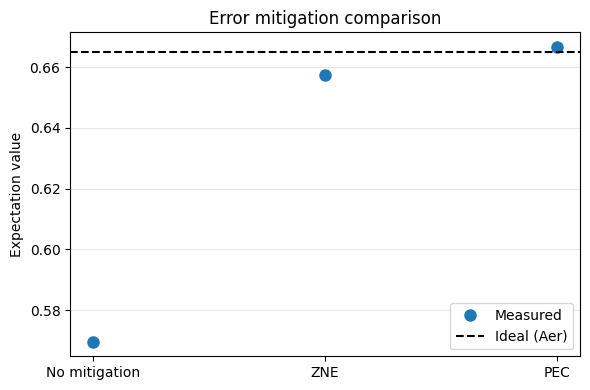
Cela a très bien fonctionné. Notre estimation avec la PEC n'est qu'à 0,2 % de la valeur idéale.
Mais souviens-toi que le surcoût quantique croît de façon exponentielle. Nous avons imposé un surcoût maximal de max_overhead = 100. D'après le temps d'exécution et la qualité des résultats, il semble que nous n'ayons peut-être pas atteint ce maximum. Cependant, si nous augmentons l'échelle de notre calcul en conservant ce maximum, nous l'atteindrons, et nos résultats en souffriront.
Nous pouvons voir ce qui se passe lorsque nous passons notre Circuit à 30 qubits. Fait intéressant, sur de nombreux ordinateurs portables, le simulateur Statevector commence à dépasser le délai autour de 24-28 qubits. Nous pourrions trouver des moyens de contourner cela par le calcul. Mais acceptons au contraire le fait que les ordinateurs quantiques pourront résoudre certains problèmes à une échelle que les ordinateurs classiques ne peuvent pas suivre. C'est tout l'intérêt. Que pouvons-nous alors faire pour valider nos résultats de calcul quantique dans ces cas ? Il existe plusieurs réponses possibles :
- Certains problèmes sont difficiles à résoudre mais faciles à vérifier (comme la factorisation en nombres premiers dans l'algorithme de Shor).
- Certains problèmes ont des régimes de paramètres ou des variantes dont la complexité diminue et qui peuvent être résolus classiquement, voire analytiquement, pour comparer quelques points. Dans ce cas, nous avons choisi un hamiltonien intrinsèque (nous avons divisé par le nombre de qubits). La valeur moyenne idéale devrait être assez stable. Voyons comment la valeur moyenne idéale varie avec le nombre de qubits et si nous pouvons faire des prédictions classiques sur la valeur à 30 qubits.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
En effet, nous constatons que nous avons choisi un hamiltonien et un état qui ne changent pas avec le nombre de qubits. C'est un très mauvais usage pour une application de recherche du calcul quantique, mais un excellent usage pour évaluer les techniques d'atténuation d'erreurs. Nous pouvons utiliser en toute confiance cette valeur moyenne fixe comme résultat idéal, même lorsque nous augmentons le nombre de qubits pour tester l'atténuation d'erreurs.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Nous exécutons maintenant ce Circuit plus grand avec la ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Enfin, nous exécutons l'exemple à 30 qubits avec la PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
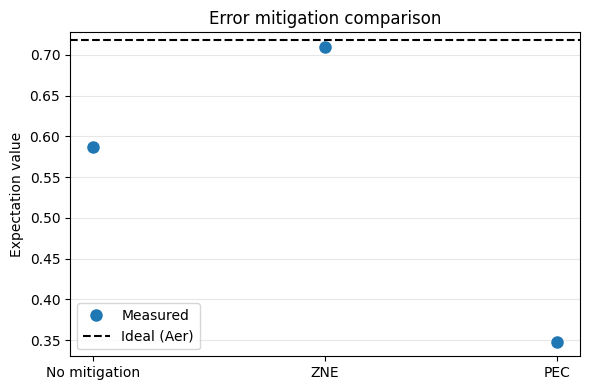
Non seulement la PEC a pris beaucoup plus de temps que les autres options, mais nous avons clairement atteint notre seuil de surcoût maximal. Les résultats de la PEC ont payé le prix du surcoût, mais le plafond de surcoût a empêché une annulation suffisamment précise du modèle de bruit appris. C'est essentiel. Avec six qubits, nous avons pu tirer parti de la PEC et obtenir de meilleurs résultats avec une augmentation modeste du surcoût quantique (environ un facteur 5). Avec 30 qubits, nous avons payé un prix bien plus élevé (environ 60 fois plus) et les résultats étaient encore pires que l'estimation sans atténuation. Cela ne veut pas dire que la PEC ne peut jamais fonctionner avec 30 qubits ; cela peut dépendre du Circuit. Le message est simplement que la croissance exponentielle du surcoût quantique rend l'exécution difficile pour de grands Circuits.
Points clés à retenir :
-
L'atténuation des erreurs de mesure aide souvent et entraîne généralement un faible surcoût : elle supprime un biais qui ne croît pas avec la profondeur du Circuit et se combine proprement avec presque tout.
-
Certaines techniques ne peuvent pas être combinées. Même lorsqu'elles le peuvent, assure-toi de les combiner de manière cohérente pour que l'une n'annule pas l'autre. Un bon exemple consiste à vérifier que le twirling est activé pendant la calibration de M3 si ces méthodes doivent être combinées.
-
La PEC et la ZNE doivent être considérées comme des alternatives l'une à l'autre. Elles résolvent le même problème avec des compromis opposés :
-
PEC : fournit des valeurs moyennes non biaisées au prix d'une variance exponentielle.
-
La ZNE fournit généralement un biais résiduel qui dépend du modèle d'extrapolation, mais à un coût modéré.
-
-
Le DD peut aider lors de longues périodes d'inactivité, mais il remodèle le modèle de bruit et peut invalider les hypothèses d'extrapolation ou d'inversion.
-
Le Pauli twirling ne réduit pas le bruit. Il le remodèle et permet souvent à d'autres techniques de mieux fonctionner (ZNE et PEC).