Simuler la diffusion de neutrons avec un workflow Serverless AQC + dynamique de Trotter
Estimation d'utilisation : 18 minutes sur un processeur Heron r3 (REMARQUE : ceci n'est qu'une estimation. Ton temps d'exécution peut varier.)
Résultats d'apprentissage
-
Comment un spectre de diffusion inélastique de neutrons correspond au facteur de structure dynamique d'un aimant quantique 1D.
-
Comment préparer l'état fondamental de KCuF (Heisenberg isotrope) avec le groupe de renormalisation de matrice densité (DMRG) et la maximisation de fidélité par état de produit matriciel (MPS).
-
Comment exécuter l'évolution temporelle de Trotter, la compression de circuit par compilation quantique approximative (AQC), et l'exécution atténuée en un seul appel de fonction.
-
Comment post-traiter la série temporelle par site en et identifier le continuum à deux spinons.
Prérequis
-
Familiarité avec les Qiskit patterns,
SparsePauliOp, et l'évolution temporelle de Trotter. -
Une exposition de base aux méthodes de réseaux de tenseurs (DMRG et MPS) est utile mais pas requise, tout comme la familiarité avec la bibliothèque
qiskit-addon-aqc-tensorque la fonction utilise pour comprimer les circuits de Trotter.
Contexte
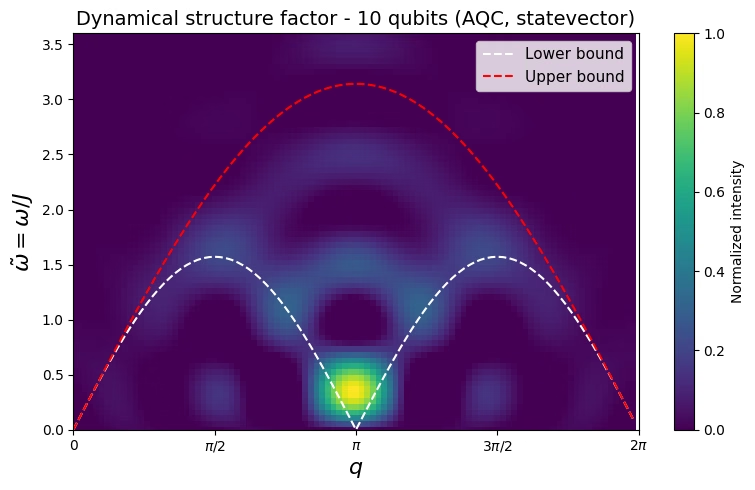
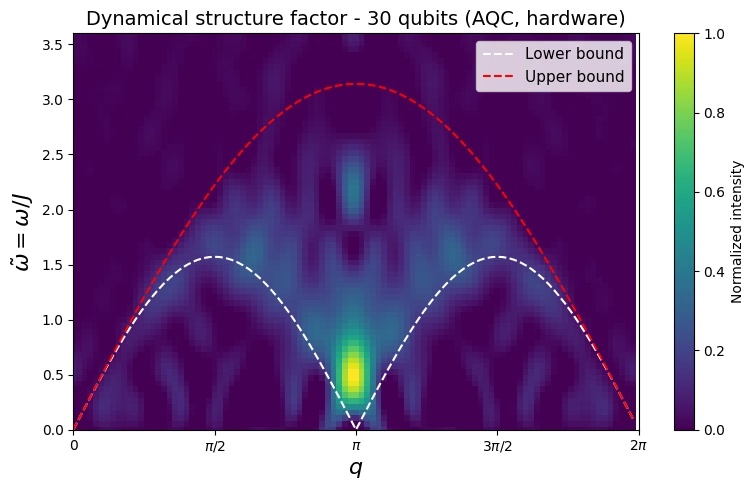
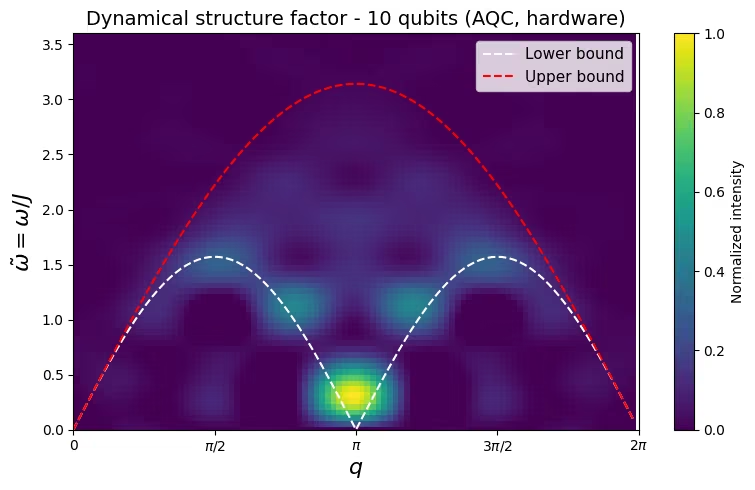
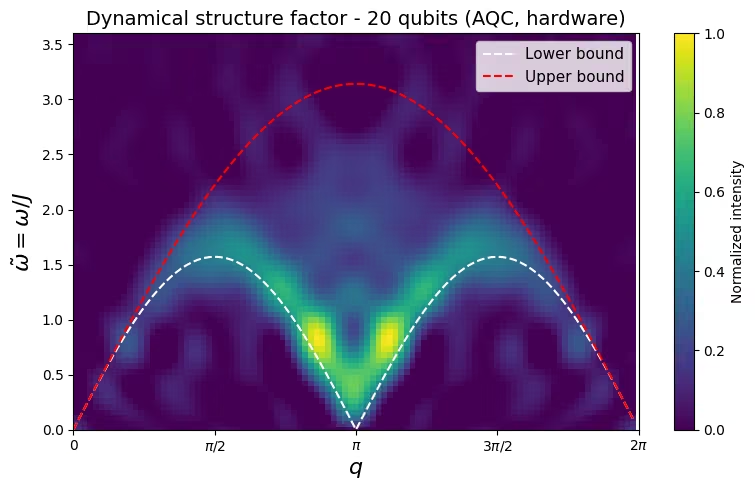
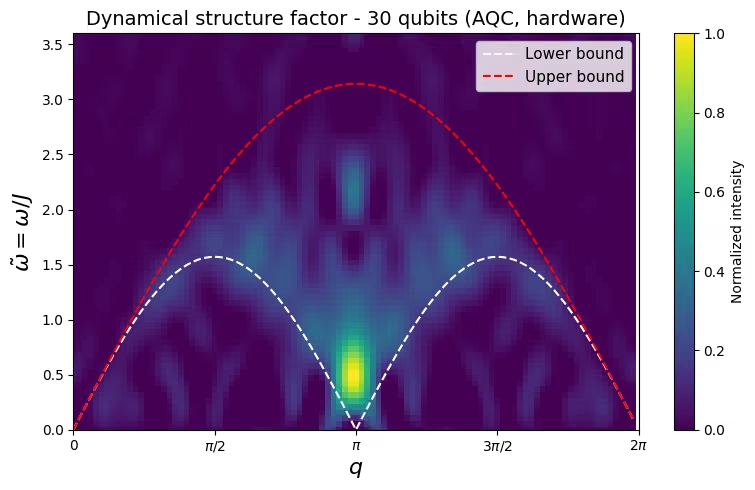
La diffusion inélastique de neutrons mesure le facteur de structure dynamique , la transformée de Fourier spatio-temporelle de la fonction de corrélation spin-spin, de sorte que reproduire à partir d'un modèle de spin microscopique constitue un test direct et falsifiable d'une simulation quantique. Ce tutoriel étudie KCuF, une chaîne de Heisenberg antiferromagnétique de spin- dont les excitations ne sont pas de simples retournements de spin mais des paires de spinons fractionnalisés : au lieu d'une dispersion de magnon nette, montre un large continuum à deux spinons, borné en dessous par et au-dessus par . Ce sont les courbes en pointillés sur les graphiques qui suivent. La physique complète, ainsi que la comparaison avec les données neutroniques mesurées, sont couvertes dans le tutoriel original et dans Lee et al., arXiv:2603.15608.
Le workflow quantique reflète l'expérience de diffusion :
-
Préparer l'état fondamental de la chaîne .
-
Le perturber localement au site central, une rotation de , imitant le transfert d'impulsion et d'énergie du neutron.
-
Faire évoluer dans le temps sous l'hamiltonien de Heisenberg, , avec une formule de produit de Trotter.
-
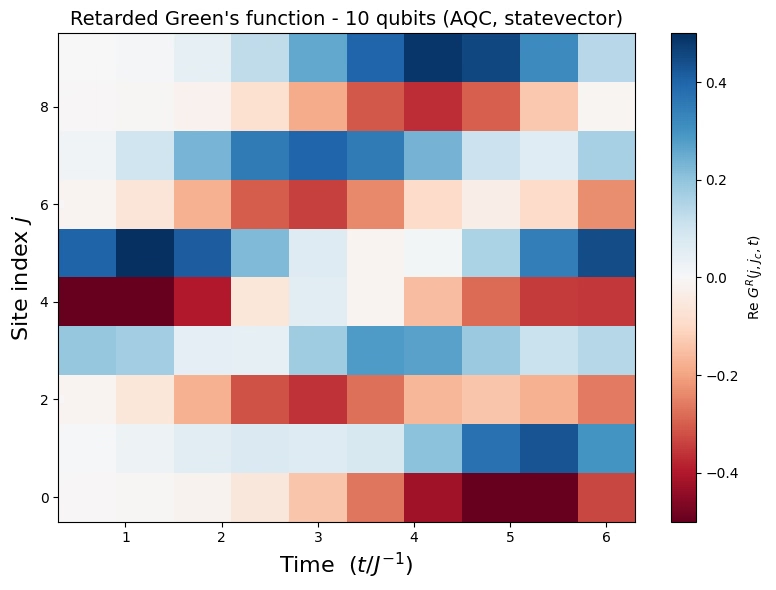
Mesurer l'aimantation par site . En fonction du site et du temps , c'est exactement la fonction de Green retardée , donc aucune conversion n'est nécessaire avant la transformée de Fourier à l'étape 5.
-
Transformer par Fourier en .
Des problèmes peuvent survenir à l'étape 3, lorsque les circuits de Trotter exacts pour des évolutions longues deviennent trop profonds pour le matériel. L'AQC avec des réseaux de tenseurs résout ce problème en comprimant un bloc d'étapes de Trotter en un ansatz paramétré fixe et peu profond dont la fidélité d'état par rapport à l'évolution exacte est maximisée de manière classique avec un simulateur MPS (arXiv:2301.08609). Le modèle AQC Dynamics regroupe tout ce cœur quantique (synthèse de Trotter, compression AQC et exécution atténuée) derrière un seul appel :
| PRÉ (ce notebook) | FONCTION (aqc-dynamics-function) | POST (ce notebook) |
|---|---|---|
| État fondamental obtenu par DMRG plus maximisation de fidélité MPS, avec le coup de neutron intégré dans le même circuit | Synthèse de Trotter → compression AQC → exécution sur statevector, fake, ou runtime, renvoyant par site | , le facteur de structure dynamique |
Le travail spécifique à l'expérience reste ici dans le notebook : préparation de l'état fondamental (PRÉ) et post-traitement (POST). Les deux étapes intensives en calcul quantique, compression et exécution, s'exécutent à l'intérieur de la fonction.
Ce tutoriel est complémentaire à Simuler la diffusion de neutrons dans les matériaux quantiques avec des circuits quantiques, qui construit la même expérience en ligne : le même modèle KCuF, la préparation de l'état fondamental, le coup de neutron et le post-traitement, avec la synthèse de Trotter, la compression AQC et l'exécution atténuée écrites étape par étape. Lis ce tutoriel pour comprendre comment fonctionne la compression AQC. Lis celui-ci pour exécuter la même expérience via un modèle de fonction déployé : le cœur quantique devient un seul appel de fonction, et la compression AQC de plusieurs heures s'exécute dans le worker Serverless plutôt que sur ta machine, donc tu n'as pas besoin d'un système HPC ni d'un kernel ouvert pendant son exécution. Le même appel pilote également d'autres expériences de dynamique 1D.
Prérequis
Avant de commencer ce tutoriel, assure-toi d'avoir les éléments suivants :
-
La fonction déployée sur ton compte Qiskit Serverless. Exécute d'abord le modèle de fonction associé : Déployer et exécuter le modèle de fonction AQC + dynamique de Trotter. Ce guide t'explique comment obtenir les fichiers source et téléverser la fonction sur ton compte. Ce tutoriel ne fait qu'appeler la fonction déployée.
-
Les identifiants IBM Quantum® enregistrés pour
QiskitServerless(voir le modèle de fonction). Les deux exemples de ce tutoriel appellent la fonction déployée, donc les deux en ont besoin. -
Qiskit SDK v2.0 ou ultérieur (
pip install qiskit). -
Le client Qiskit IBM Catalog (
pip install qiskit-ibm-catalog). -
NumPy, SciPy et Matplotlib (
pip install numpy scipy matplotlib). SciPy 1.14 ou ultérieur est nécessaire pour l'optimiseur COBYQA utilisé dans la préparation de l'état fondamental. -
La pile de réseaux de tenseurs AQC, car la préparation de l'état fondamental à l'étape 1 s'exécute localement dans ce notebook :
pip install 'qiskit-addon-aqc-tensor[quimb-jax]==0.3.1'.
Le premier appel à une fonction nouvellement déployée attend pendant que le worker Serverless installe ses dépendances, il faut donc s'attendre à une latence supplémentaire lors de cette exécution.
Configuration
Importe les bibliothèques et définis les fonctions d'aide spécifiques à l'expérience utilisées plus tard : build_gs_ansatz (l'ansatz variationnel hamiltonien, ou HVA, pour la préparation de l'état fondamental), prepare_ground_state (DMRG plus maximisation de fidélité MPS), et get_spectrum, plot_green, et plot_spectrum (le post-traitement ). Ceux-ci sont adaptés du tutoriel original sur la diffusion de neutrons.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-addon-aqc-tensor qiskit-ibm-catalog quimb scipy
from functools import partial

import matplotlib.pyplot as plt
import numpy as np
import scipy.optimize

import quimb.tensor as qtn
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_addon_aqc_tensor.simulation import tensornetwork_from_circuit
from qiskit_addon_aqc_tensor.simulation.quimb import QuimbSimulator
from qiskit_ibm_catalog import QiskitServerless
#  Dynamical structure factor via discrete Fourier transform

def get_spectrum(n, Gjjc, dt, time_steps, q_steps, w_steps):
    """Compute the dynamical structure factor from the retarded Green's function.

    Uses the center-site approximation and a discrete Fourier transform.
    """
    green = Gjjc / 4  # sigma -> S=1/2
    omega_max = np.pi / dt
    qpoints = np.arange(0, 2 * np.pi, 2 * np.pi / q_steps)
    omegas = np.arange(0, omega_max, omega_max / w_steps)
    green_map = np.zeros((omegas.shape[0], qpoints.shape[0]))
    center = n // 2 - 1
    for iw, w in enumerate(omegas):
        exponent = np.exp(1j * w * dt * np.arange(1, time_steps + 1))
        S_w = np.dot(green.T, exponent) * dt
        for iq, q in enumerate(qpoints):
            q_matrix = np.exp(-1j * q * np.arange(-center, center + 2, 1))
            green_map[iw, iq] = np.imag(np.dot(S_w, q_matrix))
    return green_map

#  Plotting helpers

def plot_spectrum(
    dsf,
    dt,
    q_steps,
    w_steps,
    lower_bound=False,
    upper_bound=False,
    title=None,
):
    """Heat-map of the dynamical structure factor."""
    omega_max = np.pi / dt
    qpoints = np.arange(0, 2 * np.pi, 2 * np.pi / q_steps)
    omegas = np.arange(0, omega_max, omega_max / w_steps)
    x, y = np.meshgrid(qpoints, omegas)
    fig, ax = plt.subplots(figsize=(8, 5))
    c = ax.pcolormesh(x, y, dsf / np.max(dsf), cmap="viridis", shading="auto")
    fig.colorbar(c, ax=ax, label="Normalized intensity")
    if lower_bound:
        ax.plot(
            qpoints,
            np.pi * np.abs(np.sin(qpoints)) / 2,
            "--",
            color="white",
            lw=1.5,
            label="Lower bound",
        )
    if upper_bound:
        ax.plot(
            qpoints,
            np.pi * np.abs(np.sin(qpoints / 2)),
            "--",
            color="red",
            lw=1.5,
            label="Upper bound",
        )
    ax.set_ylim(0, 3.6)
    ax.set_xlim(0, 2 * np.pi - 2 * np.pi / q_steps)
    ax.set_xlabel(r"$q$", fontsize=16)
    ax.set_ylabel(r"$\tilde{\omega} = \omega / J$", fontsize=16)
    ax.set_xticks([0, np.pi / 2, np.pi, 3 * np.pi / 2, 2 * np.pi])
    ax.set_xticklabels(["0", r"$\pi/2$", r"$\pi$", r"$3\pi/2$", r"$2\pi$"])
    if lower_bound or upper_bound:
        ax.legend(loc="upper right", fontsize=11)
    if title:
        ax.set_title(title, fontsize=14)
    plt.tight_layout()
    plt.show()

def plot_green(n, Gjjc, time_steps, dt, title=None):
    """Heat-map of the retarded Green's function in real space and time."""
    fig, ax = plt.subplots(figsize=(8, 6))
    t_axis = np.arange(1, time_steps + 1) * dt
    site_axis = np.arange(n)
    x, y = np.meshgrid(t_axis, site_axis)
    c = ax.pcolormesh(
        x,
        y,
        np.real(Gjjc).T,
        cmap="RdBu",
        vmax=0.5,
        vmin=-0.5,
        shading="auto",
    )
    fig.colorbar(c, ax=ax, label=r"Re $G^R(j, j_c, t)$")
    ax.set_xlabel(r"Time  ($t / J^{-1}$)", fontsize=16)
    ax.set_ylabel("Site index $j$", fontsize=16)
    if title:
        ax.set_title(title, fontsize=14)
    plt.tight_layout()
    plt.show()

#  Variational ground-state ansatz (HVA)

def _apply_xxz_pair_gate(qc, q0, q1, theta):
    """Apply the parameterized XXZ-type two-qubit gate used in the HVA."""
    qc.cx(q0, q1)
    qc.rz(theta, q1)
    qc.h(q0)
    qc.rz(theta + np.pi / 2, q0)
    qc.cx(q0, q1)
    qc.rz(-theta, q1)
    qc.h(q1)
    qc.cx(q1, q0)
    qc.rz(np.pi / 2, q1)
    qc.rz(-np.pi / 2, q0)
    qc.h(q1)
    qc.h(q0)

def build_gs_ansatz(n, params, layers):
    """Build the Hamiltonian variational ansatz (HVA) circuit for
    ground-state preparation of the 1D Heisenberg model.

    Starts from a product of singlet pairs and applies alternating
    odd/even layers of parameterized XXZ gates. For layer r,
    params[2 * r] is the odd-layer (inter-pair) angle and
    params[2 * r + 1] is the even-layer (intra-pair) angle.
    """
    qc = QuantumCircuit(n)
    # Initial singlet product state
    for i in range(n // 2):
        qc.x(2 * i)
        qc.x(2 * i + 1)
        qc.h(2 * i + 1)
        qc.cx(2 * i + 1, 2 * i)
    # Variational layers
    for r in range(layers):
        for i in range(1, (n + 1) // 2):  # odd layer
            _apply_xxz_pair_gate(qc, 2 * i - 1, 2 * i, params[2 * r])
        for i in range(n // 2):  # even layer
            _apply_xxz_pair_gate(qc, 2 * i, 2 * i + 1, params[2 * r + 1])
    return qc

def prepare_ground_state(n, gs_layers=5, max_bond=128, cutoff=1e-8):
    """Prepare the KCuF3 (isotropic Heisenberg) ground state as a QuantumCircuit.

    Runs DMRG (quimb MPO + DMRG2) to get the chain's ground state, then optimizes
    the HVA angles to maximize the MPS overlap |<psi_ansatz|psi_DMRG>|^2. No exact
    diagonalization, so it scales to larger n.
    """
    J = Jz = 1.0
    builder = qtn.SpinHam1D(S=1 / 2)
    builder += J * 0.5, "+", "-"
    builder += J * 0.5, "-", "+"
    builder += Jz, "Z", "Z"
    H_mpo = builder.build_mpo(L=n)
    dmrg = qtn.DMRG2(H_mpo)
    dmrg.solve(tol=1e-8, verbosity=0)

    gs_sim = QuimbSimulator(
        quimb_circuit_factory=partial(
            qtn.CircuitMPS, gate_opts=dict(cutoff=cutoff, max_bond=max_bond)
        ),
        autodiff_backend="jax",
    )

    def gs_infidelity(params):
        psi = tensornetwork_from_circuit(
            build_gs_ansatz(n, params, gs_layers), gs_sim
        ).psi
        return 1 - abs(psi.H @ dmrg.state) ** 2

    # Seed and optimizer match the original tutorial. Each layer starts at
    # [0, pi/2]: an odd-layer angle of 0 makes the inter-pair gate the identity,
    # and an even-layer angle of pi/2 makes the intra-pair gate a SWAP (since
    # 0.5 * (XX + YY + ZZ) = SWAP - I/2). That puts the seed at the singlet-pair
    # product limit, which is already a decent approximation to the Heisenberg
    # ground state, so the optimizer only has to refine it. The small jitter
    # (fixed RNG seed, so runs are reproducible) breaks the exact symmetry
    # between layers; COBYQA then runs for up to 100 iterations.
    rng = np.random.default_rng(12345)
    x0 = np.tile([0.0, np.pi / 2], gs_layers) + rng.normal(
        scale=0.1, size=2 * gs_layers
    )
    result_gs = scipy.optimize.minimize(
        gs_infidelity, x0, method="COBYQA", options={"maxiter": 100}
    )
    print(f"DMRG ground-state energy: {dmrg.energy:.6f}")
    print(f"GS fidelity: {1 - result_gs.fun:.4f}")
    return build_gs_ansatz(n, result_gs.x, gs_layers)

print("Setup complete - helpers defined.")
Setup complete - helpers defined.
Charger le modèle de fonction
Connecte-toi à Qiskit Serverless et charge la fonction aqc-dynamics-function déployée. Les deux exemples de ce tutoriel appellent le même handle fn, donc la fonction n'est chargée qu'une seule fois, ici.
# Credentials are read from the account saved once via QiskitServerless.save_account(...)
serverless = QiskitServerless()
fn = serverless.load("aqc-dynamics-function")
Exemple de simulateur à petite échelle
Nous exécutons d'abord le workflow complet sur une petite chaîne de 10 sites en utilisant le backend statevector exact. Cela valide le pipeline PRÉ → FONCTION → POST avant de dépenser du temps de QPU.
Étape 1 : mapper les entrées classiques sur un problème quantique
Construis l'hamiltonien KCuF comme un SparsePauliOp (Heisenberg isotrope : avec un couplage sur chaque liaison entre plus proches voisins ; les chaînes sont des opérateurs de Pauli, donc donne le couplage de spin-). Prépare l'état fondamental avec DMRG plus maximisation de fidélité MPS, puis intègre le coup de neutron : une rotation de au site central. Le circuit préparé est ce que nous transmettons à la fonction en tant que initial_state. Nous laissons observables à sa valeur par défaut (Z par site), qui est exactement la lecture dont le workflow de neutrons a besoin.
n = 10
dt = 0.6  # physical time per Trotter step (also the omega-axis unit in POST)
time_steps = 10
center = n // 2 - 1

# MPS-simulator settings, shared by the ground-state prep here and the AQC
# compression inside the function (matches the original tutorial).
mps_max_bond = 32
mps_cutoff = 1e-8

# 1D isotropic Heisenberg (KCuF3) Hamiltonian on n qubits
H = SparsePauliOp.from_sparse_list(
    [(p, [i, i + 1], 0.25) for i in range(n - 1) for p in ("XX", "YY", "ZZ")],
    num_qubits=n,
)

# Ground state (DMRG + fidelity max) + neutron kick baked into the same circuit
gs_circuit = prepare_ground_state(
    n, gs_layers=3, max_bond=mps_max_bond, cutoff=mps_cutoff
)
gs_circuit.rz(
    np.pi / 2, center
)  # exp(-i (pi/2)/2 Z_center): the neutron perturbation
print(
    f"Prepared {n}-qubit ground state with the neutron kick at site {center}."
)
DMRG ground-state energy: -4.258035
GS fidelity: 0.9841
Prepared 10-qubit ground state with the neutron kick at site 4.
Étapes 2 et 3 : compresser et exécuter avec le modèle de fonction
Dans un workflow écrit à la main, ce sont deux étapes distinctes : optimiser les circuits pour le matériel (étape 2) et les exécuter (étape 3). Le modèle de fonction condense les deux en un seul appel. Il effectue la synthèse de Trotter, la compression AQC et la transpilation matérielle, puis exécute les circuits (ici sur le simulateur exact, plus tard avec l'atténuation d'erreur intégrée sur le matériel). Les deux paramètres de réglage sont aqc_segments (le plan de compression) et aqc_options (les paramètres MPS et de l'optimiseur). Chaque segment {"n_steps": k, "ansatz_steps": m} comprime k étapes de Trotter consécutives en un ansatz construit à partir d'une cible de Trotter à m étapes, et toute étape au-delà de sum(n_steps) s'exécute comme du Trotter ordinaire. Les premières étapes, à faible intrication, se compriment bien en un ansatz peu profond (ansatz_steps=1), donc ici nous comprimons les trois premières étapes en un ansatz à une seule couche et les deux suivantes en un ansatz plus profond à deux couches ; les cinq étapes restantes des 10 étapes de Trotter s'exécutent comme du Trotter ordinaire. Pour aqc_options, nous reprenons le tutoriel original : dimension de liaison MPS max_bond=32, cutoff=1e-8, et un optimiseur L-BFGS-B plafonné à 100 itérations.
Appelle la fonction chargée dans Setup. backend="statevector" exécute le chemin de référence exact : pas de temps QPU, les circuits s'exécutant sur un simulateur de vecteur d'état exact à l'intérieur du worker serverless (un compte Qiskit Serverless enregistré est tout de même nécessaire pour l'appeler). Le initial_state porte l'état fondamental préparé (y compris le kick) ; observables est omis afin que la fonction mesure le par site par défaut.
job = fn.run(
    t_steps=time_steps,
    aqc_segments=[
        {
            "n_steps": 3,
            "ansatz_steps": 1,
        },  # early steps -> shallow 1-layer ansatz
        {
            "n_steps": 2,
            "ansatz_steps": 2,
        },  # later steps -> deeper 2-layer ansatz
    ],
    aqc_options={
        "max_bond": mps_max_bond,  # MPS bond dimension for AQC compression
        "cutoff": mps_cutoff,
        "optimizer_settings": {
            "method": "L-BFGS-B",
            "jac": True,
            "options": {"maxiter": 100},
        },
    },
    dt=dt,
    hamiltonian=H,
    initial_state=gs_circuit,  # prepared ground state including the neutron kick
    # observables omitted -> default per-site Z (the neutron sigma_z readout)
    backend="statevector",
)
print(job.status()) # rerun this cell until status says DONE
DONE
# The per-site <sigma_z>(t) the function returns is the retarded Green's function
# G(j, j_c, t). The workflow samples t = 1..time_steps, so drop the t = 0 row (the
# prepared+kicked state before any evolution) before post-processing.
result = job.result()
print(
    "AQC fidelities:",
    {k: round(v, 4) for k, v in result["metadata"]["aqc_fidelities"].items()},
)

ev = np.array(result["expectation_values"])
Gjjc = ev[1:]  # shape (time_steps, n)
print("Green's function shape:", Gjjc.shape)
AQC fidelities: {'1': 1.0, '2': 0.9999, '3': 0.9992, '4': 0.9998, '5': 0.9995}
Green's function shape: (10, 10)
Étape 4 : post-traitement et renvoi du résultat au format classique souhaité
Transforme par Fourier la fonction de Green en , symétrise en miroir, et écrête les valeurs négatives : le post-traitement standard pour les neutrons. La symétrisation en miroir est exacte car pour ce modèle, et les valeurs négatives qui subsistent sont des artefacts de la transformation de Fourier d'une série temporelle finie et échantillonnée discrètement, elles sont donc écrêtées à zéro. Sur cette petite exécution exacte, le continuum à deux spinons n'est que grossièrement résolu, mais le mécanisme est identique à l'exécution matérielle qui suit.
q_res, w_res = 100, 100
spectrum = get_spectrum(n, Gjjc, dt, time_steps, q_res, w_res)
spectrum = -(spectrum + spectrum[:, ::-1]) / 2  # mirror symmetry
spectrum = np.clip(spectrum, a_min=0, a_max=None)  # clip negatives

plot_green(
    n,
    Gjjc,
    time_steps,
    dt,
    title=f"Retarded Green's function - {n} qubits (AQC, statevector)",
)
plot_spectrum(
    spectrum,
    dt,
    q_res,
    w_res,
    lower_bound=True,
    upper_bound=True,
    title=f"Dynamical structure factor - {n} qubits (AQC, statevector)",
)
Exemple de matériel à grande échelle
Le même workflow monte en échelle sans modifier aucune ligne du code scientifique : une chaîne de 30 sites, le double de la profondeur de Trotter (20 étapes), un plan de compression qui fait varier la profondeur de l'ansatz (un ansatz plus profond pour les étapes ultérieures, plus intriquées), et une exécution sur un processeur IBM Quantum avec l'atténuation d'erreur intégrée de la fonction (découplage dynamique, twirling de Pauli, et extinction de l'erreur de lecture par torsion (TREX)). Nous parcourons les mêmes quatre étapes que l'exemple du simulateur, en réutilisant le handle fn de Configuration.
| Petite échelle | Grande échelle | |
|---|---|---|
| Qubits | 10 | 30 |
| Étapes de Trotter | 10 | 20 |
| Étapes comprimées AQC (1 couche + 2 couches) | 3 + 2 = 5 | 6 + 4 = 10 |
| Couches d'ansatz de l'état fondamental | 3 | 5 |
| Dimension de liaison MPS maximale | 32 | 128 |
| Backend | statevector | QPU avec DD, twirling de Pauli et TREX |
Étape 1 : mapper les entrées classiques sur un problème quantique
Construis le même SparsePauliOp de Heisenberg KCuF et prépare l'état fondamental, maintenant avec un ansatz plus profond gs_layers=5 pour la chaîne plus longue, puis intègre le coup de neutron de au site central. Ceci est identique au mapping à petite échelle, mais à .
Attends-toi à une fidélité d'état fondamental plus faible que pour l'exécution à 10 sites : environ 0,82 ici contre 0,98 pour la chaîne plus petite, car cinq couches HVA ne peuvent pas capturer entièrement un état fondamental à 30 sites. C'est attendu plutôt qu'un échec, et le tutoriel original accepte environ 0,65 à 50 sites pour la même raison. Augmenter gs_layers ou le plafond d'itération COBYQA améliore cela, au prix d'un coût classique supplémentaire.
n = 30
dt = 0.6
time_steps = 20
center = n // 2 - 1

# Same MPS settings as the original large-scale run: a larger bond for the
# longer, more-entangled chain (shared by GS prep and AQC compression).
mps_max_bond = 128
mps_cutoff = 1e-8

# Same KCuF3 Hamiltonian and ground-state prep, on a larger chain
H = SparsePauliOp.from_sparse_list(
    [(p, [i, i + 1], 0.25) for i in range(n - 1) for p in ("XX", "YY", "ZZ")],
    num_qubits=n,
)
gs_circuit = prepare_ground_state(
    n, gs_layers=5, max_bond=mps_max_bond, cutoff=mps_cutoff
)
gs_circuit.rz(np.pi / 2, center)  # neutron kick at the center site
print(
    f"Prepared {n}-qubit ground state with the neutron kick at site {center}."
)
DMRG ground-state energy: -13.111355
GS fidelity: 0.8201
Prepared 30-qubit ground state with the neutron kick at site 14.
Étapes 2 et 3 : compresser et exécuter avec le modèle de fonction
Le même appel unique que l'exemple du simulateur, maintenant avec backend_name pointant vers un processeur IBM Quantum, de sorte que la fonction transpile et exécute là-bas. Le plan de compression fait varier la profondeur de l'ansatz : les six premières étapes de Trotter (à faible intrication) se compriment en un ansatz peu profond à une couche, les quatre suivantes en un ansatz plus profond à deux couches, et les 10 étapes restantes des 20 s'exécutent comme du Trotter ordinaire. aqc_options augmente la dimension de liaison MPS à max_bond=128 pour la chaîne plus longue et plus intriquée (correspondant à l'original), en conservant le même optimiseur L-BFGS-B plafonné à 100 itérations. estimator_options active l'atténuation d'erreur intégrée : découplage dynamique (XY4), torsion de porte et atténuation de mesure TREX. Les valeurs par défaut de la fonction correspondent déjà au tutoriel original pour tous ces éléments, sauf le budget d'apprentissage TREX (measure_noise_learning). Le bloc entier est quand même écrit intégralement car un estimator_options fourni par l'appelant remplace entièrement les valeurs par défaut de la fonction au lieu de les fusionner, donc omettre une clé reviendrait à la valeur par défaut d'IBM Quantum Compute plutôt qu'à celle de la fonction.
# Steps 2 + 3: the function compresses (varied ansatz) and executes on hardware.
job = fn.run(
    t_steps=time_steps,
    aqc_segments=[
        {
            "n_steps": 6,
            "ansatz_steps": 1,
        },  # early steps -> shallow 1-layer ansatz
        {
            "n_steps": 4,
            "ansatz_steps": 2,
        },  # later steps -> deeper 2-layer ansatz
    ],
    aqc_options={
        "max_bond": mps_max_bond,  # 128 for the longer chain
        "cutoff": mps_cutoff,
        "optimizer_settings": {
            "method": "L-BFGS-B",
            "jac": True,
            "options": {"maxiter": 100},
        },
    },
    dt=dt,
    hamiltonian=H,
    initial_state=gs_circuit,
    backend_name="ibm_pittsburgh",
    # Mitigation settings from the original tutorial. Only the two
    # measure_noise_learning values differ from the function's defaults; the rest
    # restates them, because a caller-supplied estimator_options dict replaces the
    # function's defaults wholesale rather than merging into them.
    estimator_options={
        "environment": {"job_tags": ["TUT-SNS"]},
        "dynamical_decoupling": {"enable": True, "sequence_type": "XY4"},
        "twirling": {
            "enable_gates": True,
            "num_randomizations": 1000,
            "shots_per_randomization": 128,
        },
        "resilience": {
            "measure_mitigation": True,
            "measure_noise_learning": {
                "num_randomizations": 32,
                "shots_per_randomization": 100,
            },
        },
    },
)
print("job ID (save this to reconnect later):", job.job_id)
job ID (save this to reconnect later): 43ed8d07-6d7d-4f33-b70a-7f31b765b310
L'exécution à grande échelle n'est pas rapide, et la majeure partie du temps est classique plutôt que sur le QPU. La compression AQC s'exécute à l'intérieur de la fonction avant que quoi que ce soit n'atteigne le QPU : à 30 sites avec max_bond=128, cela a pris près de quatre heures dans notre exécution, contre environ 18 minutes de temps QPU indiquées dans l'estimation d'utilisation en haut de ce tutoriel. L'attente en file d'attente s'ajoute aux deux. Tu n'as pas besoin de garder ce notebook ou ce kernel ouvert pendant son exécution.
Copie l'ID de job affiché par la cellule précédente et enregistre-le. Les trois cellules suivantes te permettent de reprendre l'exécution plus tard :
-
Se reconnecter, nécessaire uniquement dans une nouvelle session de kernel : réexécute les cellules de Configuration pour recréer
serverless, puis reconstruis le handlejobà partir de l'ID que tu as enregistré. Passe cette cellule si tu es encore dans la session où tu as soumis, car le handle est déjà actif. -
Vérifie le statut : relance jusqu'à ce qu'il indique
DONE. -
Récupère le résultat : exécute uniquement une fois que le statut est
DONE.
La cellule de reconnexion suivante contient un espace réservé. Remplace-le par ton propre job_id :
# Reconnect to a previously submitted job by its ID. Only needed in a NEW kernel
# session; if you are still in the session where you submitted, the `job` handle
# from the preceding cell is already live, so skip this cell. Replace the ID that follows with your own.
job = serverless.get_job_by_id("<your job ID>")
# Check where the job is. Re-run this until it reports DONE before fetching the
# result in the following cell: QUEUED -> INITIALIZING -> RUNNING: OPTIMIZING_FOR_HARDWARE ->
# RUNNING: WAITING_FOR_QPU -> RUNNING: EXECUTING_QPU -> RUNNING: POST_PROCESSING
# -> DONE.
print(job.status())
DONE
# Run this only once the preceding status cell reports DONE. result() blocks until
# the job finishes, so calling it earlier just waits (possibly for hours).
result = job.result()
print(
    "AQC fidelities:",
    {k: round(v, 4) for k, v in result["metadata"]["aqc_fidelities"].items()},
)

ev = np.array(result["expectation_values"])
Gjjc = ev[1:]  # drop the t = 0 row -> shape (time_steps, n)
AQC fidelities: {'1': 1.0, '2': 0.9994, '3': 0.9944, '4': 0.9853, '5': 0.9747, '6': 0.959, '7': 0.9495, '8': 0.9542, '9': 0.9533, '10': 0.9451}
Étape 4 : Post-traiter et retourner le résultat au format classique souhaité
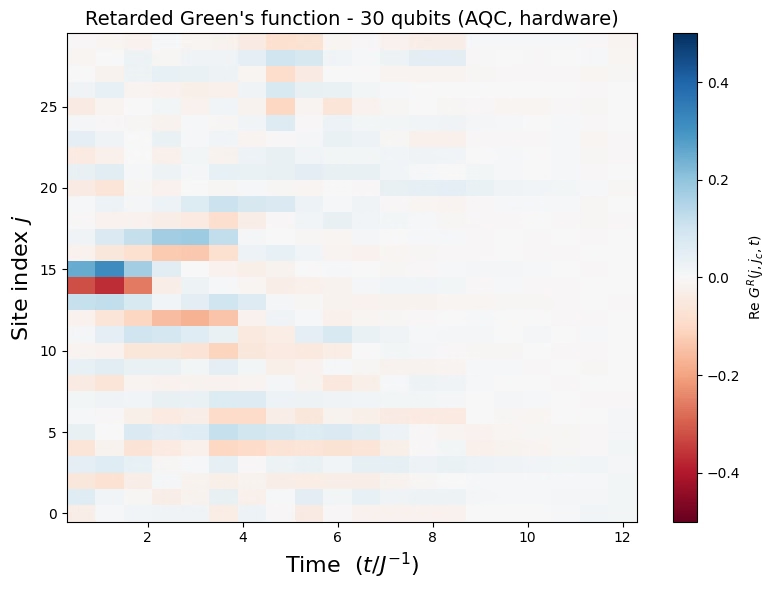
Post-traitement identique à l'exécution sur simulateur : transformation de Fourier de la fonction de Green en , symétrisation en miroir, et troncature des valeurs négatives. Avec la chaîne et l'évolution plus longues, le continuum à deux spinons est bien mieux résolu. Il devrait remplir la bande entre les limites en pointillés, plus lumineuse près de .
n = result["metadata"]["n"]
q_res, w_res = 100, 100
spectrum = get_spectrum(n, Gjjc, dt, time_steps, q_res, w_res)
spectrum = -(spectrum + spectrum[:, ::-1]) / 2  # mirror symmetry
spectrum = np.clip(spectrum, a_min=0, a_max=None)  # clip negatives

plot_green(
    n,
    Gjjc,
    time_steps,
    dt,
    title=f"Retarded Green's function - {n} qubits (AQC, hardware)",
)
plot_spectrum(
    spectrum,
    dt,
    q_res,
    w_res,
    lower_bound=True,
    upper_bound=True,
    title=f"Dynamical structure factor - {n} qubits (AQC, hardware)",
)
Annexe
L'exemple matériel précédent exécute une seule longueur de chaîne. Les trois spectres qui suivent proviennent d'exécutions matérielles antérieures de ce même flux de travail sur ibm_pittsburgh à 10, 20 et 30 sites, toutes les autres entrées étant maintenues fixes : 20 pas de Trotter avec dt = 0.6, le plan de compression de six étapes à une couche plus quatre étapes à deux couches compressées par AQC, et max_bond = 128. Ce sont des résultats enregistrés, et non la sortie des cellules précédentes.
Les mêmes paramètres sont utilisés pour les trois tailles, de sorte que les spectres sont directement comparables. Les ajuster selon la longueur de chaîne, avec par exemple davantage de couches d'ansatz d'état fondamental ou un max_bond plus grand, peut donner de meilleurs résultats que ceux présentés ici.
Étapes suivantes
-
Adapte ce flux de travail à ton propre système : la fonction accepte n'importe quel
SparsePauliOp1D à plus proches voisins, donc un hamiltonien de chaîne, un état initial ou un ensemble d'observables différents suivent le même pipeline PRE → FUNCTION → POST. Consulte le contrat complet d'entrée/sortie dans le modèle AQC Dynamics sur GitHub. -
Lis l'article dont provient ce benchmark : Lee et al., Benchmarking quantum simulation with neutron-scattering experiments (arXiv:2603.15608).
-
Compare avec le tutoriel original « Simulate neutron scattering », le flux de travail en ligne que celui-ci transpose vers un modèle de fonction déployé.
-
Approfondis les techniques d'atténuation et de suppression des erreurs appliquées lors de l'exécution matérielle : découplage dynamique, brouillage de Pauli et TREX.