Détection d'erreurs à faible surcoût avec des codes spatio-temporels
Estimation d'utilisation : 4 minutes sur un processeur Heron (ibm_kingston ou équivalent) (REMARQUE : il s'agit uniquement d'une estimation. Ton temps d'exécution peut varier.)
Résultats d'apprentissage
-
Comment les vérifications de Pauli spatio-temporelles détectent les erreurs logiques dans les circuits de Clifford, et comment la post-sélection sur leurs syndromes améliore la fidélité d'une distribution échantillonnée.
-
Comment utiliser le paquet
qiskit-paulicepour trouver et insérer automatiquement des vérifications efficaces sur le plan matériel avecget_check_qubits,NoiseModeletadd_pauli_checks. -
Comment estimer la fidélité d'un état stabilisateur en échantillonnant ses stabilisateurs et en post-sélectionnant sur les syndromes de vérification.
-
Comment exécuter le flux de travail complet de détection d'erreurs sur du matériel IBM Quantum® et comparer les fidélités bruitées et post-sélectionnées.
Prérequis
-
Fondamentaux du matériel pour l'informatique quantique à l'échelle utile.
-
Le formalisme de Clifford et des stabilisateurs, y compris la façon dont un groupe stabilisateur décrit un état stabilisateur pur.
Contexte
Low-overhead error detection with spacetime codes [1] de Simon Martiel et Ali Javadi-Abhari introduit une méthode pour détecter les erreurs logiques dans les circuits à dominante Clifford qui se situe entre la correction d'erreurs complète et l'atténuation d'erreurs plus légère. L'idée s'appuie sur les vérifications de Pauli cohérentes (CPC) issues de Single-shot error mitigation by coherent Pauli checks [2] de van den Berg et al. Dans les deux approches, un circuit « payload » de Clifford est intriqué avec des qubits ancillaires pour vérifier certains invariants. La mesure des ancilles produit un syndrome qui indique si une erreur a été détectée pendant l'exécution. Ne conserver que les échantillons sans erreur détectée améliore la fidélité de la distribution échantillonnée, au prix d'un taux de post-sélection réduit.
La différence clé entre les vérifications de Pauli cohérentes et les vérifications spatio-temporelles réside dans les opérateurs qu'elles mesurent. Les vérifications de Pauli cohérentes mesurent des opérateurs localisés dans le temps et de poids élevé. Sur des topologies de qubits à connectivité limitée, comme le heavy hex, ces vérifications nécessitent de nombreuses portes SWAP et rendent souvent le circuit trop profond pour être exécuté en pratique. Implémenter les vérifications sous forme de codes spatio-temporels distribue au contraire chaque vérification dans le circuit payload à la fois en espace et en temps. Cela produit un encodage efficace sur le plan matériel qui reste efficace pour détecter les erreurs logiques tout en maintenant un faible surcoût en qubits et en profondeur.
Ce que fait le paquet qiskit-paulice
Le paquet qiskit-paulice automatise la construction de ces vérifications afin que tu n'aies pas à les construire à la main. Son rôle principal est de trouver et d'insérer des vérifications de Pauli spatio-temporelles valides aux emplacements d'un circuit qui maximisent la détection d'erreurs tout en minimisant le surcoût en qubits. Une vérification est valide lorsque ses opérateurs laissent inchangée l'action logique du circuit payload, de faible poids lorsqu'elle utilise peu de portes intriquantes, et efficace lorsqu'elle détecte une grande partie des erreurs, par rapport au bruit que la vérification elle-même introduit. Le paquet évalue les vérifications candidates par rapport à un modèle de bruit et retient les meilleures dans le circuit. Ce tutoriel utilise trois méthodes de l'API :
-
get_check_qubitsinspecte la carte de couplage d'un backend et retourne des paires de qubits cible et ancillaire. Une vérification surtarget_qubits[i]utiliseancilla_qubits[i]. -
NoiseModel.from_backendconstruit un modèle de bruit approximatif à partir des données d'étalonnage du backend. Le modèle évalue les vérifications candidates, donc un modèle de bruit exact et appris n'est pas requis. Pour un modèle de Pauli-Lindblad appris, consulteNoiseModel.from_pauli_lindblad_maps. -
add_pauli_checkstrouve et insère des vérifications dans un circuit. Elle retourne une séquence d'objetsCheckedCircuitavec un nombre croissant de vérifications, et chaque objet fournit uneget_postselection_methodqui associe une chaîne de bits mesurée à un vecteur de syndrome. L'argumentcostsélectionne la fonction qui évalue une vérification (gamma, le surcoût d'échantillonnage du canal de bruit inverse post-sélectionné, ouLER, le taux d'erreur logique). L'argumentmethodsélectionne la stratégie de recherche (windowed,geneticouwindowed_genetic). Ce tutoriel utilisecost="gamma"etmethod="windowed", qui ensemble donnent une sélection de vérifications déterministe et reproductible.
Estimer la fidélité à partir de l'échantillonnage des stabilisateurs
Pour mesurer l'efficacité de la détection d'erreurs, tu peux estimer la fidélité de l'état stabilisateur que le circuit prépare idéalement par rapport à l'état bruité que le matériel produit réellement. Le projecteur sur un état stabilisateur pur est égal à la moyenne uniforme sur les éléments de son groupe stabilisateur :
En substituant ceci dans la fidélité, on obtient la fidélité de comme la valeur d'espérance moyenne de chaque stabilisateur par rapport à :
Pour les problèmes plus grands, énumérer tous les stabilisateurs est infaisable, donc tu peux estimer la fidélité à partir d'un échantillon aléatoire. Tirer stabilisateurs uniformément au hasard dans donne une estimation non biaisée :
Comme un circuit de Clifford prépare un état stabilisateur, tu peux estimer sa fidélité directement à partir des valeurs d'espérance échantillonnées de ses stabilisateurs. Ce tutoriel parcourt d'abord le flux de travail sur un simulateur avec un petit circuit, puis exécute le même flux de travail sur du matériel avec un circuit plus grand et plus profond. À mesure que les circuits incluent davantage d'opérations non-Clifford, le nombre de vérifications valides diminue rapidement, donc la méthode fonctionne mieux pour les circuits à dominante Clifford.
Prérequis
Avant de commencer ce tutoriel, assure-toi d'avoir installé les éléments suivants :
-
SDK Qiskit v2.0 ou ultérieur, avec le support de visualisation
-
Qiskit Runtime v0.40 ou ultérieur (
pip install qiskit-ibm-runtime) -
Qiskit Aer v0.17 ou ultérieur (
pip install qiskit-aer) -
Qiskit Paulice (
pip install qiskit-paulice) -
tqdm (
pip install tqdm)
Configuration
Importe les bibliothèques requises et définis les fonctions d'aide qui ne sont pas disponibles en tant qu'imports. La fonction random_clifford_circuit construit un payload de Clifford aléatoire en brickwork, find_check_layout recherche dans la carte de couplage d'un backend un chemin de qubits à faible erreur avec de nombreuses ancilles disponibles, learned_noise_model transforme la sortie de NoiseLearner en un modèle de bruit qiskit-paulice, append_basis_rotation fait pivoter un circuit afin qu'un stabilisateur soit mesuré dans la base computationnelle, expectation calcule une valeur d'espérance de stabilisateur à partir de comptages échantillonnés, et cum_mean_sem suit l'estimation de fidélité courante.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime qiskit-paulice tqdm
# Standard library imports
import random
import time

# External libraries
import matplotlib.pyplot as plt
import numpy as np
from tqdm import tqdm

# Qiskit
from qiskit import QuantumCircuit
from qiskit.quantum_info import Clifford, Pauli, PauliLindbladMap, PauliList
from qiskit.result import sampled_expectation_value
from qiskit.transpiler import generate_preset_pass_manager
from qiskit.visualization import plot_coupling_map

# Qiskit Aer
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel as AerNoiseModel
from qiskit_aer.noise import ReadoutError, depolarizing_error

# Qiskit IBM Runtime
from qiskit_ibm_runtime import NoiseLearner, QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler

# Qiskit Paulice
from qiskit_paulice import add_pauli_checks
from qiskit_paulice.layout import get_check_qubits
from qiskit_paulice.noise_models import NoiseModel
def random_clifford_circuit(
    num_qubits: int, depth: int, rng: np.random.Generator
) -> QuantumCircuit:
    """Brickwork random Clifford on `num_qubits`, with `depth` CZ layers."""
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for d in range(depth):
        for i in range(d % 2, num_qubits - 1, 2):
            qc.cz(i, i + 1)
        for q in range(num_qubits):
            if rng.integers(0, 2):
                qc.sx(q)
            if rng.integers(0, 2):
                qc.s(q)
            if rng.integers(0, 2):
                qc.sx(q)
    return qc

def find_check_layout(
    backend,
    num_qubits: int,
    rng: np.random.Generator,
    num_trials: int = 200,
    max_gate_error: float = 0.03,
    max_readout_error: float = 0.2,
) -> list[int]:
    """Find a low-error path of `num_qubits` qubits with many available ancillas.

    Builds random self-avoiding walks on the coupling map, excluding the qubits
    and two-qubit gates whose reported errors exceed the thresholds, and keeps
    the path that offers the most target and ancilla pairs. Ties are broken by
    the lower average two-qubit gate error along the path.
    """
    target = backend.target
    gate_2q = next(
        name for name in ("cz", "ecr", "cx") if name in target.operation_names
    )

    # Collect per-edge gate errors and per-qubit readout errors
    edge_error = {}
    for qubits, props in target[gate_2q].items():
        edge = tuple(sorted(qubits))
        if props is not None and props.error is not None:
            edge_error[edge] = min(edge_error.get(edge, 1.0), props.error)
    readout_error = {
        qubit: target["measure"][(qubit,)].error
        for (qubit,) in target["measure"]
    }

    # Keep only the edges whose gate and readout errors are acceptable
    adjacency = {}
    for (q1, q2), error in edge_error.items():
        if (
            error <= max_gate_error
            and readout_error.get(q1, 1.0) <= max_readout_error
            and readout_error.get(q2, 1.0) <= max_readout_error
        ):
            adjacency.setdefault(q1, set()).add(q2)
            adjacency.setdefault(q2, set()).add(q1)

    # Random self-avoiding walks; keep the path with the most check pairs
    starts = sorted(adjacency)
    best_path = None
    best_score = (-1, float("inf"))
    for _ in range(num_trials):
        path = [starts[rng.integers(len(starts))]]
        while len(path) < num_qubits:
            options = sorted(adjacency[path[-1]] - set(path))
            if not options:
                break
            path.append(options[rng.integers(len(options))])
        if len(path) < num_qubits:
            continue
        num_pairs = len(get_check_qubits(backend.coupling_map, path)[0])
        mean_error = float(
            np.mean(
                [edge_error[tuple(sorted(e))] for e in zip(path, path[1:])]
            )
        )
        if num_pairs > best_score[0] or (
            num_pairs == best_score[0] and mean_error < best_score[1]
        ):
            best_path, best_score = path, (num_pairs, mean_error)

    if best_path is None:
        raise RuntimeError(
            "No connected low-error path found. Relax the error thresholds."
        )
    return best_path

def learned_noise_model(layer_errors, layout: list[int]) -> NoiseModel:
    """Build a `NoiseModel` from `NoiseLearner` results.

    `NoiseLearner` reports one `PauliLindbladError` per entangling layer, whose
    generators are indexed against that layer's own physical qubits, while
    `NoiseModel.from_pauli_lindblad_maps` expects `PauliLindbladMap`s indexed the
    way `NoiseModel.from_backend` indexes them: by position in `layout`. This
    translates between the two and drops generators that fall outside `layout`.
    """
    phys_to_virt = {phys: virt for virt, phys in enumerate(layout)}
    maps = []
    for layer in layer_errors:
        if layer.error is None:
            continue
        terms = []
        for pauli, rate in zip(
            layer.error.generators, layer.error.rates, strict=True
        ):
            label, indices = [], []
            for local, phys in enumerate(layer.qubits):
                x, z = bool(pauli.x[local]), bool(pauli.z[local])
                if not (x or z):
                    continue
                if phys not in phys_to_virt:
                    break  # generator reaches outside the layout, so skip it
                label.append("Y" if x and z else "X" if x else "Z")
                indices.append(phys_to_virt[phys])
            else:
                if label:
                    terms.append(
                        ("".join(label), tuple(indices), float(rate))
                    )
        # Each map needs a 2-qubit generator to define an entangling layer
        if any(len(t[1]) == 2 for t in terms):
            maps.append(
                PauliLindbladMap.from_sparse_list(
                    terms, num_qubits=len(layout)
                )
            )
    if not maps:
        raise RuntimeError(
            "No usable layer errors. Check that the learner ran on this layout."
        )
    return NoiseModel.from_pauli_lindblad_maps(maps)

def append_basis_rotation(
    circuit: QuantumCircuit, pauli: Pauli
) -> QuantumCircuit:
    """Strip measurements, append basis rotations for `pauli`, and re-measure."""
    out = circuit.remove_final_measurements(inplace=False)
    for q in range(pauli.num_qubits):
        if pauli.x[q]:
            if pauli.z[q]:
                out.sdg(q)
            out.h(q)
    out.measure_all()
    return out

def expectation(counts: dict, pauli: Pauli) -> float:
    """Expectation value of `pauli` from counts measured in the Z basis.

    Pads with identity on any qubits beyond the support of `pauli`, such as the
    check ancillas that appear in the postselected counts.
    """
    if not counts:
        return float("nan")
    n = pauli.num_qubits
    sign = -1 if int(pauli.phase) % 4 == 2 else 1
    total = len(next(iter(counts)))
    label = "".join(
        "Z" if q < n and (pauli.x[q] or pauli.z[q]) else "I"
        for q in range(total - 1, -1, -1)
    )
    return sign * sampled_expectation_value(counts, label)

def cum_mean_sem(values: np.ndarray):
    """Cumulative mean and standard error of the mean, ignoring NaNs."""
    valid = ~np.isnan(values)
    total = np.cumsum(np.where(valid, values, 0.0))
    total_sq = np.cumsum(np.where(valid, values**2, 0.0))
    count = np.maximum(np.cumsum(valid).astype(float), 1)
    mean = total / count
    sem = np.sqrt(np.maximum(total_sq / count - mean**2, 0) / count)
    return np.where(np.cumsum(valid) > 0, mean, np.nan), sem
Exemple de simulateur à petite échelle
Cette section parcourt le flux de travail complet sur un simulateur bruité. Elle utilise des données de référence du backend pour choisir une disposition de qubits et un modèle de bruit, trouve automatiquement des vérifications, et utilise la postsélection sur la distribution échantillonnée pour montrer l'amélioration de la fidélité.
Étape 1 : associer les entrées classiques à un problème quantique
Le circuit de charge utile est un circuit de Clifford brickwork aléatoire à une dimension et peu profond. Comme le circuit est un circuit de Clifford, il prépare un état stabilisateur dont la fidélité peut être estimée directement à partir des valeurs d'espérance des stabilisateurs échantillonnées. Commence par un circuit peu profond afin que les vérifications soient faciles à visualiser à l'étape suivante.
num_qubits = 12
depth = 4
seed = 1764
rng = np.random.default_rng(seed)
np.random.seed(seed)

circuit = random_clifford_circuit(num_qubits, depth, rng)
circuit.measure_all()
circuit.draw("mpl", fold=-1, scale=0.6)

Étape 2 : optimiser pour l'exécution sur matériel quantique
L'association du circuit au matériel définit la disposition physique des qubits, le modèle de bruit qui évalue les vérifications candidates, et les vérifications elles-mêmes.
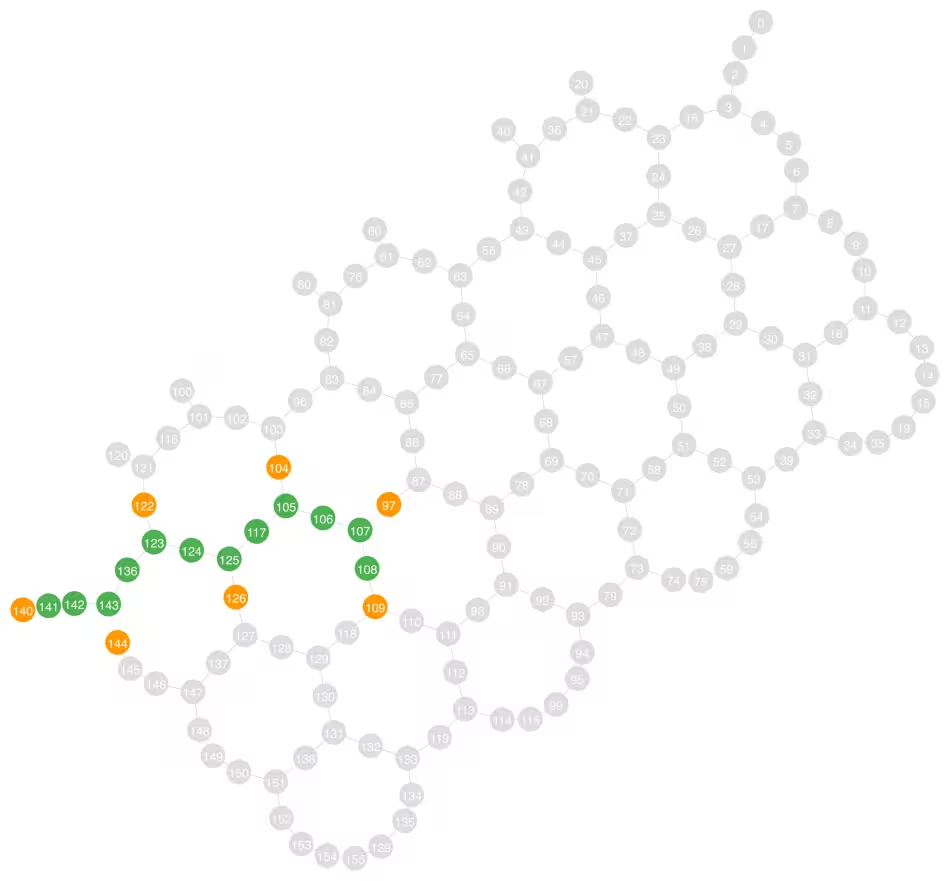
Sélectionne d'abord un backend et recherche dans sa carte de couplage une disposition de qubits à une dimension à l'aide de l'assistant find_check_layout défini dans la section Configuration. Cet assistant construit des marches aléatoires auto-évitantes qui évitent les portes et les lectures présentant le plus d'erreurs, et conserve le chemin qui offre le plus de paires cible-ancilla. Comme la recherche lit la connectivité et les données d'erreur directement à partir du backend, le même code fonctionne sur n'importe quel QPU IBM Quantum. La fonction get_check_qubits renvoie ensuite les paires cible et ancilla, où une vérification sur target_qubits[i] utilise ancilla_qubits[i].
Dans le graphe de couplage qui suit, les qubits verts sont les qubits de charge utile et les qubits orange sont les ancillas qui implémentent les vérifications. Les qubits ayant une ancilla adjacente sont utilisés comme qubits cibles pour les vérifications.
service = QiskitRuntimeService()
backend = service.least_busy(operational=True, simulator=False)

print(f"Backend: {backend.name}")

# Search for a low-error path, then pair each target qubit with a neighboring ancilla
layout = find_check_layout(backend, num_qubits, rng)
target_qubits, ancilla_qubits = get_check_qubits(backend, layout)
num_checks = len(target_qubits)

print(f"Target qubits:  {target_qubits}")
print(f"Ancilla qubits: {ancilla_qubits}")
plot_coupling_map(
    num_qubits=backend.num_qubits,
    qubit_coordinates=getattr(
        backend.configuration(), "qubit_coordinates", None
    ),
    coupling_map=backend.configuration().coupling_map,
    figsize=(12, 12),
    qubit_color=[
        "#4CAF50"
        if i in set(layout)
        else "#FF9800"
        if i in set(ancilla_qubits)
        else "#DDDDDD"
        for i in backend.coupling_map.graph.node_indices()
    ],
    qubit_size=220,
    line_width=2,
    font_size=90,
)
Backend: ibm_boston
Target qubits:  [105, 107, 108, 123, 125, 141, 143]
Ancilla qubits: [104, 97, 109, 122, 126, 140, 144]
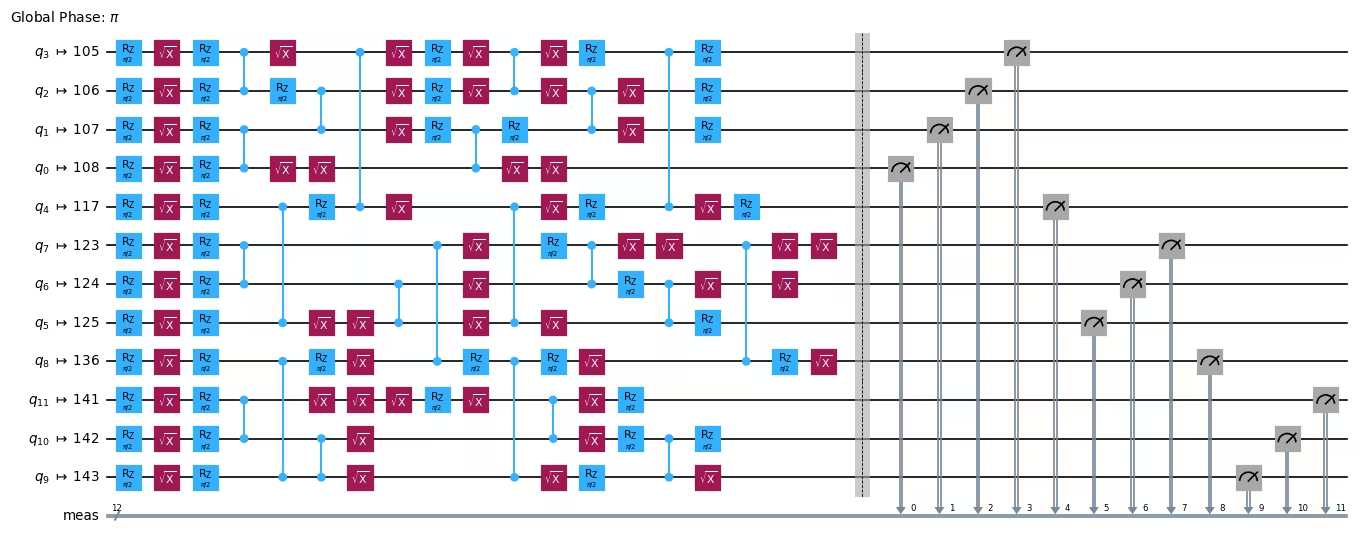
Une fois le backend et la disposition choisis, transpile la charge utile en un circuit d'architecture de jeu d'instructions (ISA). Il suffit de définir la disposition et de traduire les portes dans le jeu de portes natif du backend.
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=layout
)
circuit_isa = pm.run(circuit)
circuit_isa.draw("mpl", fold=-1, scale=0.6)
Ensuite, modélise la façon dont le bruit des portes et de la lecture sur le backend affecte l'exécution. Le modèle de bruit détermine à quel endroit du circuit une vérification capture le plus d'erreurs. Un modèle plus précis améliore la détection, mais il n'est généralement pas nécessaire d'en apprendre un en échantillonnant le QPU. Le modèle qui suit déduit un canal de dépolarisation uniforme pour le bruit des portes et de la lecture à partir des données de référence de qiskit-ibm-runtime.
noise_model = NoiseModel.from_backend(
    backend, layout, uniform_gate_noise=True
)
print(noise_model)
NoiseModel(gate_noise=0.001079865281450939, readout_noise=0.006001790364583333, idling_noise=None)
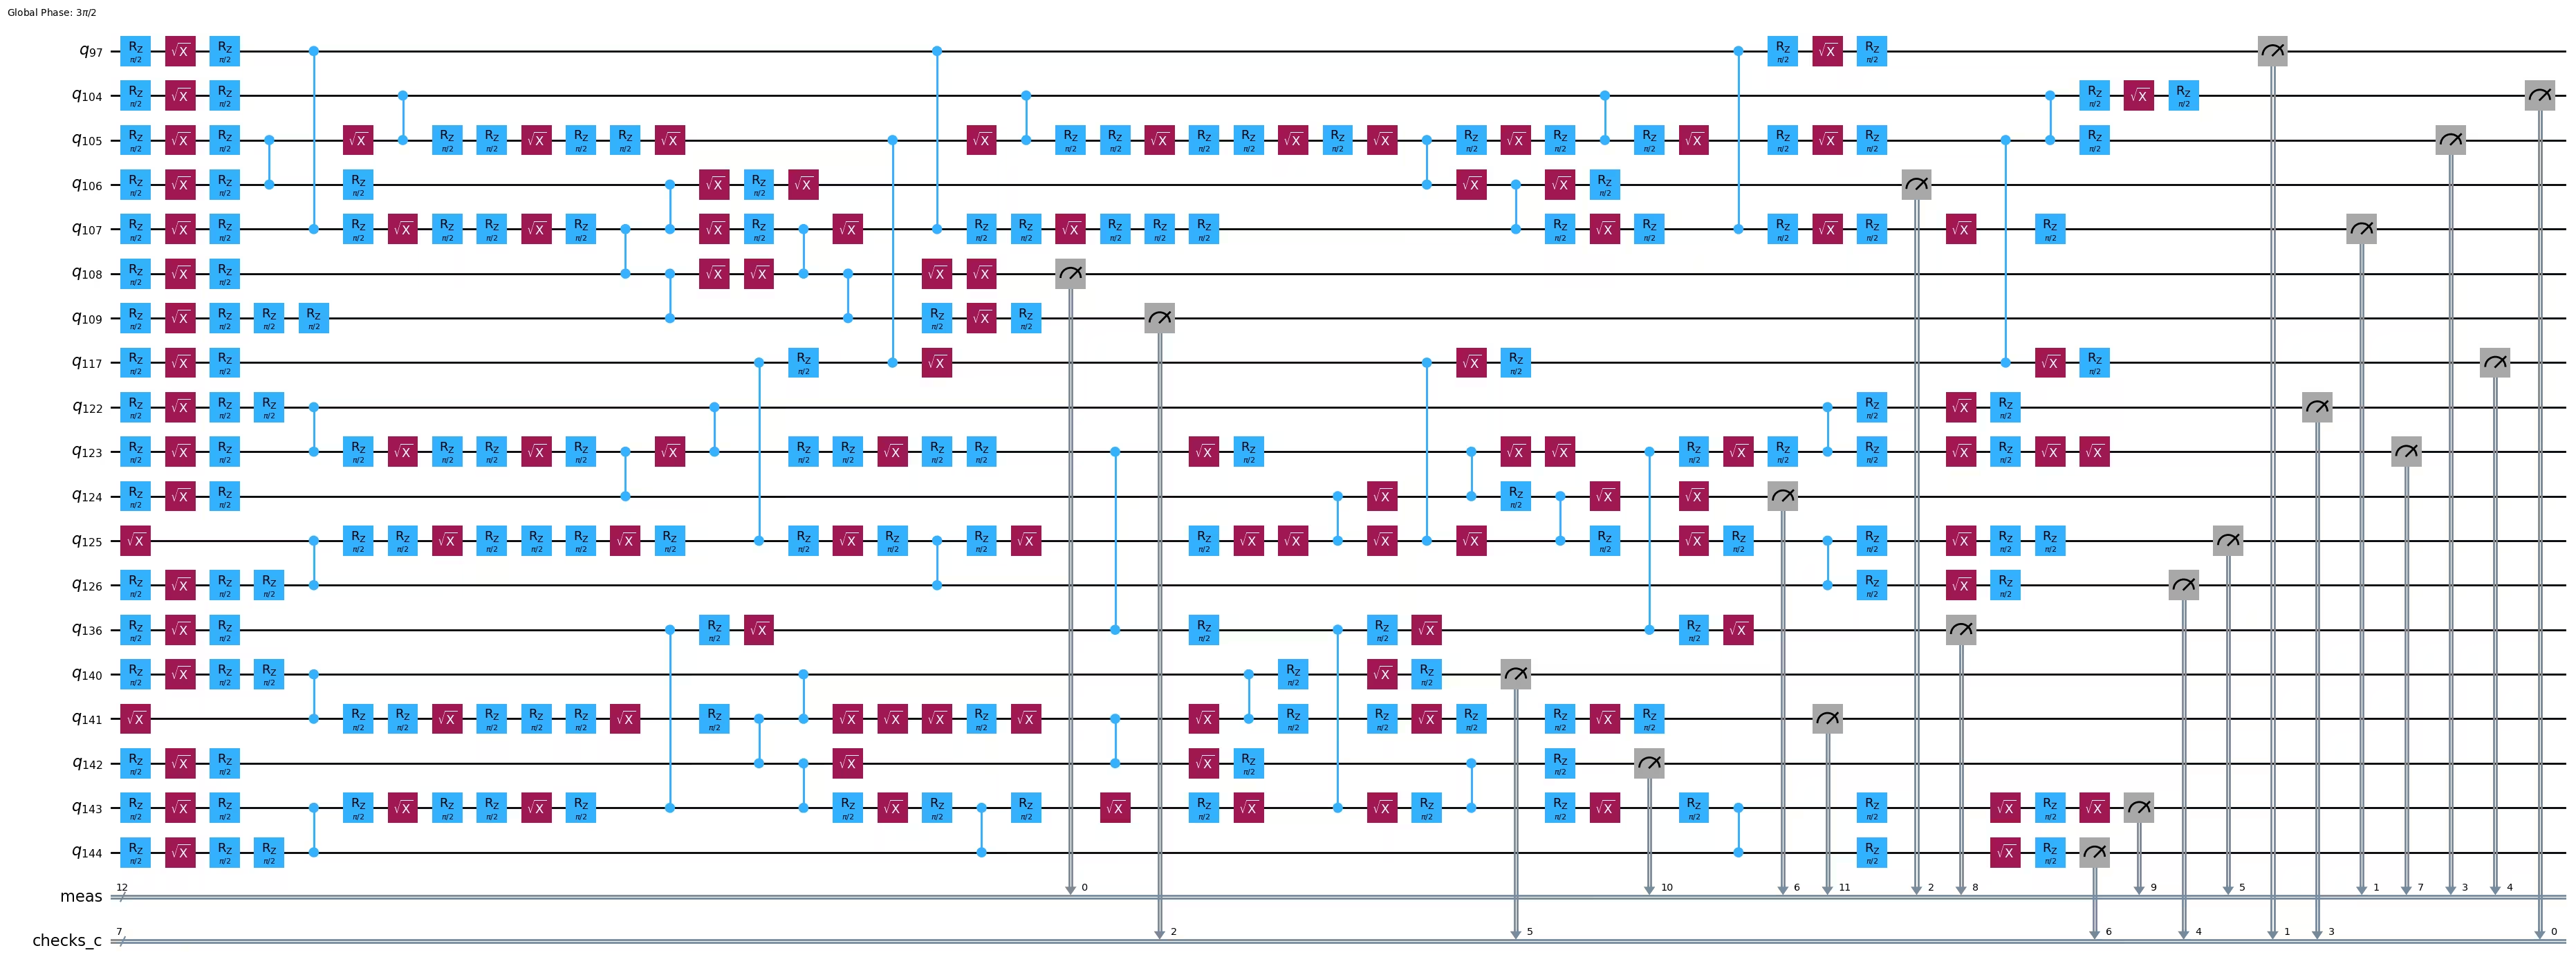
Ajoute maintenant des vérifications au circuit. La fonction add_pauli_checks prend la charge utile de Clifford, la liste des qubits cibles et le modèle de bruit. L'argument ancilla_qubits indique à la fonction quelle ancilla physique associer à chaque cible. Les vérifications sont ajoutées dans l'ordre où les qubits cibles apparaissent, de sorte que la disposition finale du circuit vérifié est layout + ancilla_qubits. Pour exécuter un circuit de sortie avec moins de vérifications (i), la disposition finale est layout + ancilla_qubits[:i].
La sortie de add_pauli_checks est une séquence de circuits avec un nombre croissant de vérifications, allant d'aucune vérification jusqu'à une vérification sur chaque qubit cible. La visualisation confirme que les vérifications utilisent les paires cible et ancilla spécifiées. Pour plus de détails sur la recherche de bonnes vérifications, consulte les sections II à IV des informations complémentaires de la référence [1].
checked = add_pauli_checks(
    circuit_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
)

print(f"Physical layout of payload and ancillas: {layout + ancilla_qubits}")
print("Checked circuit:")
checked[-1].circuit.draw("mpl", fold=-1, idle_wires=False)
Physical layout of payload and ancillas: [108, 107, 106, 105, 117, 125, 124, 123, 136, 143, 142, 141, 104, 97, 109, 122, 126, 140, 144]
Checked circuit:
Étape 3 : exécuter à l'aide des primitives Qiskit
Pour rendre l'effet du bruit des portes visible, augmente la profondeur de la charge utile et échantillonne un sous-ensemble de ses stabilisateurs. Chaque stabilisateur n'est généralement pas commutant qubit par qubit avec les autres, donc un seul ensemble de vérifications n'est pas valide pour deux stabilisateurs différents. Plutôt que de regrouper les stabilisateurs en ensembles commutants, trouve un bon ensemble de vérifications pour chaque stabilisateur indépendamment. Échantillonner les stabilisateurs de manière uniformément aléatoire donne une estimation de fidélité non biaisée.
Construis le circuit plus profond et tire un échantillon aléatoire de ses stabilisateurs.
depth = 24
num_stabilizers = 20
num_shots = 1_000

circuit = random_clifford_circuit(num_qubits, depth, rng)

# Build the full stabilizer group, then sample from it uniformly at random
circ_no_meas = circuit.remove_final_measurements(inplace=False)
stabilizer_group = PauliList([Pauli("I" * num_qubits)])
for generator in (
    Pauli(label) for label in Clifford(circ_no_meas).to_labels(mode="S")
):
    stabilizer_group = stabilizer_group + stabilizer_group.compose(generator)

keep = np.where(
    stabilizer_group.x.any(axis=1) | stabilizer_group.z.any(axis=1)
)[0]
chosen = np.random.default_rng(seed).choice(
    keep, size=min(num_stabilizers, len(keep)), replace=False
)
stabilizers = [stabilizer_group[int(i)] for i in chosen]

two_qubit_depth = circuit.depth(lambda x: x.operation.num_qubits == 2)
print(
    f"Sampled {len(stabilizers)} stabilizers of a {circuit.num_qubits}-qubit "
    f"circuit with two-qubit depth {two_qubit_depth}: "
    f"{{{stabilizers[0]}, {stabilizers[1]}, ...}}"
)
Sampled 20 stabilizers of a 12-qubit circuit with two-qubit depth 24: {ZXIIXZYYXIZZ, XXXYIIZYXIII, ...}
Pour chaque stabilisateur échantillonné, fais pivoter le circuit de sorte que le stabilisateur soit mesuré dans la base computationnelle, transpile-le sur le backend, et trouve un bon ensemble de vérifications. Les paires cible et ancilla sont mélangées ensemble pour chaque stabilisateur afin que chaque cible conserve son ancilla. N'oublie pas que les vérifications sont validées séquentiellement dans l'ordre où les qubits cibles sont donnés, et qu'une vérification validée n'est pas modifiée à mesure que d'autres vérifications sont ajoutées.
noisy_circuits = []
checked_circuits = []
depths_2q = []
t0 = time.time()
for i, pauli in enumerate(tqdm(stabilizers)):
    noisy_circuits.append(pm.run(append_basis_rotation(circuit, pauli)))
    # Shuffle target and ancilla pairs together so each target keeps its ancilla
    targets, ancillas = zip(
        *random.sample(
            list(zip(target_qubits, ancilla_qubits, strict=True)),
            k=len(target_qubits),
        ),
        strict=True,
    )
    checked_circuits.append(
        add_pauli_checks(
            noisy_circuits[-1],
            list(targets),
            noise_model,
            ancilla_qubits=list(ancillas),
            cost="gamma",
            method="windowed",
            seed=seed + 1 + i,
        )
    )
    depths_2q.append(
        checked_circuits[-1][-1].circuit.depth(lambda x: len(x.qubits) == 2)
    )

print(
    f"Added {num_checks} checks to {len(stabilizers)} circuits "
    f"in {(time.time() - t0):.0f}s."
)
print(
    f"On average, two-qubit depth increased from "
    f"{circuit.depth(lambda x: len(x.qubits) == 2)} to {int(np.mean(depths_2q))} "
    f"when adding {num_checks} checks."
)
100%|██████████| 20/20 [00:15<00:00, 1.29it/s]
Added 7 checks to 20 circuits in 15s.
On average, two-qubit depth increased from 24 to 33 when adding 7 checks.
Échantillonne la charge utile brute et les circuits vérifiés avec Qiskit Aer. Le simulateur utilise le même modèle de dépolarisation qui a évalué les vérifications, de sorte que le bruit ciblé par les vérifications est le bruit appliqué par le simulateur.
aer_nm = AerNoiseModel()
aer_nm.add_all_qubit_quantum_error(
    depolarizing_error(noise_model.gate_noise, 2), ["cz"]
)
p = noise_model.readout_noise
aer_nm.add_all_qubit_readout_error(ReadoutError([[1 - p, p], [p, 1 - p]]))
noisy_sim = AerSimulator(method="stabilizer", noise_model=aer_nm)

counts = []
for i, checked_circ_result in enumerate(tqdm(checked_circuits)):
    noisy_counts = (
        noisy_sim.run(
            noisy_circuits[i], shots=num_shots, seed_simulator=seed * i + 1
        )
        .result()
        .get_counts()
    )
    checked_counts_per_variant = []
    for k, ck in enumerate(checked_circ_result):
        variant_counts = (
            noisy_sim.run(
                ck.circuit, shots=num_shots, seed_simulator=seed * i + 2 + k
            )
            .result()
            .get_counts()
        )
        checked_counts_per_variant.append(variant_counts)
    counts.append((noisy_counts, checked_counts_per_variant))
100%|██████████| 20/20 [00:17<00:00, 1.13it/s]
Étape 4 : post-traiter et renvoyer le résultat dans le format classique souhaité
Chaque vérification utilise des portes intriquées entre une ancilla et une cible. L'ancilla démarre dans l'état , donc stabilise son entrée. Propager à travers le circuit vérifié donne un opérateur de Pauli sur la sortie dont les termes non identité définissent le support de la vérification. Une vérification réussit lorsque les bits de son support ont une parité paire. Un échantillon n'est conservé que lorsque chaque vérification réussit.
La méthode get_postselection_method de chaque CheckedCircuit renvoie une fonction qui associe une chaîne de bits mesurée à un vecteur de syndrome. Conserve les échantillons dont le syndrome est nul pour chaque vérification, et écarte les autres. Le graphique qui suit montre que l'ajout de vérifications supplémentaires abaisse le taux de postsélection. Un taux de postsélection plus faible nécessite davantage de tirs pour atteindre une précision cible, il y a donc un compromis entre la capacité de détection et le coût d'échantillonnage. Le taux semble converger, ce qui indique que les vérifications supplémentaires apportent moins de capacité de détection.
rate_per_variant = []
kept_per_stab = []
for i, (_, checked_counts_per_variant) in enumerate(counts):
    rates = []
    kept_at_num_checks = None
    for k, variant_counts in enumerate(checked_counts_per_variant):
        ps_fn = checked_circuits[i][k].get_postselection_method()
        kept = {
            bs: n for bs, n in variant_counts.items() if not ps_fn(bs).any()
        }
        rates.append(sum(kept.values()) / num_shots)
        if k == num_checks:
            kept_at_num_checks = kept
    rate_per_variant.append(rates)
    kept_per_stab.append(kept_at_num_checks)

max_len = max(len(s) for s in rate_per_variant)
rates_arr = np.full((len(rate_per_variant), max_len), np.nan)
for i, s in enumerate(rate_per_variant):
    rates_arr[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, rates_arr.T, color="#ff8c00", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(rates_arr, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Postselection rate")
ax.set_ylim((0, 1.05))
ax.set_title(
    f"Per-stabilizer postselection rate ({len(rates_arr)} stabilizers)"
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

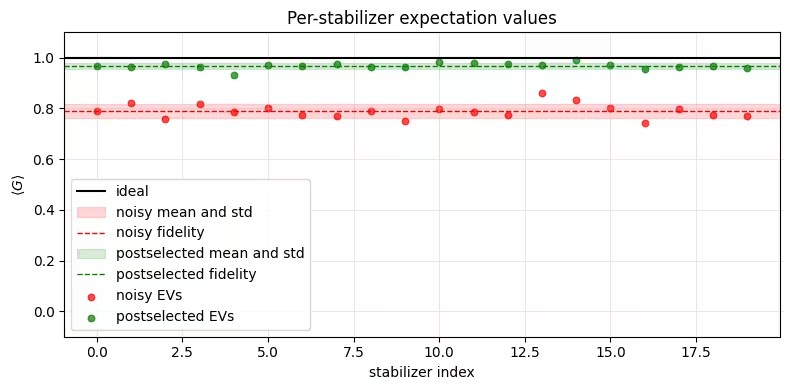
Compare maintenant la fidélité de l'état bruité brut avec l'état postsélectionné. Postsélectionner uniquement les échantillons sans erreur détectée augmente la valeur d'espérance de chaque stabilisateur, et donc la fidélité estimée. Les valeurs postsélectionnées utilisent moins d'échantillons que les valeurs brutes, pourtant les valeurs d'espérance sont plus précises et la variance échantillonnée est plus faible. Remarque également que le taux moyen de postsélection est proche de la fidélité bruitée. C'est ce à quoi on s'attend lorsque les vérifications détectent presque toutes les échantillons erronés : la fraction d'échantillons qui réussissent chaque vérification se rapproche de la fraction d'échantillons sans erreur, qui est la fidélité de l'état bruité.
results = []
for i, ((noisy_counts, _), kept) in enumerate(
    zip(counts, kept_per_stab, strict=True)
):
    results.append(
        (
            expectation(noisy_counts, stabilizers[i]),
            expectation(kept, stabilizers[i]),
            sum(kept.values()) / num_shots,
        )
    )

fidelity_noisy = float(np.nanmean([r[0] for r in results]))
fidelity_postsel = float(np.nanmean([r[1] for r in results]))
psr = float(np.mean([r[2] for r in results]))
print(
    f"ideal fidelity:          1.0\n"
    f"noisy fidelity:          {fidelity_noisy:.4f}\n"
    f"postselected fidelity:   {fidelity_postsel:.4f}\n"
    f"mean postselection rate: {psr:.3f}"
)

evs_ideal = np.ones(len(results))
evs_noisy = np.array([r[0] for r in results])
evs_post = np.array([r[1] for r in results])
idx = np.arange(len(results))

def strip(ax, ys, color, label):
    m, s = np.nanmean(ys), np.nanstd(ys)
    ax.axhspan(
        m - s, m + s, color=color, alpha=0.15, label=f"{label} mean and std"
    )
    ax.axhline(
        m, color=color, linewidth=1, linestyle="--", label=f"{label} fidelity"
    )

fig, ax = plt.subplots(figsize=(8, 4))
ax.axhline(np.nanmean(evs_ideal), color="black", linewidth=1.5, label="ideal")
strip(ax, evs_noisy, "red", "noisy")
strip(ax, evs_post, "green", "postselected")
ax.scatter(idx, evs_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    evs_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_title("Per-stabilizer expectation values")
ax.legend(loc="lower left")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

M = np.arange(1, len(results) + 1)
fig, ax = plt.subplots(figsize=(8, 4))
for ys, color, label in [
    (evs_ideal, "black", "ideal"),
    (evs_noisy, "red", "noisy"),
    (evs_post, "green", "postselected"),
]:
    cm, sem = cum_mean_sem(ys)
    ax.plot(M, cm, color=color, linewidth=1.5, label=label)
    ax.fill_between(M, cm - sem, cm + sem, color=color, alpha=0.15)
ax.set_xlabel("number of stabilizers averaged")
ax.set_ylabel("running fidelity estimate")
ax.set_title("Fidelity convergence versus number of stabilizers")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ideal fidelity:          1.0
noisy fidelity:          0.7899
postselected fidelity:   0.9679
mean postselection rate: 0.780

Le score gamma indique quelle part du canal de bruit modélisé reste non détectée par les vérifications. Tracer le score gamma en fonction du nombre de vérifications validées montre comment la capacité de détection s'améliore à mesure que chaque vérification est ajoutée. Une valeur de 1.0 signifie que les vérifications capturent tout le bruit modélisé. Les courbes se rapprochent de 1.0 à mesure que davantage de vérifications sont validées, ce qui montre que chaque vérification supplémentaire capture une partie de l'erreur non détectée restante.
stab_scores = [
    [variant.cost for variant in checked_circ_result]
    for checked_circ_result in checked_circuits
]
max_len = max(len(s) for s in stab_scores)
scores = np.full((len(stab_scores), max_len), np.nan)
for i, s in enumerate(stab_scores):
    scores[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, scores.T, color="#4682b4", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(scores, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Gamma")
ax.set_yscale("log")
ax.set_title(f"Per-stabilizer gamma curves ({len(scores)} stabilizers)")
ax.legend()
ax.grid(True, alpha=0.3, which="both")
plt.tight_layout()
plt.show()

Exemple à grande échelle sur matériel
Le même flux de travail s'exécute sur du matériel avec une charge utile plus grande et plus profonde. Cette section réutilise le backend de l'exemple du simulateur mais construit une nouvelle disposition à 20 qubits avec ses propres paires cible et ancilla et son propre pass manager, puis soumet les circuits au QPU en une seule tâche. À cette échelle, la plupart des tirs déclenchent au moins une vérification, donc le taux de postsélection est faible, et chaque circuit a besoin d'un budget de tirs important pour disposer de suffisamment d'échantillons survivants. L'exemple concentre donc son budget sur quelques stabilisateurs échantillonnés ; il s'agit toujours d'une estimation de fidélité non biaisée, mais plus grossière que la moyenne sur de nombreux stabilisateurs de l'exemple du simulateur.
Une chose change par rapport à l'exemple du simulateur : au lieu de déduire un canal de dépolarisation uniforme à partir de données de calibration, cette section apprend le modèle de bruit avec NoiseLearner et construit le modèle qiskit-paulice à partir du résultat avec NoiseModel.from_pauli_lindblad_maps. Un modèle de Pauli-Lindblad appris capture la structure spatiale du bruit sur cette disposition spécifique, plutôt que de supposer que chaque arête est également bruitée, de sorte que le placement des vérifications est évalué par rapport à un bruit plus proche de celui qui affecte le QPU. Apprendre le bruit nécessite d'échantillonner le QPU et devrait être pris en compte dans tout budget global d'échantillonnage du QPU.
Les paramètres qui suivent définissent le nombre de qubits, la profondeur, le nombre de stabilisateurs et le nombre de tirs. Fais évoluer hw_num_shots avec l'inverse du taux de postsélection : à un taux de 3 %, 40 000 tirs laissent environ 1 200 échantillons postsélectionnés par circuit. Augmente hw_num_stabilizers pour une estimation de fidélité plus précise, au prix de davantage de circuits par tâche, chacun ayant besoin du même budget de tirs.
Étapes 1 à 4 (compressées en un seul bloc de code)
La cellule suivante exécute les mêmes quatre étapes que l'exemple du simulateur. Elle construit la charge utile plus grande et échantillonne quelques stabilisateurs (étape 1) ; choisit une disposition, apprend le modèle de bruit sur celle-ci, et trouve le circuit entièrement vérifié pour chaque stabilisateur (étape 2) ; soumet une tâche Sampler qui contient à la fois les circuits bruts et vérifiés (étape 3) ; et postsélectionne les comptages vérifiés pour comparer les estimations de fidélité bruitée et postsélectionnée, par stabilisateur et en moyenne (étape 4). À cette échelle, énumérer tout le groupe de stabilisateurs comme dans l'exemple du simulateur est infaisable, donc la cellule sous-échantillonne un sous-ensemble aléatoire de stabilisateurs pour calculer une estimation de la fidélité.
Remarque que l'étape 2 fait ici plus de choses que dans l'exemple du simulateur : apprendre le modèle de bruit soumet sa propre tâche NoiseLearner avant la tâche Sampler, donc la cellule exécute deux tâches au total. Elles portent les balises TUT_ASPC_LEARN et TUT_ASPC afin que tu puisses les retrouver plus tard. Consulte Organiser et rechercher par balises de tâche pour en savoir plus sur le balisage des tâches.
# -------------------------Step 1: build a larger payload and sample stabilizers-------------------------
hw_num_qubits = 20
hw_depth = 36
hw_num_stabilizers = 10
hw_num_shots = 40_000

hw_circuit = random_clifford_circuit(hw_num_qubits, hw_depth, rng)
hw_no_meas = hw_circuit.remove_final_measurements(inplace=False)

# Enumerating all 2^n stabilizers is infeasible at this size, so draw each
# stabilizer by composing a random subset of the group generators
hw_generators = [
    Pauli(label) for label in Clifford(hw_no_meas).to_labels(mode="S")
]
sample_rng = np.random.default_rng(seed)
hw_stabilizers = []
while len(hw_stabilizers) < hw_num_stabilizers:
    mask = sample_rng.integers(0, 2, hw_num_qubits).astype(bool)
    if not mask.any():
        continue  # skip the identity
    stabilizer = Pauli("I" * hw_num_qubits)
    for generator, chosen in zip(hw_generators, mask, strict=True):
        if chosen:
            stabilizer = stabilizer.compose(generator)
    hw_stabilizers.append(stabilizer)

# -------------------------Step 2: find a 20-qubit layout, learn its noise, and add checks-------------------------
# A single bad coupler or bad-readout qubit on the path drags every
# stabilizer down, so search harder and with tighter error thresholds
hw_layout = find_check_layout(
    backend,
    hw_num_qubits,
    rng,
    num_trials=500,
    max_gate_error=0.015,
    max_readout_error=0.05,
)
hw_target_qubits, hw_ancilla_qubits = get_check_qubits(backend, hw_layout)
hw_pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=hw_layout
)
print(f"Layout with {len(hw_target_qubits)} check pairs: {hw_layout}")

# ----- learn a Pauli-Lindblad noise model on this layout -----
# The simulator example scored checks against a uniform depolarizing channel
# inferred from calibration data. Here, learn the noise instead: NoiseLearner
# runs its own job on the QPU and returns a Pauli-Lindblad channel per unique
# entangling layer, so the checks are placed against the noise this layout
# actually has, including its spatial structure. All the sampled stabilizers
# share the same entangling layers and differ only in their final basis
# rotation, so learning on the bare payload covers all of them.
learner = NoiseLearner(
    mode=backend,
    options={
        "max_layers_to_learn": 4,
        "num_randomizations": 32,
        "shots_per_randomization": 128,
        "environment": {"job_tags": ["TUT_ASPC_LEARN"]},
    },
)
learner_job = learner.run([hw_pm.run(hw_circuit)])
print(f"Submitted noise-learner job {learner_job.job_id()}")
hw_layer_errors = learner_job.result().data

# To see how much the learned model helps, swap the next line for the
# simulator example's uniform model - a one-line change:
# hw_noise_model = NoiseModel.from_backend(backend, hw_layout, uniform_gate_noise=True)
hw_noise_model = learned_noise_model(hw_layer_errors, hw_layout)
# NoiseLearner characterizes gate noise only, so keep the readout estimate
# from calibration data rather than leaving it unset
hw_noise_model.readout_noise = NoiseModel.from_backend(
    backend, hw_layout, uniform_gate_noise=True
).readout_noise
print(
    f"Learned {len(hw_layer_errors)} layers; "
    f"readout noise {hw_noise_model.readout_noise:.5f}"
)

# ----- add the fully checked circuit per stabilizer -----
hw_noisy_circuits = []
hw_checked_circuits = []
for i, pauli in enumerate(tqdm(hw_stabilizers)):
    bare = hw_pm.run(append_basis_rotation(hw_circuit, pauli))
    hw_noisy_circuits.append(bare)
    variants = add_pauli_checks(
        bare,
        hw_target_qubits,
        hw_noise_model,
        ancilla_qubits=hw_ancilla_qubits,
        cost="gamma",
        method="windowed",
        seed=seed + 1 + i,
    )
    hw_checked_circuits.append(variants[-1])  # keep the fully checked circuit

# -------------------------Step 3: submit one Sampler job with the bare and checked circuits-------------------------
sampler = Sampler(mode=backend)
sampler.options.default_shots = hw_num_shots
sampler.options.environment.job_tags = ["TUT_ASPC"]

pubs = hw_noisy_circuits + [cc.circuit for cc in hw_checked_circuits]
job = sampler.run(pubs)
print(f"Submitted job {job.job_id()} with {len(pubs)} circuits")

# -------------------------Step 4: postselect and compare fidelity-------------------------
result = job.result()
n_stab = len(hw_stabilizers)

hw_results = []
for i in range(n_stab):
    noisy_counts = result[i].join_data().get_counts()
    checked_counts = result[n_stab + i].join_data().get_counts()
    ps_fn = hw_checked_circuits[i].get_postselection_method()
    kept = {bs: c for bs, c in checked_counts.items() if not ps_fn(bs).any()}
    hw_results.append(
        (
            expectation(noisy_counts, hw_stabilizers[i]),
            expectation(kept, hw_stabilizers[i]),
            sum(kept.values()) / sum(checked_counts.values()),
        )
    )

hw_fidelity_noisy = float(np.nanmean([r[0] for r in hw_results]))
hw_fidelity_postsel = float(np.nanmean([r[1] for r in hw_results]))
hw_psr = float(np.mean([r[2] for r in hw_results]))
print(
    f"noisy fidelity estimate:        {hw_fidelity_noisy:.4f}\n"
    f"postselected fidelity estimate: {hw_fidelity_postsel:.4f}\n"
    f"mean postselection rate:        {hw_psr:.4f} "
    f"(~{int(round(hw_psr * hw_num_shots))} kept shots per circuit)"
)

# Per-stabilizer breakdown. The postselection rate varies from stabilizer to
# stabilizer, so a stabilizer whose postselected value barely moves is usually
# one whose checks rejected little; the kept-shot count says how much of the
# gap is statistics rather than signal.
print("\nper-stabilizer results:")
print(
    f"{'idx':>3}  {'noisy':>8}  {'postsel':>8}  {'psr':>7}  {'kept shots':>10}"
)
for i, (noisy, post, psr_i) in enumerate(hw_results):
    print(
        f"{i:>3}  {noisy:>8.4f}  {post:>8.4f}  {psr_i:>7.4f}  "
        f"{int(round(psr_i * hw_num_shots)):>10}"
    )

hw_noisy = np.array([r[0] for r in hw_results])
hw_post = np.array([r[1] for r in hw_results])
idx = np.arange(n_stab)

fig, ax = plt.subplots(figsize=(9, 4))
ax.axhline(1.0, color="black", linewidth=1.5, label="ideal")
strip(ax, hw_noisy, "red", "noisy")
strip(ax, hw_post, "green", "postselected")
ax.scatter(idx, hw_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    hw_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_xticks(idx)
ax.set_title("Per-stabilizer expectation values on hardware")
# Outside the axes so it cannot hide a data point
ax.legend(loc="center left", bbox_to_anchor=(1.02, 0.5), frameon=False)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
Layout with 11 check pairs: [153, 152, 151, 138, 131, 130, 129, 118, 109, 110, 111, 98, 91, 90, 89, 78, 69, 70, 71, 58]
Submitted noise-learner job d9f4mncjeosc73fjfmkg
Learned 4 layers; readout noise 0.00470
100%|██████████| 10/10 [01:01<00:00, 6.18s/it]
Submitted job d9f4s04jeosc73fjftkg with 20 circuits
noisy fidelity estimate:        0.3685
postselected fidelity estimate: 0.6869
mean postselection rate:        0.2851 (~11404 kept shots per circuit)

per-stabilizer results:
idx     noisy   postsel      psr  kept shots
  0    0.3769    0.6918   0.3247       12987
  1    0.3745    0.6760   0.2999       11995
  2    0.3659    0.6389   0.3549       14196
  3    0.3821    0.7060   0.2660       10641
  4    0.3653    0.7475   0.2531       10124
  5    0.3752    0.7022   0.2698       10791
  6    0.3508    0.7144   0.2711       10842
  7    0.3485    0.7087   0.2381        9523
  8    0.3825    0.6289   0.2928       11711
  9    0.3630    0.6549   0.2808       11232

Pour des circuits de cette taille, la plupart des échantillons contiennent au moins une erreur détectée, donc le taux de postsélection est faible et la postsélection écarte la plupart des tirs. Les échantillons qui réussissent chaque vérification donnent une valeur d'espérance bien meilleure que le circuit brut, et les valeurs par stabilisateur se séparent nettement de la référence bruitée. Pour affiner l'estimation de fidélité, échantillonne davantage de stabilisateurs avec le même budget de tirs par circuit. Pour augmenter le taux de postsélection, réduis la profondeur du circuit ou valide moins de vérifications ; pour passer à des charges utiles plus grandes, fais évoluer le budget de tirs avec l'inverse du taux de postsélection.
Étapes suivantes
Si tu as trouvé ce travail intéressant, les ressources suivantes pourraient t'intéresser :
-
Le tutoriel sur les codes de répétition pour une introduction à la correction d'erreurs quantiques.
-
La documentation de
qiskit-paulicepour l'API complète de recherche de vérifications, et le dépôt GitHub du package pour le code source. -
L'article Low-overhead error detection with spacetime codes pour la théorie derrière les vérifications.
Références
-
[1] Martiel, S., & Javadi-Abhari, A. (2025). Low-overhead error detection with spacetime codes. arXiv preprint arXiv:2504.15725.
-
[2] van den Berg, E., Bravyi, S., Gambetta, J. M., Jurcevic, P., Maslov, D., & Temme, K. (2023). Single-shot error mitigation by coherent Pauli checks. Physical Review Research, 5(3), 033193.