Optimization Solver : une fonction Qiskit de Q-CTRL Fire Opal
Consulte la référence API
Les Qiskit Functions sont une fonctionnalité expérimentale réservée aux utilisateurs des plans IBM Quantum® Premium, Flex et On-Prem (via l'API IBM Quantum Platform). Elles sont en version préliminaire et susceptibles d'évoluer.
Package versions
Le code de cette page a été développé avec les prérequis suivants. Nous recommandons d'utiliser ces versions ou des versions plus récentes.
qiskit-ibm-runtime~=0.47.0
sympy~=1.14.0
Vue d'ensemble
Avec le Fire Opal Optimization Solver, tu peux résoudre des problèmes d'optimisation à l'échelle utilitaire sur du matériel quantique, sans avoir besoin d'expertise en informatique quantique. Il suffit de fournir la définition du problème de haut niveau — le Solver s'occupe du reste. L'ensemble du flux de travail tient compte du bruit et exploite la gestion des performances Fire Opal en arrière-plan. Le Solver fournit de manière constante des solutions précises à des problèmes difficiles à résoudre classiquement, même à l'échelle complète d'un appareil sur les plus grands QPU IBM®.
Le Solver est flexible et peut être utilisé pour résoudre des problèmes d'optimisation combinatoire définis comme des fonctions objectif ou des graphes arbitraires. Les problèmes n'ont pas à être mappés à la topologie de l'appareil. Les problèmes non contraints et contraints sont résolubles, avec des contraintes pouvant être appliquées comme des contraintes hard Hamming-weight-1 plutôt que des termes de pénalité. Les exemples de ce guide montrent comment résoudre un problème d'optimisation non contraint et un problème contraint à l'échelle utilitaire en utilisant différents types d'entrées du Solver. Le premier exemple porte sur un problème max-cut défini sur un graphe 3-régulier à 156 nœuds, tandis que le second aborde un problème de partitionnement de graphe à 50 nœuds défini par une fonction de coût.
Pour accéder à l'Optimization Solver, contacte Q-CTRL.
Description de la fonction
Le Solver optimise et automatise entièrement l'algorithme, depuis la suppression des erreurs au niveau matériel jusqu'au mappage efficace du problème et à l'optimisation classique en boucle fermée. En coulisses, le pipeline du Solver réduit les erreurs à chaque étape, permettant d'atteindre les performances nécessaires pour monter en charge de façon significative. Le flux de travail sous-jacent s'inspire de l'algorithme QAOA (Quantum Approximate Optimization Algorithm), un algorithme hybride quantique-classique. Pour un résumé détaillé du flux de travail complet de l'Optimization Solver, consulte le manuscrit publié.
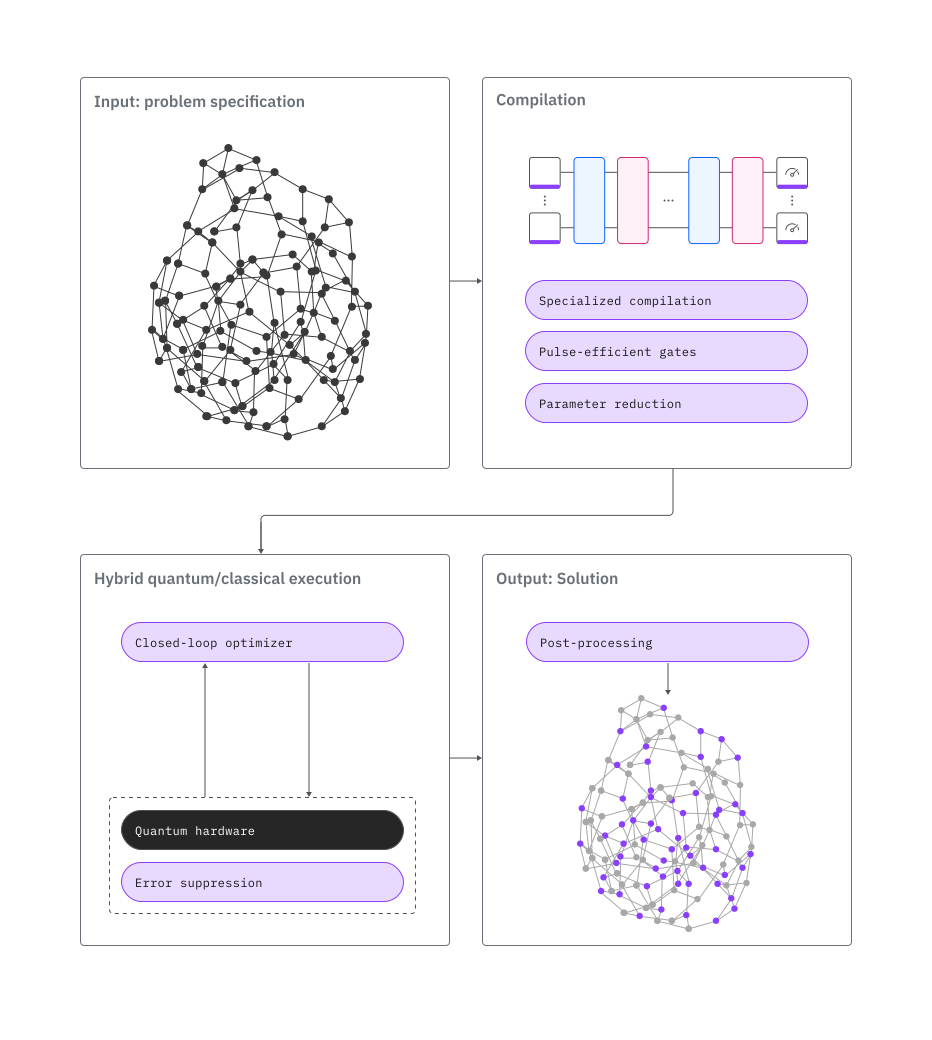
Pour résoudre un problème générique avec l'Optimization Solver :
- Définis ton problème sous forme de fonction objectif, de graphe ou de chaîne de spin
SparsePauliOp. - Connecte-toi à la fonction via le Qiskit Functions Catalog.
- Lance le problème avec le Solver et récupère les résultats.
Formats de problèmes acceptés
-
Représentation polynomiale d'une fonction objectif. Idéalement créée en Python à partir d'un objet SymPy Poly existant et mise en chaîne avec sympy.srepr.
-
Représentation par graphe d'un type de problème spécifique. Le graphe doit être créé avec la bibliothèque networkx en Python. Il doit ensuite être converti en chaîne via la fonction networkx
nx.readwrite.json_graph.adjacency_data. -
Représentation en chaîne de spin d'un problème spécifique. La chaîne de spin doit être représentée sous la forme d'un objet
SparsePauliOp; consulte la documentation pour plus de détails.
Si tu souhaites utiliser un backend que cette fonction ne prend pas actuellement en charge, contacte Q-CTRL pour en demander la prise en charge.
Benchmarks
La performance peut dépendre à la fois de l'instance du problème et des étapes de traitement ultérieures. Dans certains cas, les échantillons classiques et les échantillons générés par ordinateur quantique peuvent atteindre une qualité de solution finale similaire après un post-traitement équivalent. L'évaluation devrait donc prendre en compte l'ensemble du flux de travail d'optimisation.
Les résultats de benchmarking publiés montrent que le Solver résout avec succès des problèmes dépassant 120 qubits, surpassant même des résultats précédemment publiés sur des recuits quantiques et des appareils à ions piégés. Les métriques de benchmark suivantes donnent une indication approximative de la précision et de la mise à l'échelle des types de problèmes, sur la base de quelques exemples. Les métriques réelles peuvent varier selon les caractéristiques du problème, comme le nombre de termes dans la fonction objectif (densité) et leur localité, le nombre de variables et l'ordre polynomial.
Le « Nombre de qubits » indiqué n'est pas une limite absolue, mais représente des seuils approximatifs où tu peux t'attendre à une précision de solution extrêmement constante. Des tailles de problèmes plus importantes ont été résolues avec succès, et les tests au-delà de ces limites sont encouragés.
La connectivité arbitraire entre qubits est prise en charge pour tous les types de problèmes.
| Type de problème | Nombre de qubits | Exemple | Précision | Temps total (s) | Utilisation du runtime (s) | Nombre d'itérations |
|---|---|---|---|---|---|---|
| Problèmes quadratiques faiblement connectés | 156 | Max-Cut 3-régulier | 100 % | 1764 | 293 | 16 |
| Optimisation binaire d'ordre supérieur | 156 | Modèle de verre de spin d'Ising | 100 % | 1461 | 272 | 16 |
| Problèmes quadratiques densément connectés | 50 | Max-Cut entièrement connecté | 100 % | 1758 | 268 | 12 |
| Problème contraint avec contraintes hard | 50 | Partitionnement de graphe pondéré avec 8 % de densité d'arêtes | 100 % | 1074 | 215 | 10 |
Premiers pas
Commence par t'authentifier avec ta clé API IBM Quantum. Sélectionne ensuite la fonction Qiskit comme suit. (Cet extrait suppose que tu as déjà enregistré ton compte dans ton environnement local.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"networkx": "networkx", "numpy": "numpy", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "sympy": "sympy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
solver = catalog.load("q-ctrl/optimization-solver")
Exemple : optimisation non contrainte
Lance le problème de coupe maximale (Max-Cut). L'exemple suivant illustre les capacités du Solver sur un problème Max-Cut avec un graphe non pondéré 3-régulier à 156 nœuds, mais tu peux aussi résoudre des problèmes de graphes pondérés.
En plus de qiskit-ibm-catalog, tu utiliseras également les packages suivants pour cet exemple : networkx et numpy. Tu peux les installer en décommentant la cellule suivante si tu exécutes cet exemple dans un notebook avec le noyau IPython.
# %pip install networkx numpy
1. Définir le problème
Tu peux lancer un problème Max-Cut en définissant un problème de graphe et en spécifiant problem_type='maxcut'.
import networkx as nx
import numpy as np

# Generate a random graph with 156 nodes
maxcut_graph = nx.random_regular_graph(d=3, n=156, seed=8)
# Optionally, visualize the graph
nx.draw_networkx(
    maxcut_graph, nx.kamada_kawai_layout(maxcut_graph), node_size=100
)
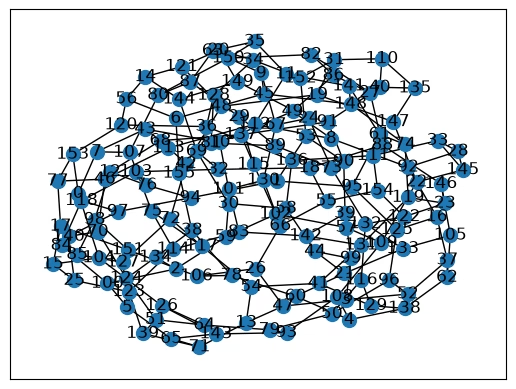
Le Solver accepte une chaîne de caractères comme entrée pour la définition du problème.
# Convert graph to string
problem_as_str = nx.readwrite.json_graph.adjacency_data(maxcut_graph)
2. Lancer le problème
Lorsque tu utilises la méthode d'entrée par graphe, spécifie le type de problème.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy(n_qubits=156).name
# Solve the problem
maxcut_job = solver.run(
    problem=problem_as_str,
    problem_type="maxcut",
    backend_name=backend_name,  # E.g. "ibm_fez"
)
Vérifie le statut de ta charge de travail de fonction Qiskit ou récupère les résultats comme suit :
# Print the ID so you can use it later, if necessary
print(maxcut_job.job_id)

# Get job status
print(maxcut_job.status())
34b53970-d95a-4e24-8763-fc6f3d112843
QUEUED
3. Récupérer le résultat
Récupère la valeur de coupe optimale depuis le dictionnaire de résultats.
La correspondance des variables vers la chaîne de bits peut avoir changé. Le dictionnaire de sortie contient un sous-dictionnaire variables_to_bitstring_index_map qui permet de vérifier l'ordre.
# Poll for results
maxcut_result = maxcut_job.result()

# Take the absolute value of the solution since the cost function is minimized
qctrl_maxcut = abs(maxcut_result["solution_bitstring_cost"])

# Print the optimal cut value found by the Optimization Solver
print(f"Optimal cut value: {qctrl_maxcut}")
Optimal cut value: 210.0
Tu peux vérifier la précision du résultat en résolvant le problème classiquement avec des solveurs open-source comme PuLP si le graphe n'est pas densément connecté. Les problèmes à haute densité peuvent nécessiter des solveurs classiques avancés pour valider la solution.
Exemple : optimisation contrainte
L'exemple précédent de max-cut est un problème classique d'optimisation binaire quadratique non contrainte. Le Solveur d'optimisation de Q-CTRL peut également résoudre des problèmes d'optimisation contraints en transmettant des contraintes strictes directement au Solveur via l'entrée constraint, au lieu de les encoder sous forme de termes de pénalité dans la fonction objectif. Le Solveur prend actuellement en charge les contraintes de poids de Hamming égal à 1 : chaque contrainte spécifie un groupe de variables dont exactement une doit être égale à 1 et les autres à 0.
L'exemple suivant montre comment construire une fonction de coût et un ensemble de contraintes strictes pour un problème d'optimisation contraint, le partitionnement de graphe, en attribuant chaque nœud d'un graphe à exactement l'un de plusieurs groupes tout en minimisant le poids total des arêtes dont les extrémités se retrouvent dans le même groupe.
En plus des packages qiskit-ibm-catalog et qiskit, tu utiliseras également les packages suivants : numpy, networkx et sympy. Tu peux les installer en décommentant la cellule suivante si tu exécutes cet exemple dans un notebook avec le noyau IPython.
# %pip install numpy networkx sympy
1. Définir le problème
Définis un problème aléatoire de partitionnement de graphe en générant un graphe avec des nœuds pondérés aléatoirement.
import networkx as nx
from sympy import Symbol, Poly, srepr

# To change the weights, change the seed to any integer.
rng_seed = 18
_rng = np.random.default_rng(rng_seed)
node_count = 50
edge_probability = 0.08
graph = nx.erdos_renyi_graph(
    node_count, edge_probability, seed=rng_seed, directed=False
)

# add node weights
min_weight = -1.0
max_weight = 1.0
for i in graph.nodes:
    weight = (max_weight - min_weight) * _rng.random() + min_weight
    graph.add_node(i, weight=weight)

# Optionally, visualize the graph
nx.draw_networkx(graph, nx.kamada_kawai_layout(graph), node_size=200)
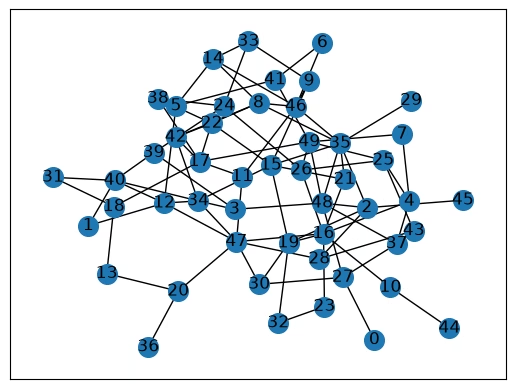
Un modèle d'optimisation standard pour le partitionnement de graphe pondéré peut être formulé comme suit. Divise les nœuds du graphe en trois groupes , et pose si le nœud est affecté au groupe , et sinon. L'objectif est de minimiser le poids total des arêtes dont les extrémités sont affectées au même groupe, où le poids d'une arête est le poids combiné de ses deux extrémités, :
# Construct the cost function.
group_count = 3
variables = [
    Symbol(f"n[{i},{g}]")
    for i in range(node_count)
    for g in range(group_count)
]
node_group_var = {
    (i, g): variables[i * group_count + g]
    for i in range(node_count)
    for g in range(group_count)
}
cost_function = Poly(0, *variables)

for i, j in graph.edges():
    edge_weight = graph.nodes[i]["weight"] + graph.nodes[j]["weight"]
    for g in range(group_count):
        cost_function += (
            edge_weight * node_group_var[(i, g)] * node_group_var[(j, g)]
        )
Chaque nœud doit être affecté à exactement l'un des trois groupes. C'est une contrainte de poids de Hamming égal à 1 : pour chaque nœud , exactement l'un de doit être égal à 1, et les autres doivent être égaux à 0 :
Plutôt que d'encoder cette exigence sous forme de terme de pénalité dans la fonction de coût, transmets-la directement au Solveur comme contrainte stricte via l'entrée constraint.
# Build the hard constraint: exactly one group per node.
constraint_dict = {
    str(tuple(f"n[{i},{g}]" for g in range(group_count))): 1
    for i in range(node_count)
}
print(f"Problem constraints: {constraint_dict}")
Problem constraints: {"('n[0,0]', 'n[0,1]', 'n[0,2]')": 1, "('n[1,0]', 'n[1,1]', 'n[1,2]')": 1, "('n[2,0]', 'n[2,1]', 'n[2,2]')": 1, "('n[3,0]', 'n[3,1]', 'n[3,2]')": 1, "('n[4,0]', 'n[4,1]', 'n[4,2]')": 1, "('n[5,0]', 'n[5,1]', 'n[5,2]')": 1, "('n[6,0]', 'n[6,1]', 'n[6,2]')": 1, "('n[7,0]', 'n[7,1]', 'n[7,2]')": 1, "('n[8,0]', 'n[8,1]', 'n[8,2]')": 1, "('n[9,0]', 'n[9,1]', 'n[9,2]')": 1, "('n[10,0]', 'n[10,1]', 'n[10,2]')": 1, "('n[11,0]', 'n[11,1]', 'n[11,2]')": 1, "('n[12,0]', 'n[12,1]', 'n[12,2]')": 1, "('n[13,0]', 'n[13,1]', 'n[13,2]')": 1, "('n[14,0]', 'n[14,1]', 'n[14,2]')": 1, "('n[15,0]', 'n[15,1]', 'n[15,2]')": 1, "('n[16,0]', 'n[16,1]', 'n[16,2]')": 1, "('n[17,0]', 'n[17,1]', 'n[17,2]')": 1, "('n[18,0]', 'n[18,1]', 'n[18,2]')": 1, "('n[19,0]', 'n[19,1]', 'n[19,2]')": 1, "('n[20,0]', 'n[20,1]', 'n[20,2]')": 1, "('n[21,0]', 'n[21,1]', 'n[21,2]')": 1, "('n[22,0]', 'n[22,1]', 'n[22,2]')": 1, "('n[23,0]', 'n[23,1]', 'n[23,2]')": 1, "('n[24,0]', 'n[24,1]', 'n[24,2]')": 1, "('n[25,0]', 'n[25,1]', 'n[25,2]')": 1, "('n[26,0]', 'n[26,1]', 'n[26,2]')": 1, "('n[27,0]', 'n[27,1]', 'n[27,2]')": 1, "('n[28,0]', 'n[28,1]', 'n[28,2]')": 1, "('n[29,0]', 'n[29,1]', 'n[29,2]')": 1, "('n[30,0]', 'n[30,1]', 'n[30,2]')": 1, "('n[31,0]', 'n[31,1]', 'n[31,2]')": 1, "('n[32,0]', 'n[32,1]', 'n[32,2]')": 1, "('n[33,0]', 'n[33,1]', 'n[33,2]')": 1, "('n[34,0]', 'n[34,1]', 'n[34,2]')": 1, "('n[35,0]', 'n[35,1]', 'n[35,2]')": 1, "('n[36,0]', 'n[36,1]', 'n[36,2]')": 1, "('n[37,0]', 'n[37,1]', 'n[37,2]')": 1, "('n[38,0]', 'n[38,1]', 'n[38,2]')": 1, "('n[39,0]', 'n[39,1]', 'n[39,2]')": 1, "('n[40,0]', 'n[40,1]', 'n[40,2]')": 1, "('n[41,0]', 'n[41,1]', 'n[41,2]')": 1, "('n[42,0]', 'n[42,1]', 'n[42,2]')": 1, "('n[43,0]', 'n[43,1]', 'n[43,2]')": 1, "('n[44,0]', 'n[44,1]', 'n[44,2]')": 1, "('n[45,0]', 'n[45,1]', 'n[45,2]')": 1, "('n[46,0]', 'n[46,1]', 'n[46,2]')": 1, "('n[47,0]', 'n[47,1]', 'n[47,2]')": 1, "('n[48,0]', 'n[48,1]', 'n[48,2]')": 1, "('n[49,0]', 'n[49,1]', 'n[49,2]')": 1}
Tu n'as pas besoin d'ajouter toutes les variables à constraint. Toute variable laissée en dehors du dictionnaire reste non contrainte, tu peux donc mélanger des groupes de variables fortement contraintes avec des variables libres dans le même problème.
2. Lancer le problème
# Solve the problem
partition_job = solver.run(
    problem=srepr(cost_function),
    constraint=constraint_dict,
    backend_name="ibm_marrakesh",  # E.g. "ibm_marrakesh"
)
Vérifie le statut de ta charge de travail de fonction Qiskit ou récupère les résultats comme suit :
# Print the ID so you can use it later, if necessary
print(partition_job.job_id)

# Get job status
print(partition_job.status())
b8085944-f313-444e-be39-ea61b1b47ebd
QUEUED
3. Obtenir le résultat
Récupère la solution et analyse les résultats. Le coût de la solution représente le poids total des arêtes dont les extrémités se sont retrouvées dans le même groupe, donc un coût plus faible indique un meilleur partitionnement du graphe.
partition_result = partition_job.result()
qctrl_cost = partition_result["solution_bitstring_cost"]
solution_bitstring = partition_result["solution_bitstring"]

# Print results
print(f"Total weight of same-group edges: {qctrl_cost}")
print(f"Solution bitstring: {solution_bitstring}")
Total weight of same-group edges: -36.5539
Solution bitstring: 100100100100100001100100100100100100100100100100100001010100010100100100100010001001100100100001100001100001010001001010100100100100100010100100100100
Support
Pour toute question ou problème, contacte Q-CTRL.
Journal des modifications
-
2026-08-10 : ajout de la prise en charge des contraintes strictes (poids de Hamming égal à 1) via l'entrée
constraint, et mise à jour de l'exemple d'optimisation contrainte pour les utiliser. -
2026-02-11 : Nous prenons désormais en charge
ibm_miami
Prochaines étapes
-
Demande l'accès à Q-CTRL Optimization Solver.
-
Consulte la référence API pour cette fonction Qiskit.
-
Essaie le tutoriel Résoudre des problèmes d'optimisation binaire d'ordre supérieur avec l'Optimization Solver de Q-CTRL.
-
Consulte l'étude de cas Mazda.
-
Consulte l'étude de cas Network Rail.
-
Consulte l'étude de cas Australian Army.
-
Consulte l'étude de cas Transport for New South Wales.