Exécuter des circuits quantiques
Regarde la vidéo sur les circuits quantiques et les primitives d'Olivia Lanes, ou ouvre la vidéo dans une fenêtre séparée sur YouTube.
Aperçu de la leçon
Cette leçon donnera un aperçu général des bases de l'exécution d'un calcul quantique à l'échelle utilitaire, depuis le matériel quantique utilisé jusqu'aux principes à considérer lors de la conception d'un circuit quantique. Idéalement, à la fin de cette leçon, tu sauras :
-
Ce que sont réellement les ordinateurs quantiques IBM®. Tu devras connaître les bases des caractéristiques matérielles pour concevoir de manière optimale tes circuits quantiques afin qu'ils s'exécutent dessus.
-
Ce qu'est Qiskit, ce que sont les primitives, et comment nous pouvons les utiliser pour créer et exécuter des circuits quantiques.
-
Le flux de travail typique que nous suivons pour exécuter des expériences à grande échelle. Cela comprend la sélection des meilleures primitives pour ton cas d'usage, le mapping d'un problème vers un circuit quantique, et l'application de techniques de suppression et d'atténuation des erreurs, qui nous permettent de tirer le maximum de puissance possible de ces machines.
Matériel — processeurs quantiques IBM
Pour comprendre comment nous pouvons faire des choix optimaux dans la conception de circuits quantiques à grande échelle, nous devons en savoir un peu sur le matériel réel qui exécutera ces circuits. Discutons donc brièvement des qubits physiques et des processeurs quantiques IBM.
Les processeurs quantiques IBM sont construits à l'aide de qubits transmon supraconducteurs, qui sont des circuits électriques composés d'une jonction Josephson et d'un condensateur connectés en parallèle. La jonction Josephson est un inducteur non linéaire créé à partir de deux couches superposées de métal supraconducteur avec une barrière isolante entre elles. À très basses températures, les électrons dans les supraconducteurs se regroupent en paires pour former ce qu'on appelle une paire de Cooper. Les paires de Cooper peuvent spontanément traverser par effet tunnel la barrière isolante d'un côté de la jonction à l'autre. Ce comportement d'effet tunnel donne naissance aux propriétés non linéaires qui créent notre qubit.
Des lignes de transmission micro-ondes sont fabriquées sur la puce pour délivrer des signaux micro-ondes aux qubits. Lorsqu'on applique des impulsions micro-ondes hautement calibrées — avec des fréquences, amplitudes, formes et durées spécifiques — sur les lignes, on peut faire que les qubits effectuent des actions spécifiques. Cela constitue la base de nos portes quantiques. Nous fabriquons la puce de sorte que les qubits voisins soient connectés dans une structure de réseau spécifique appelée réseau heavy-hex. Cette connectivité — la topologie — de nos processeurs est un facteur important à considérer lors de la conception d'un circuit, comme nous le discuterons plus loin dans la leçon.
Les instructions pour l'impulsion micro-onde vont de ton ordinateur, par le cloud, et aux électroniques de contrôle à température ambiante, qui interprètent ces instructions et génèrent physiquement les impulsions. Après que les boîtiers de contrôle à température ambiante créent les impulsions, elles voyagent par des câbles dans un réfrigérateur à dilution et finalement vers la puce quantique. Le signal entre dans les résonateurs, traverse une connexion par fil de soudure, puis coule dans la ligne de transmission jusqu'à nos qubits.
IBM dispose de dizaines d'ordinateurs quantiques dans le monde, et nous avons récemment mis à niveau notre flotte pour avoir exclusivement des processeurs de plus de 100 qubits. Certains se trouvent dans un centre de données quantiques IBM dans le nord de l'État de New York et sont déployés sur le cloud pour l'usage de tous — et certains sont des systèmes dédiés, sur site, qui soutiennent les partenaires du réseau IBM Quantum®. Tu peux te connecter à quantum.cloud.ibm.com pour voir à quels processeurs tu as accès.
Chaque processeur peut être caractérisé à l'aide de trois métriques de performance fondamentales qui décrivent son échelle, sa qualité et sa vitesse : les qubits programmables, les opérations sur les qubits, et le nombre maximal de circuits par seconde.
-
Qubits programmables : ce sont les qubits que les utilisateurs peuvent contrôler directement et intégrer dans des algorithmes quantiques. Cette métrique reflète l'échelle de calcul disponible pour les applications.
-
Opérations sur les qubits (QuOps) : cette métrique décrit combien des opérations quantiques les plus exigeantes en termes de calcul un processeur peut exécuter de manière fiable avant que les erreurs accumulées ne limitent le calcul. Elle sert de mesure de la qualité et de la capacité de calcul.
-
Nombre maximal de circuits par seconde : cette métrique mesure le débit de circuits, c'est-à-dire combien de circuits quantiques un système peut exécuter par seconde. Un débit plus élevé permet d'accomplir davantage de travail utile dans un temps donné.
Tu peux également rencontrer des métriques de processeur supplémentaires dans la documentation technique, les études de benchmarking et les rapports de performance :
EPLG (Errors Per Layered Gate). Une mesure de l'erreur moyenne introduite par les opérations de portes d'intrication en couches. Un EPLG plus faible indique généralement une meilleure qualité de porte et une accumulation d'erreurs plus faible.
CLOPS (Circuit Layer Operations Per Second). Un benchmark qui mesure la rapidité avec laquelle un système quantique peut exécuter une charge de travail standardisée qui comprend à la fois des opérations quantiques et le traitement classique associé.
Ces métriques supplémentaires fournissent des informations plus détaillées sur le comportement du matériel, tandis que les qubits programmables, les opérations sur les qubits, et le nombre maximal de circuits par seconde offrent une vue de plus haut niveau de l'échelle, de la qualité et de la vitesse d'un système.
L'importance de chacune de ces métriques varie selon l'application spécifique, et dans les leçons futures, nous examinerons des exemples réels pour voir comment chacun de ces facteurs peut affecter le résultat d'un calcul.
Logiciels : Qiskit et IBM Quantum Compute Service
Pour transformer ton problème quantique en instructions pour un ordinateur quantique, tu utiliseras Qiskit, le kit de développement logiciel open-source conçu pour travailler sur des ordinateurs quantiques développé par IBM. Il y a aussi l'écosystème Qiskit — une collection de tutoriels logiciels et de fonctions qui s'appuient sur ou étendent les fonctionnalités de base de Qiskit — et Quantum Compute — un service et modèle de programmation de calcul quantique qui permet aux utilisateurs de concevoir et d'optimiser leurs charges de travail quantiques et de les exécuter efficacement en utilisant les primitives IBM Quantum.
Une primitive est un petit bloc de construction que tu peux utiliser pour concevoir un circuit ou une tâche (job) plus grande. Les deux primitives les plus importantes pour nous sont Sampler et Estimator, que nous discuterons plus en profondeur prochainement.
Avec la récente sortie de Qiskit v1.0, Qiskit est devenu plus performant et stable que jamais. Donc, si tu commences tout juste, tu es arrivé au bon moment ! Si tu es déjà familier avec Qiskit, tu devras télécharger et réinstaller la version la plus récente. Pour un guide d'installation complet, consulte le guide Installer Qiskit.
Circuits quantiques
Nous sommes maintenant prêts à discuter du fondement des programmes quantiques : les circuits quantiques. Cette section ne servira que de rappel — si tu n'es pas familier avec les circuits quantiques, nous recommandons d'en apprendre plus à leur sujet en visitant la leçon Circuits quantiques dans le cours « Bases de l'information quantique » avant de continuer.
Un circuit quantique est un réseau de portes quantiques et de mesures reliées par des fils représentant des qubits, comme illustré ci-dessous. Les circuits quantiques peuvent être lus comme des partitions musicales, de gauche à droite, en commençant au temps 0 à gauche. Les qubits virtuels — ceux qui n'ont pas encore été assignés à un qubit physique sur un processeur — sont listés en ordre croissant de haut en bas.
Les portes sont représentées par différents symboles sur les fils des qubits impliqués. Les portes à un seul qubit — comme une porte Hadamard, représentée ci-dessous (la boîte avec le H) — n'affectent que le qubit dont elle touche le fil. Les portes à plusieurs qubits — comme une porte CNOT, également représentée ci-dessous (le signe plus dans le cercle avec une ligne reliée à q0) — affectent deux qubits ou plus. Dans la porte CNOT représentée, l'état de q1 change selon l'état de q0. Après l'exécution de toutes les portes, on peut mesurer les qubits, indiqué par les portes noires avec le symbole de mesure. Les résultats des mesures sont écrits dans les registres classiques, le bus « meas » à double ligne ci-dessous.

Une caractéristique importante d'un circuit est sa profondeur. La profondeur d'un circuit quantique est le nombre minimum de « couches » de portes quantiques, exécutées en parallèle, nécessaires pour compléter le circuit. Les portes quantiques peuvent être exécutées en parallèle (en même temps) lorsqu'elles n'ont aucun qubit en commun. Mais si deux portes ou plus agissent sur le même qubit, on ne peut pas les exécuter en parallèle — elles doivent être effectuées en deux couches séparées, l'une après l'autre.
Il existe une autre façon moins évidente de déterminer la profondeur d'un circuit, en jouant à une sorte de jeu. Les règles sont simples : en partant de n'importe quel fil de qubit sur la gauche, tu dois voyager vers la droite et compter le nombre de portes que tu rencontres sur ton chemin. Tu peux sauter vers un fil voisin uniquement lorsqu'il est connecté à ton fil actuel par une porte à plusieurs qubits. Le but est de maximiser le nombre de portes que tu rencontres le long de ton chemin. Ce nombre maximal correspond également à la profondeur du circuit.
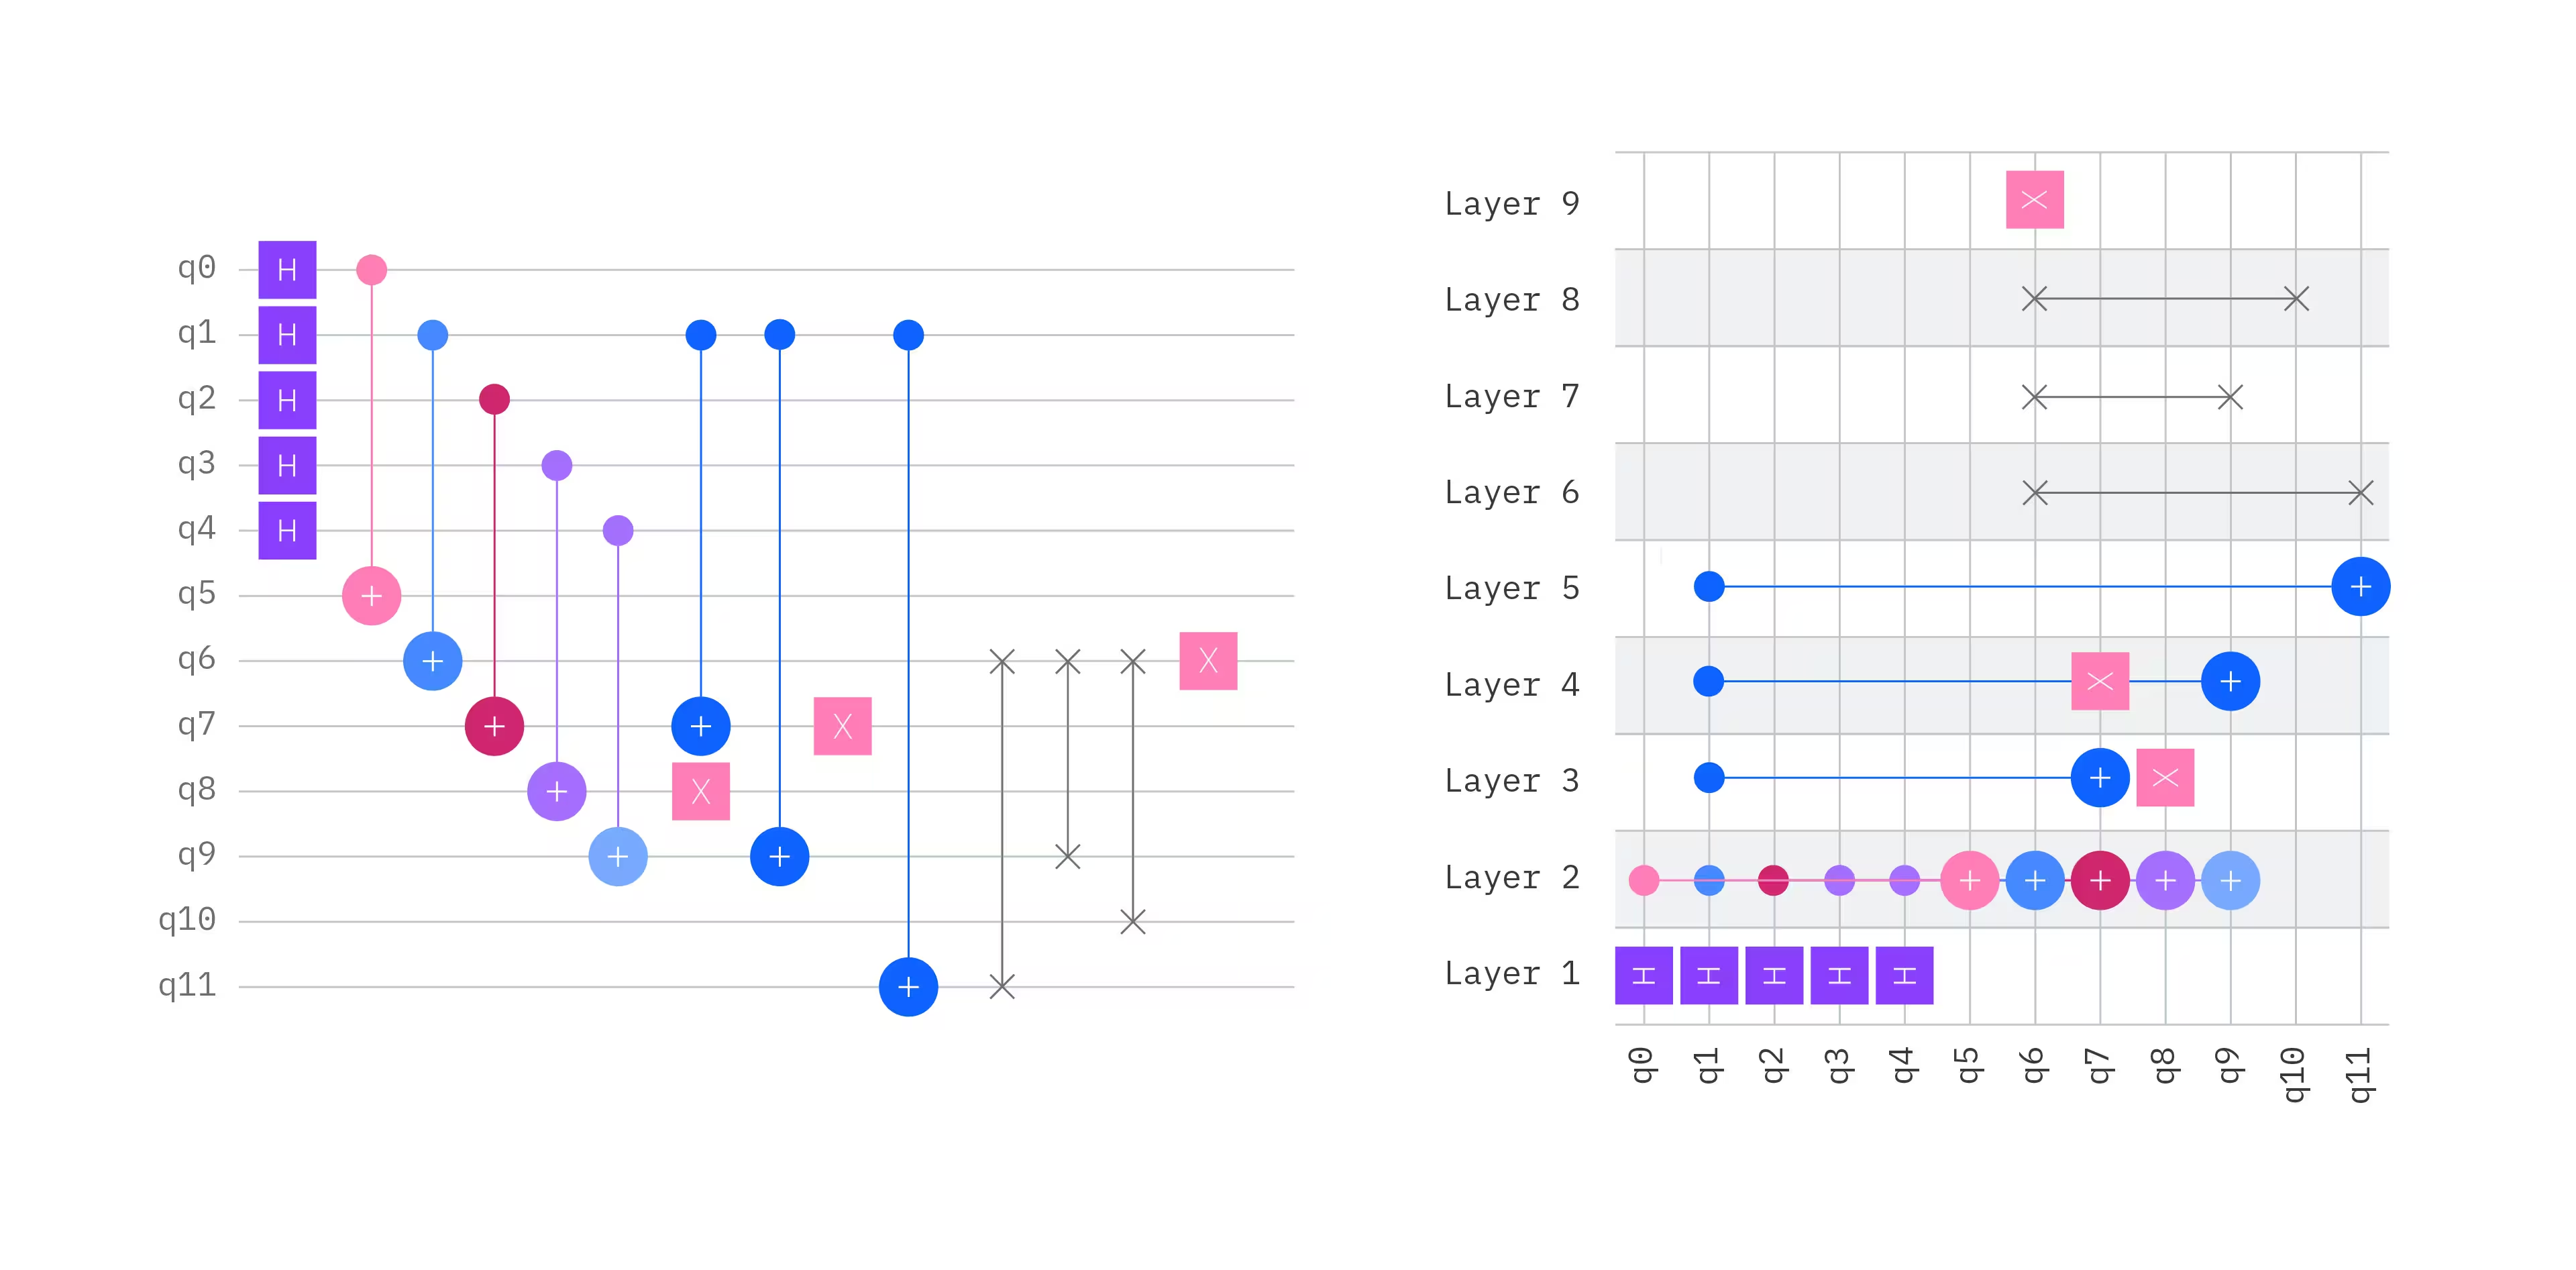
Parce que les portes quantiques prennent du temps à implémenter, la profondeur d'un circuit correspond approximativement à la quantité de temps nécessaire pour qu'un ordinateur quantique exécute le circuit. Certaines machines sont mieux adaptées aux circuits de grande profondeur que d'autres en raison des temps de décohérence des qubits sur le processeur. Nous devons donc connaître la profondeur d'un circuit pour savoir s'il peut être exécuté sur un appareil particulier.
Conception d'un circuit quantique : les motifs Qiskit
Alors, comment procède-t-on pour concevoir et exécuter un circuit quantique ? La façon la plus facile de comprendre un flux de travail typique de calcul quantique est à travers les motifs Qiskit. Les motifs Qiskit sont un cadre conceptuel permettant aux utilisateurs d'exécuter des charges de travail quantiques en implémentant certaines étapes avec des outils modulaires. Cela permet aux tâches de calcul quantique d'être effectuées par une infrastructure informatique hétérogène puissante (CPU/GPU/QPU). Les étapes peuvent être effectuées en tant que service et peuvent incorporer la gestion des ressources, ce qui permet la composabilité transparente de nouvelles capacités au fur et à mesure de leur développement.
Voici les principales étapes, que les utilisateurs expérimentés de Qiskit reconnaîtront probablement.
-
Mapper. Cette étape formalise comment nous prenons un problème général qui nous intéresse et déterminons comment le mapper sur un ordinateur quantique sous la forme d'un circuit quantique.
-
Optimiser. Dans cette étape, nous utilisons le transpileur de Qiskit pour router et disposer le circuit sur un matériel physique de qubits réel. Cela comprend la traduction des portes quantiques individuelles en séquences d'opérations effectuées sur le matériel, ainsi qu'une optimisation de la disposition des portes.
-
Exécuter. Les primitives IBM Quantum fournissent l'interface vers le matériel IBM Quantum qui permet l'exécution des circuits transpilés. Cette étape comprend également l'utilisation de techniques de suppression et d'atténuation des erreurs, qui peuvent être largement masquées à l'utilisateur.
-
Post-traiter. Dans cette étape, les données provenant du processeur quantique lui-même sont traitées, fournissant à l'utilisateur des résultats utiles sur le problème d'origine. Fondamentalement, cela englobe toute analyse supplémentaire des données acquises.
Correspondance
L'étape de correspondance pose essentiellement la question : « Comment je traduis mon problème en circuit quantique qui peut raisonnablement être exécuté sur du matériel quantique ? » C'est indéniable : la correspondance est un problème difficile et un domaine de recherche actif. Il n'existe pas de méthode infaillible qui garantit le succès, mais il y a des lignes directrices recommandées et des exemples de problèmes qu'on sait déjà comment mapper.
La première directive est de laisser les ordinateurs classiques faire tout le travail pour lequel ils sont meilleurs. Les tâches faciles pour les ordinateurs classiques ne bénéficieront probablement pas d'un ordinateur quantique. Les ordinateurs quantiques sont pour les problèmes classiquement difficiles. Bien sûr, si c'est ta toute première fois que tu utilises Qiskit ou un ordinateur quantique, ne t'inquiète pas de trouver un problème computationnellement complexe. Décompose-le en problèmes plus petits et faciles à gérer que tu peux apprendre à résoudre avant de te lancer directement dans un projet à l'échelle utilitaire.
Ensuite, traduis les résultats de ton problème que tu souhaites mesurer ou comprendre en une valeur d'espérance ou une fonction de coût. Une fonction de coût est une fonction spécifique au problème qui définit l'objectif du problème comme quelque chose à minimiser ou maximiser. Elle peut être utilisée pour voir à quel point un état ou une solution d'essai se comporte par rapport à cet objectif. Cette notion peut être appliquée à diverses applications en chimie, apprentissage automatique, finance, optimisation, etc. — la discipline d'où tu abordes le problème n'a pas forcément d'importance.
Garde également à l'esprit que le matériel que tu vas utiliser a une topologie spécifique, comme nous l'avons discuté dans la section matériel. Certains qubits sont connectés, et d'autres non — tu devras mapper ton problème à un circuit qui respecte la topologie heavy-hex des processeurs quantiques IBM.
Pour l'instant, la chose la plus importante à garder à l'esprit est que cette étape nécessite de la pratique. Tu dois avoir une bonne compréhension non seulement de ton problème, mais aussi des capacités du matériel — et nous examinerons des exemples spécifiques et des cas d'usage dans les leçons futures pour voir comment équilibrer toutes ces considérations.
Optimisation
Ensuite, nous devrons choisir un processeur quantique qui a suffisamment de qubits de qualité suffisamment élevée pour que nous puissions exécuter notre circuit quantique. Prends ces décisions guidé par les trois métriques principales dont nous avons discuté dans la section matériel : les qubits programmables, les opérations sur les qubits, et le nombre maximal de circuits par seconde. Selon l'application, des métriques supplémentaires telles que l'EPLG et les CLOPS peuvent également fournir des informations utiles sur la qualité et la performance d'exécution des circuits attendues.
Nous optimisons ensuite notre circuit pour le matériel sélectionné. Premièrement, nous devons disposer et router efficacement notre circuit. La disposition fait référence à la correspondance des qubits virtuels dans le circuit aux qubits physiques sur le processeur. Le routage fait référence à la modification du circuit pour que la connectivité entre les qubits virtuels dans le circuit corresponde à la connectivité des qubits physiques sur le processeur. Il y a quelques points à garder à l'esprit lors de l'étape de disposition et de routage.
-
Tous les qubits ne sont pas connectés. Certains sont très éloignés les uns des autres sur la puce, et nous devons réduire ou éliminer les interactions à longue distance dans la mesure du possible. Tu pourrais appliquer une séquence de portes SWAP entre qubits voisins pour déplacer l'information des qubits, mais les portes SWAP sont coûteuses et sujettes aux erreurs, donc il peut y avoir de meilleures façons de faire cela. Essaie d'éviter trop de portes SWAP coûteuses.
-
La disposition et le routage sont des processus itératifs. Tu peux le faire à la main, mais il existe aussi un outil Qiskit appelé
mapomatic, qui peut faire des recommandations pour une disposition physique des qubits basée sur des taux d'erreur approximatifs. Le transpileur (dont nous parlerons bientôt) peut également faire une suggestion éclairée.
Ensuite, on peut composer des séquences de portes à un qubit agissant sur le même qubit en portes uniques — et on peut parfois aussi se débarrasser de portes inutiles ou de combinaisons de portes. Par exemple, certaines combinaisons de portes peuvent être réduites à des combinaisons plus simples — et en fait, parfois une combinaison de portes peut équivaloir à l'opération identité, donc on peut simplement les éliminer. Tu peux le faire automatiquement en utilisant le transpileur Qiskit — mais tu peux aussi le faire manuellement porte par porte si tu veux plus de contrôle.
Une fois que nous avons amélioré la disposition, le routage et le nombre de portes du circuit — que ce soit à la main ou en utilisant le transpileur — nous voulons généralement visualiser notre circuit pour nous assurer que le timing de toutes les portes a du sens. Il existe une option que tu peux activer dans le transpileur pour visualiser la chronologie de ton circuit, et t'assurer que tout est aligné comme tu le souhaites.
Transpileur Qiskit
Comme mentionné précédemment, le Transpileur Qiskit peut être utilisé pour aider dans les premières étapes du flux de travail des motifs. Maintenant, examinons ses capacités plus en détail. Il peut réécrire un circuit d'entrée donné pour qu'il corresponde à la topologie d'un appareil quantique spécifique et optimiser le circuit pour l'exécution et la résistance au bruit. Il réécrit également un circuit donné en portes de base du processeur quantique spécifique que tu as sélectionné.
Qiskit a quatre pipelines de transpilation intégrés correspondant à différents niveaux d'optimisation, et à moins d'être déjà familier avec l'optimisation de circuits quantiques, nous recommandons d'en utiliser un. Par défaut, le processus de transpilation comprend ces six étapes :
-
Initialisation. Cette étape exécute toutes les passes initiales requises avant de commencer à intégrer le circuit sur le backend. Cela implique généralement de dérouler les instructions personnalisées et de convertir le circuit en portes à un et deux qubits uniquement.
-
Disposition. Cette étape mappe les qubits virtuels du circuit vers les qubits physiques d'un backend. Voir Layout Stage pour plus de détails.
-
Routage. Cette étape s'exécute après l'application d'une disposition et injecte des portes (telles que des portes swap) dans le circuit d'origine pour le rendre compatible avec la connectivité du backend. Voir Routing Stage pour plus de détails.
-
Traduction. Cette étape traduit les portes du circuit vers le jeu de base du backend cible. Voir Translation Stage pour plus de détails.
-
Optimisation. Cette étape exécute la boucle d'optimisation principale de manière répétée jusqu'à ce qu'une condition (comme atteindre une certaine profondeur cible) soit remplie. Nous disposons de quatre niveaux d'optimisation différents parmi lesquels choisir, décrits ci-dessous.
-
Planification. Cette étape concerne les passes de planification tenant compte du matériel. À un niveau élevé, la planification peut être vue comme l'insertion de délais dans le circuit pour tenir compte du temps d'inactivité des qubits entre l'exécution des instructions.
Il existe quatre niveaux d'optimisation allant de 0 à 3, où des niveaux d'optimisation plus élevés prennent plus de temps et d'efforts computationnels mais peuvent produire un meilleur circuit. Le niveau d'optimisation 0 est destiné aux expériences de caractérisation d'appareils et, en tant que tel, mappe uniquement le circuit d'entrée aux contraintes du backend cible, sans effectuer d'optimisations. Le niveau d'optimisation 3 consacre le plus d'efforts à l'optimisation du circuit. Cependant, comme de nombreuses techniques d'optimisation dans le transpilateur sont basées sur des heuristiques, consacrer plus d'efforts computationnels ne résulte pas toujours en une amélioration de la qualité du circuit de sortie. Si cela t'intéresse davantage, consulte la documentation du transpilateur dans la documentation Qiskit.
Suppression d'erreurs
La première étape pour réduire les erreurs dans un circuit est l'optimisation de la disposition, du routage et la minimisation du nombre de portes, ce que nous avons déjà fait, que ce soit en utilisant le transpilateur ou par nous-mêmes. Parlons maintenant de méthodes plus sophistiquées de suppression d'erreurs.
La suppression d'erreurs désigne une classe de techniques qui transforment un circuit lors de la compilation pour minimiser les erreurs. Elle est distincte de l'atténuation d'erreurs, dont nous discuterons plus tard dans la section « Exécution » ci-dessous. Les deux formes les plus courantes de suppression d'erreurs que nous utilisons sont le découplage dynamique et le Pauli twirling :
-
Le découplage dynamique est utilisé pour annuler efficacement une partie du bruit environnemental introduit lorsqu'un qubit reste inactif. En appliquant une série de portes à des moments précis, tu peux faire en sorte que le bruit accumulé dans une partie de la période d'inactivité annule approximativement le bruit dans l'autre partie.
-
Le Pauli twirling est un moyen d'insérer des portes aléatoires non pas pour annuler le bruit, comme dans le découplage dynamique, mais pour le simplifier. En insérant des portes aléatoires, cela empêche les effets de différentes erreurs de s'accumuler aussi rapidement, et rend le bruit plus facile à caractériser, puisqu'il a désormais une nature stochastique. Cette méthode constitue également la base d'une technique puissante d'atténuation des erreurs, dont nous parlerons ci-dessous.
Exécution
Nous sommes maintenant prêts à exécuter le programme quantique. Les primitives IBM Quantum fournissent une interface avec le matériel IBM Quantum, et elles abstraient également la suppression et l'atténuation d'erreurs de l'utilisateur. Il y a deux primitives parmi lesquelles choisir : l'Échantillonneur et l'Estimateur.
L'Échantillonneur IBM Quantum exécute le circuit plusieurs fois sur un appareil quantique, effectuant des mesures à chaque exécution, et reconstruisant la distribution de probabilité à partir des chaînes de bits récupérées. Plus il effectue d'exécutions (ou coups), plus les résultats seront précis, mais cela nécessite plus de temps et de ressources quantiques. En particulier, il calcule la probabilité d'obtenir chaque état de base standard possible en mesurant l'état préparé par le circuit.
L'Estimateur IBM Quantum utilise un processus algébrique complexe pour estimer la valeur d'espérance sur un appareil quantique réel en décomposant l'observable en une combinaison d'autres observables avec des bases propres connues.
L'étape d'exécution est également le moment où nous pouvons sélectionner la stratégie d'atténuation d'erreurs. L'atténuation d'erreurs désigne des techniques qui permettent aux utilisateurs de réduire les erreurs de circuit en modélisant le bruit de l'appareil qui était présent au moment de l'exécution. Typiquement, cela entraîne une surcharge de pré-traitement quantique liée à l'entraînement du modèle et une surcharge de post-traitement classique pour atténuer les erreurs dans les résultats bruts en utilisant le modèle généré. En échange de cette surcharge, nous sommes capables d'obtenir des résultats beaucoup plus précis.
Il existe plusieurs techniques que nous pouvons implémenter pour l'atténuation d'erreurs. Nous en discuterons trois, dans l'ordre croissant de résistance aux erreurs, mais aussi, par conséquent, dans l'ordre croissant du coût computationnel. Sois conscient, cependant, que c'est un domaine de recherche actif — donc nous continuerons probablement à en inventer de nouvelles et à améliorer les anciennes.
Au niveau de résilience 0, le transpilateur ne fait rien à ton circuit.
Au niveau 1, il introduit une méthode appelée Twirled Readout Error eXtinction (T-REX). T-REX utilise le Pauli twirling, comme discuté dans la section de suppression d'erreurs. Comme mentionné, insérer des portes aléatoires dans le circuit peut faire en sorte que même un bruit très compliqué et difficile à modéliser paraisse stochastique, et beaucoup plus facile à prendre en compte ou à soustraire dans le post-traitement.
Au niveau de résilience 2, l'Extrapolation à Bruit Zéro (ZNE) est ajoutée. C'est une technique populaire avec laquelle nous avons eu beaucoup de succès récemment. L'idée derrière ZNE peut être un peu surprenante — nous ajoutons réellement du bruit par-dessus ce qui est déjà là ! Mais cela nous permet d'extrapoler dans la direction inverse, pour prédire à quoi ressembleraient les résultats s'il y avait de moins en moins de bruit.
L'ajout de bruit peut être accompli de quelques façons différentes. Par exemple, on peut étirer les portes pour les rendre plus longues et donc plus sujettes aux erreurs, ou exécuter plus de portes qui donnent finalement une opération identité, donc le circuit ne change pas fonctionnellement mais on échantillonne intentionnellement plus de bruit. Tu dois cependant faire cela pour chaque circuit et chaque valeur d'espérance que tu veux suivre — donc tu peux voir comment cela peut finir par être computationnellement coûteux.
Un type spécifique de ZNE s'appelle l'Amplification d'Erreurs Probabiliste (PEA). Une fois que nous avons appris un modèle de bruit pour une porte, PEA fonctionne en échantillonnant des erreurs à partir de ce modèle de bruit et en les injectant délibérément dans le circuit. Ce n'est pas encore disponible dans Qiskit, mais ce le sera plus tard cette année.
La dernière forme d'atténuation d'erreurs dont nous discuterons est l'Annulation d'Erreurs Probabiliste (PEC). Au lieu d'être au 3ème niveau de résilience, PEC est une capacité spéciale que tu dois activer manuellement dans Qiskit, car les ressources computationnelles requises ne se dimensionnent pas très bien par rapport aux autres techniques d'atténuation d'erreurs. Tu commences par apprendre le bruit qui affecte ton circuit — exécute des circuits d'apprentissage du bruit ou de caractérisation du bruit pour chaque couche unique de portes à deux qubits dans ton circuit. Ces résultats te permettent de décrire le bruit en termes d'opérateurs de Pauli. Une fois que tu connais ces termes de bruit, tu peux modifier tes circuits pour qu'ils aient effectivement les portes de Pauli opposées intégrées pour annuler ces canaux de bruit. À certains égards, le processus est similaire au fonctionnement des casques anti-bruit. Cependant, cette façon d'annuler le bruit est très coûteuse, avec un temps d'exécution qui croît rapidement et exponentiellement avec le nombre de portes, donc ce n'est peut-être pas le meilleur choix pour un très grand circuit.
Post-traitement
L'étape de post-traitement est l'endroit où nous visualisons et analysons la sortie de notre circuit quantique. Il existe un certain nombre d'outils Qiskit disponibles pour le faire, comme les modules de visualisation et quantum-info. Nous ne les couvrirons pas ici, mais nous verrons ces modules en action lorsque nous plongerons dans des exemples d'applications dans les leçons futures.
Conclusion
Espérons que cette leçon t'a donné une visite éclair des principales considérations et du flux de travail que nous utilisons lorsque nous voulons exécuter un calcul quantique à l'échelle utilitaire. Elle était riche en informations, et une grande partie ne s'assimilera pas avant de voir des exemples concrets où ces concepts théoriques sont mis en pratique. C'est donc ce que sera le reste du cours. Après tout, ce cours ne s'appelle pas « Le calcul quantique en pratique » pour rien !
La prochaine fois, nous examinerons un exemple spécifique de la façon d'utiliser le flux de travail des motifs Qiskit pour concevoir et exécuter un circuit quantique qui résout le problème classique de théorie des graphes appelé MaxCut.