Apprendre des états quantiques bruités avec les ombres classiques
Estimation d'utilisation : 34 minutes sur un processeur Heron r2 (REMARQUE : il s'agit uniquement d'une estimation. Ton temps d'exécution peut varier.)
Objectifs d'apprentissage
-
Collecter des mesures aléatoires sur un processeur quantique IBM® depuis Julia et les enregistrer pour une analyse ultérieure
-
Vérifier les données de mesure à la recherche de qubits et de portes défectueux avant l'apprentissage
-
Ajuster un modèle d'opérateur de produit matriciel (MPO) d'un état bruité à des ombres classiques
-
Valider le modèle sur des mesures mises de côté et le comparer avec le circuit idéal
Prérequis
-
Les ombres classiques, telles qu'introduites dans le tutoriel Tomographie par ombres de l'état de Greenberger-Horne-Zeilinger (GHZ)
-
Les matrices densité et les états mixtes, abordés dans Bases de l'information quantique
-
L'exécution de circuits depuis Julia avec
Qiskit.jletQiskitIBMRuntime.jl, introduite dans le tutoriel Simuler l'évolution temporelle du modèle d'Ising à champ transverse
Contexte
Sur un vrai processeur quantique, le bruit transforme l'état pur qu'un circuit est conçu pour préparer en un état mixte . La tomographie complète de l'état quantique peut reconstruire , mais le nombre de mesures nécessaires croît de façon exponentielle avec le nombre de qubits. Votto et al. [1] ont plutôt appris un modèle compact de pour jusqu'à 96 qubits à partir de mesures aléatoires. Ce tutoriel suit leur workflow.
Dans une mesure aléatoire [2], chaque qubit est tourné par une unitaire aléatoire indépendante , puis mesuré dans la base computationnelle. Un tirage des rotations s'appelle un réglage de mesure, et chaque réglage est répété pour shots. Un shot dont les bits de résultat sont donne l'ombre classique [3]
dont la moyenne sur les réglages et les shots est . Le tutoriel prérequis tire chaque parmi les trois bases de Pauli ; ce tutoriel, comme l'article, les tire uniformément parmi toutes les unitaires à un qubit (aléatoires selon la mesure de Haar), et la même formule s'applique.
Les ombres estiment les propriétés de quelques qubits à la fois. L'article les combine en un opérateur de produit matriciel (MPO), qui écrit la matrice densité comme une chaîne de petits tenseurs, un par qubit ; les états bruités à corrélations de courte portée n'ont besoin que de petites liaisons entre tenseurs voisins. Comme l'algorithme du groupe de renormalisation de la matrice densité (DMRG), l'apprenant balaie la chaîne et met à jour un tenseur à la fois, de sorte que le modèle corresponde aux ombres sur la fenêtre de qubits centrée sur ce tenseur (équation 4 de l'article). La dimension de liaison reste fixe pendant ces mises à jour, si bien que l'apprenant ne tronque jamais le modèle. Comme les données n'entrent que par ces fenêtres, le nombre de réglages nécessaires ne croît pas avec la longueur de la chaîne.
Les réglages sont répartis en un ensemble d'entraînement et un ensemble de test. Sur l'ensemble de test, l'article estime la fidélité maximale entre et le modèle ,
Mesurer directement nécessiterait un nombre exponentiel de mesures. À la place, l'article suppose la condition de factorisation approchée (AFC) : les corrélations dans décroissent sur quelques qubits, de sorte que les recouvrements et puretés globaux se factorisent en termes sur des blocs de qubits voisins. La pureté donne aussi l'entropie de Rényi-2 , qui mesure à quel point l'état est mixte.
L'article prépare l'état d'Ising à impulsions (kicked-Ising) de profondeur
sur 96 qubits de ibm_brisbane, un processeur Eagle, avec 2 048 réglages de 1 024 shots pour . La figure 1(c,d) de l'article rapporte deux résultats pour :
-
Le modèle appris atteint avec l'état expérimental pour , bien au-dessus du recouvrement de l'état idéal avec l'expérience.
-
L'entropie croît linéairement, , et l'entropie du modèle concorde avec une estimation indépendante obtenue à partir de l'ensemble de test.
Ce tutoriel vérifie les deux résultats, d'abord dans une simulation à huit qubits où les réponses exactes sont connues, puis dans une nouvelle exécution à 96 qubits sur ibm_fez, un processeur Heron r2. L'apprenant est une implémentation Julia indépendante des équations de l'article et de son supplément.
Prérequis techniques
Ce tutoriel nécessite macOS ou Linux, car Qiskit.jl ne prend pas encore en charge Windows (issue Qiskit.jl n°15). Tu as aussi besoin de ce qui suit :
-
Julia 1.11, depuis la page de téléchargement de Julia ou avec
juliaup add 1.11, et le paquetIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Pour l'exemple sur matériel, un compte IBM Quantum® Platform avec accès à un QPU d'au moins 96 qubits, et des identifiants enregistrés. Sans compte, tu peux exécuter l'exemple sur matériel à partir des mesures enregistrées de l'exécution sur
ibm_fezqui a produit les résultats de ce tutoriel. Les autres sections s'exécutent sans compte.
Le notebook utilise Qiskit.jl et QiskitIBMRuntime.jl pour construire et exécuter des circuits, RandomMeas.jl [4] pour les mesures aléatoires (il fournit aussi ITensors.jl et ITensorMPS.jl), et NPZ.jl, JSON.jl et Plots.jl. Ce tutoriel est testé avec Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 et RandomMeas.jl 0.3.1.
Il y a deux façons de configurer l'environnement :
-
Option 1 : installe les dernières versions compatibles des paquets dans un environnement temporaire. Exécute la cellule suivante sans modification.
-
Option 2 : reproduis exactement l'environnement testé. Définis
download_toml_files = truedans la cellule suivante. La cellule téléchargeProject.tomletManifest.tomldepuis le dépôt de documentation dans un dossierenv_tutorial/classical-shadows/à côté de ce notebook, puis installe la version exacte de chaque paquet consignée dans le manifeste, y compris les dépendances indirectes. Pour plus de détails, consulte la documentation Julia sur ces fichiers.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Configuration
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
Le module d'aide mpo_learning.jl, que la cellule de configuration télécharge, implémente l'apprenant. Le tutoriel en appelle les fonctions suivantes :
| Fonction | Rôle |
|---|---|
kicked_ising_reference(N, D; depolarization) | MPO exact de l'état d'Ising à impulsions idéal, ou de l'état après un bruit dépolarisant local |
split_settings(group; seed, train_fraction) | Répartit aléatoirement les réglages de mesure entre ensembles d'entraînement et de test (moitié-moitié par défaut) |
training_marginals(train; ell, prior) | Estimations par ombres de chaque fenêtre d'apprentissage, à partir des seuls réglages d'entraînement |
fitted_prior(ideal, train) | A priori pour les mesures aléatoires communes (CRM), ajusté à la pureté mesurée de chaque fenêtre, comme dans l'article |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Balaie la chaîne avec la mise à jour à un site de l'article, en partant de l'état maximalement mixte |
max_fidelity(a, b), mpo_overlap(a, b) | exact et entre deux MPO |
afc_estimate, afc_statistics, afc_prefix_curve | Estimations AFC de et de à partir des réglages de test, avec barres d'erreur par jackknife |
L'apprenant stocke le MPO dans la base de Pauli. Cela garde le modèle hermitien de trace unité, mais ne force pas le modèle à être semi-défini positif ; le notebook indique donc à quel point ses valeurs propres deviennent négatives.
Exemple à petite échelle sur simulateur
Commence avec un système assez petit pour tout calculer exactement : l'état d'Ising à impulsions de profondeur un sur huit qubits, avec 12 % de bruit dépolarisant local pour modéliser le matériel. Comme l'état bruité est connu, tu peux comparer directement le modèle appris avec lui.
Étape 1 : transposer les entrées classiques en un problème quantique
La fonction kicked_ising_reference renvoie l'état exact sous forme de MPO. Avec depolarization=0.12, le vecteur de Bloch de chaque qubit rétrécit de 12 % après le circuit.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Étape 2 : optimiser le problème pour l'exécution sur matériel quantique
Cet exemple échantillonne les résultats de mesure de façon classique, il n'y a donc aucun circuit à transpiler. L'exemple sur matériel couvre cette étape.
Étape 3 : exécuter avec les primitives Qiskit
Utilise RandomMeas.jl pour tirer 2 048 réglages de mesure aléatoires selon la mesure de Haar et échantillonner 256 shots pour chacun, puis répartis les réglages à parts égales entre ensembles d'entraînement et de test. Sépare par réglage plutôt que par shot : les shots d'un même réglage partagent ses rotations, ils ne sont donc pas indépendants.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Étape 4 : post-traiter et renvoyer le résultat au format classique souhaité
Apprends le modèle avec les paramètres de profondeur un de l'article : des fenêtres qui s'étendent sur qubits de chaque côté du tenseur mis à jour, une dimension de liaison de 4 et 20 balayages à partir de l'état maximalement mixte. Le premier balayage met à jour des paires de tenseurs voisins, ce qui permet à la dimension de liaison de passer de 1 à 4 ; chaque balayage suivant met à jour un tenseur à la fois avec cette dimension de liaison fixe.
Pour réduire le bruit statistique des ombres, l'article utilise des mesures aléatoires communes (CRM) [5]. Pour chaque réglage, il soustrait l'ombre moyenne qu'une estimation a priori de l'état produirait dans le même réglage, puis rajoute la valeur exacte de cet a priori. La correction a une moyenne nulle, donc l'a priori modifie la taille de l'erreur statistique mais pas ce qui est estimé. Ici, l'a priori est l'état idéal avec 10 % de dépolarisation locale, proche des 12 % réels. Sur le matériel, le niveau de bruit est inconnu ; l'exemple sur matériel ajuste donc l'a priori à des puretés mesurées, comme le fait l'article.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
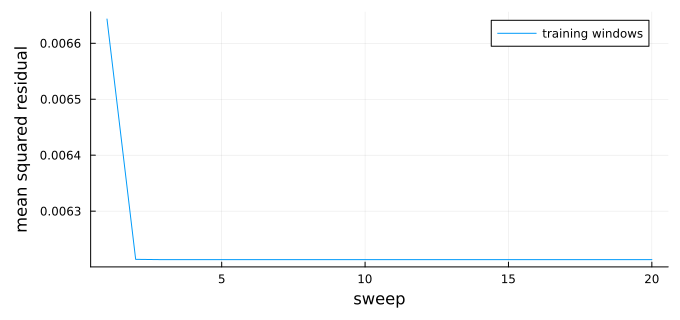
Le résidu mesure à quel point les fenêtres du modèle s'écartent des ombres d'entraînement. Il chute lorsque les mises à jour à un site commencent, au deuxième balayage, puis reste approximativement constant au lieu d'atteindre zéro, car les ombres contiennent du bruit statistique qu'un modèle à petite dimension de liaison ne peut pas reproduire.
Comme cet état est connu, tu peux comparer exactement le modèle appris avec lui, et aussi comparer avec lui les deux suppositions les plus simples : l'a priori CRM et l'état idéal.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
Le modèle appris est plus proche de l'état bruité que l'a priori ou l'état idéal, il a donc appris le bruit à partir des données. Ses petites valeurs propres négatives proviennent du nombre fini de mesures.
Sur le matériel, l'état est inconnu, donc tu estimes à partir des réglages de test. AFC découpe la chaîne en blocs de qubits et approxime la pureté par
et par le même rapport de recouvrements locaux. Avec , les deux blocs couvrent les huit qubits et la formule est exacte ; avec , elle repose sur l'hypothèse de factorisation. Les barres d'erreur jackknife, qui laissent de côté un réglage de test à la fois, ne couvrent que l'erreur statistique des données de test, pas le caractère aléatoire de l'entraînement ni l'approximation AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Les deux estimations sur données réservées concordent avec la valeur exacte dans leurs barres d'erreur.
Exemple matériel à grande échelle
Exécute maintenant l'expérience sur une chaîne de 96 qubits de ibm_fez, un processeur Heron r2. Comme ibm_brisbane, il a une carte de couplage heavy-hex et un niveau de bruit similaire.
La collecte des données demande 1 024 jobs Sampler et environ 34 minutes de temps QPU. Si tu n'as pas accès à un QPU d'au moins 96 qubits, ou si la file d'attente est longue, exécute l'exemple matériel à partir des mesures enregistrées sur ibm_fez le 27 septembre 2026, qui ont produit les résultats montrés dans ce tutoriel. Avec use_saved_data = true, le notebook télécharge ces mesures (15 Mo) depuis Zenodo [6] à l'étape 1 et saute la soumission des jobs à l'étape 3. Pour collecter tes propres données, mets-le à false.
use_saved_data = true; # set to false to collect new measurements on hardware
Étape 1 : Mapper les entrées classiques vers un problème quantique
Chaque réglage nécessite un circuit : le circuit de kicked-Ising, une porte sur chaque qubit pour , et une mesure de chaque qubit. Tirer , avec , et uniformes dans , rend aléatoire de Haar. La fonction u3_matrix renvoie la matrice de , que l'étape 4 utilise.
Le budget est de 1 024 réglages de 1 024 shots, soit la moitié du nombre de réglages de l'article, répartis à égalité entre entraînement et test. Avec les données enregistrées, la cellule charge les angles enregistrés. Sinon, elle tire de nouveaux angles et les enregistre avant que tu soumettes quoi que ce soit, car tu ne peux pas analyser les résultats sans eux. Si le fichier existe déjà, la cellule le charge, de sorte que les angles correspondent toujours aux résultats enregistrés après le redémarrage de la session.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Étape 2 : Optimiser le problème pour l'exécution sur le matériel quantique
Une chaîne ne vaut que par son pire qubit, donc choisis toi-même les 96 qubits physiques. La fonction transpile de Qiskit.jl ne peut pas encore accepter une disposition initiale fixe, et lors d'un test sur ibm_phoenix, la disposition qu'elle a choisie incluait un qubit avec 51 % d'erreur de lecture. La chaîne suivante est le chemin de 96 qubits de la carte de couplage de ibm_fez que la disposition sensible aux erreurs de la fonction transpile du Qiskit Python (avec optimization_level=3) a sélectionné à partir des données de calibration du 27 septembre 2026. Son erreur de lecture moyenne est de 1,6 %, mais un réseau heavy-hex a peu de chemins de 96 qubits, et celui-ci inclut le qubit 35, qui a une erreur de lecture de 15 %. Les calibrations changent, donc choisis une nouvelle chaîne à partir des données de calibration actuelles avant d'exécuter un autre jour ou sur un autre QPU.
Pour conserver cette chaîne, écris les circuits directement en portes natives au lieu de les transpiler. Une porte est égale à à une phase globale près. Cette décomposition couvre à la fois les rotations aléatoires et le kick . La porte est égale à une porte CZ suivie de sur les deux qubits, à une phase globale près. Comme ces portes sont diagonales, elles commutent avec les portes CZ, donc chaque qubit accumule un par liaison avant sa rotation de mesure.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Étape 3 : Exécuter avec les primitives Qiskit
QiskitIBMRuntime.jl exécute un circuit par job Sampler, donc la collecte des données nécessite 1 024 jobs. La cellule suivante garde jusqu'à 32 jobs dans la file d'attente et enregistre les résultats de chaque réglage dès que son job se termine. Chaque shot est renvoyé sous forme de vecteur de bits, dont l'élément est le résultat du qubit de la chaîne.
Tu dois récupérer les résultats dans la même session que celle qui a soumis les jobs, car QiskitIBMRuntime.jl ne peut pas encore retrouver un job par son ID (qiskit-ibm-runtime-c issue #28). Si un job échoue, la cellule émet un avertissement et continue. Si la session s'arrête, exécute à nouveau les étapes 1 à 3. Relancer la cellule ne soumet que les réglages dont les résultats manquent. Avec use_saved_data = true, la cellule ne soumet rien.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Étape 4 : Post-traiter et renvoyer le résultat dans le format classique souhaité
Cette étape ne lit que des données enregistrées : l'exécution ibm_fez téléchargée si use_saved_data est vrai, ou sinon les fichiers que l'étape 3 a écrits. Tu peux donc l'exécuter dans une nouvelle session sans soumettre de jobs (exécute d'abord la cellule Setup, la cellule use_saved_data et l'étape 1). Le fichier téléchargé stocke les 96 résultats de chaque shot empaquetés sur 12 octets, bit de poids fort en premier, donc le chargeur les dépaquette. RandomMeas.jl étiquette les résultats 1 et 2, donc le chargeur ajoute aussi 1 à chaque bit.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Avant d'apprendre, vérifie les données. Un qubit défaillant ou une porte mal calibrée rend l'état mesuré beaucoup plus mélangé autour d'eux, et peut faire diverger l'apprentissage. La pureté de quelques qubits voisins est un benchmark sans modèle de ce bruit : la fonction get_purity de RandomMeas.jl estime pour un sous-système en comparant des paires de shots du même réglage. Calcule l'entropie de Rényi-2 de chaque fenêtre de six qubits voisins, et compare-la à la même fenêtre de l'état idéal. La valeur idéale n'est pas nulle, car chaque fenêtre est intriquée avec le reste de la chaîne ; le bruit l'augmente, et un qubit défaillant pousse chaque fenêtre qui le contient vers le maximum de six.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
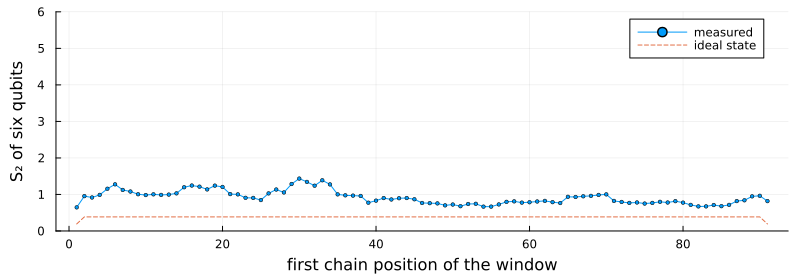
Chaque fenêtre est plus mélangée que l'état idéal, d'environ un demi-bit à un bit, et la portion la plus bruitée se situe autour des positions 30 à 35 de la chaîne. Aucune fenêtre n'approche du maximum de six, donc aucun qubit n'est défaillant, et l'analyse utilise toute la chaîne de 96 qubits. Si certaines fenêtres avaient une entropie proche de six, tu retirerais le qubit que ces fenêtres partagent et apprendrais la plus longue partie de la chaîne sans lui.
Les mêmes puretés déterminent le prior CRM. Pour chaque fenêtre, fitted_prior prend l'état idéal et ajuste une intensité de dépolarisation locale pour que sa pureté corresponde à la pureté mesurée dans les réglages d'entraînement, comme dans l'article.
La fonction learn_and_validate de la cellule suivante réalise le reste de l'analyse. Elle apprend le modèle à partir des réglages d'entraînement, puis estime et sur les réglages de test pour les premiers qubits de la chaîne, par pas de 12. Ce sont les quantités de la figure 1(c,d) de l'article. L'état idéal est évalué sur les mêmes données de test comme référence.
La cellule exécute la fonction avec puis la répète avec et pour voir l'importance de la taille des fenêtres d'apprentissage. La dimension de liaison peut valoir au plus , donc apprend un état produit : chaque qubit seul, sans corrélations entre les qubits.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
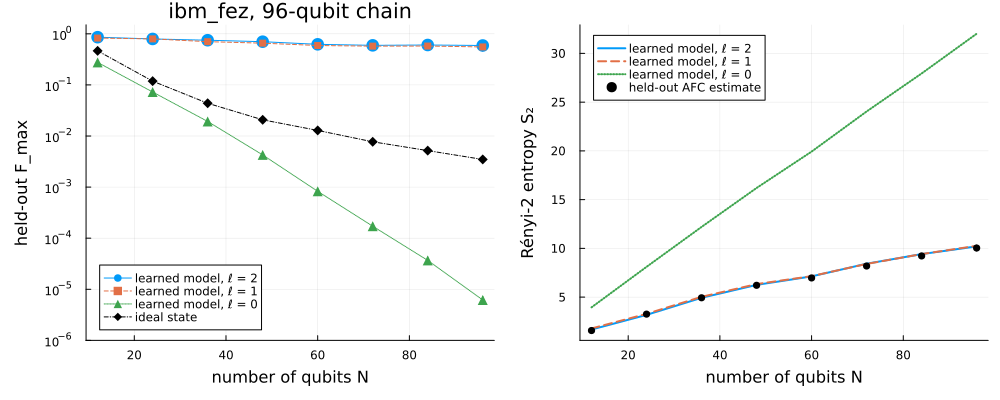
Les résultats reproduisent les deux affirmations de l'article sur un processeur différent :
-
Le modèle décrit les données bien mieux que l'état idéal. Pour , le sur données réservées du modèle est de 0,59 ± 0,10, contre 0,0035 pour l'état idéal. L'article rapporte environ 0,75 sur
ibm_brisbane. -
L'entropie du modèle concorde avec les données de test pour chaque . Pour , elle vaut 10,2 pour le modèle et 10,0 ± 0,3 pour les données de test, soit , contre 0,14 à 0,15 sur l'ancien
ibm_brisbane.
La comparaison des tailles de fenêtre montre où se trouve l'information. Avec , le modèle est presque aussi bon (), donc pour ces données, les corrélations au-delà de quelques qubits apportent peu. Avec , l'état produit manque l'intrication entre qubits voisins : son entropie monte à 32 au lieu de 10, et son chute encore plus vite que celui de l'état idéal, jusqu'à pour .
Garde les limites suivantes en tête quand tu lis ces chiffres :
-
Répartition d'entraînement. Les barres d'erreur ne couvrent que l'erreur statistique des données de test. D'autres répartitions aléatoires des mêmes réglages donnent un entre 0,49 et 0,59 pour avec .
-
Dernier balayage. L'algorithme d'apprentissage renvoie toujours le modèle du dernier balayage, donc les données de test n'influencent jamais le modèle.
-
Positivité. Le modèle n'est pas contraint d'être semi-défini positif ; sa valeur propre la plus négative dans une fenêtre d'apprentissage est d'environ . Son et son décrivent donc un opérateur, pas des propriétés certifiées d'un état physique.
-
Factorisation. Chaque estimation sur données réservées repose sur l'hypothèse AFC, que les mesures elles-mêmes ne peuvent pas certifier.
Prochaines étapes
-
Répète l'expérience à la profondeur deux avec les paramètres de l'article pour cette profondeur ( et une dimension de liaison maximale de 8), et détermine combien de réglages de mesure l'algorithme d'apprentissage requiert.
-
Apprends avec la mise à jour à deux sites à la place (
update=:two_sitedanstraining_marginalsetlearn_mpo), qui tronque la dimension de liaison après chaque étape, et observe son comportement avec moins de réglages d'entraînement. -
Apprends sans le prior CRM (
prior=nothing) et compare la fidélité sur données réservées. -
Applique la même analyse aux mesures
ibm_brisbanepubliées par les auteurs. -
Lis le supplément de l'article pour la dérivation de la mise à jour et des estimateurs AFC.
-
Explore d'autres protocoles de mesures aléatoires dans les exemples de
RandomMeas.jl.
Références
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174