Actualiser les propriétés du backend avec un benchmarking en temps réel
Estimation d'utilisation : 3 minutes sur ibm_kingston (REMARQUE : Ceci est une estimation seulement. Ton temps d'exécution peut varier.)
Objectifs d'apprentissage
-
Pourquoi les propriétés rapportées par un QPU peuvent être en retard par rapport au comportement actuel de l'appareil, et quand il vaut la peine de les remesurer toi-même
-
Ce que mesure chacune des cinq expériences de caractérisation standard (lecture, benchmarking randomisé à un qubit, benchmarking randomisé à deux qubits en couches, , et )
-
Comment exécuter la suite de caractérisation complète en un seul appel ou étape par étape, et récupérer un objet backend avec des propriétés actualisées
-
Comment comparer les propriétés mesurées avec celles rapportées, et pourquoi certaines différences reflètent la méthodologie de mesure plutôt qu'une dérive de l'appareil
Prérequis
-
Le flux de travail Qiskit patterns
-
Modes d'exécution Qiskit Runtime, en particulier le batch mode
-
Comment explorer les informations QPU, telles que les propriétés du backend et les données de calibration
Contexte
Chaque QPU IBM Quantum® rapporte un ensemble de propriétés qui décrivent le fonctionnement actuel de chacun de ses qubits : temps de relaxation (), temps de cohérence (), erreurs de lecture, et erreurs de porte à un et deux qubits. Ces chiffres comptent en pratique. Le transpileur les utilise pour décider sur quels qubits physiques ton circuit doit s'exécuter, les techniques d'atténuation des erreurs s'appuient sur eux, et tu pourrais les utiliser pour juger si un appareil fonctionne suffisamment bien pour une expérience.
Les propriétés rapportées proviennent de procédures de calibration qui s'exécutent généralement environ une fois par jour. Les qubits supraconducteurs, cependant, peuvent dériver sur des échelles de temps plus courtes, et des défauts transitoires (appelés systèmes à deux niveaux) peuvent temporairement dégrader un qubit qui semblait excellent au moment de la calibration. De plus, un job est souvent transpilé bien avant son exécution réelle, donc les décisions basées sur les propriétés rapportées peuvent reposer sur des informations obsolètes. Le tutoriel Benchmarking en temps réel pour la sélection de qubits montre à quel point ces propriétés peuvent fluctuer d'un jour à l'autre, et construit manuellement un flux de travail de caractérisation complet à partir d'expériences Qiskit individuelles.
Ce tutoriel montre la version simplifiée de ce flux de travail, en utilisant l'utilitaire BackendCharacterization de Qiskit Device Benchmarking, qui regroupe la construction des expériences, la soumission des jobs et l'ajustement de courbe en quelques appels. Tu dépenses environ 70 secondes de temps QPU et récupères un objet backend dont les propriétés reflètent l'appareil en ce moment même, prêt à être comparé aux valeurs rapportées ou transmis à des outils en aval.
Les expériences de caractérisation
La suite mesure cinq propriétés, chacune avec une expérience standard :
-
Erreur de lecture (
readout) : Chaque qubit est préparé dans ou et immédiatement mesuré. La probabilité de lire le mauvais état donne l'erreur de préparation et de mesure d'état (SPAM). -
Erreur de porte à un qubit (
rb_1q) : Le benchmarking randomisé (RB) exécute des séquences de portes de Clifford à un qubit aléatoires qui se composent idéalement en l'identité. La façon dont la probabilité de survie décroît avec la longueur de séquence donne l'erreur moyenne par porte, indépendamment des erreurs SPAM. -
Erreur de porte à deux qubits (
rb_2q) : La même idée de RB appliquée à des couches complètes de portes à deux qubits sans chevauchement exécutées simultanément, comme dans une expérience de fidélité de couche. Comme de nombreuses portes s'exécutent à la fois, les taux d'erreur résultants incluent des effets de diaphonie et sont plus proches de ce qu'un circuit profond subit réellement. -
(
t1) : Chaque qubit est excité et mesuré après des délais croissants. La décroissance de la population de l'état excité donne le temps de relaxation. -
(
t2) : Une expérience d'écho de Hahn place chaque qubit en superposition, applique une impulsion d'écho à mi-chemin d'un délai, et mesure la vitesse à laquelle la cohérence de phase est perdue. Par défaut, un seul écho est utilisé ; une variante multi-écho (de type CPMG) est présentée à la fin de ce tutoriel.
Ce que l'actualisation fait et ne fait pas
Garde trois points à l'esprit lors de l'utilisation de ce flux de travail :
-
Les propriétés actualisées ne vivent que dans l'objet backend qui t'est retourné. Rien ne change sur l'appareil lui-même ni dans les données de calibration qu'IBM Quantum rapporte aux autres utilisateurs.
-
Les valeurs mesurées sont un instantané pris avec une méthodologie particulière. Certaines d'entre elles, notamment les erreurs à deux qubits en couches et les valeurs à écho unique en parallèle, sont mesurées différemment des données de calibration rapportées, donc une partie de tout écart que tu observes est méthodologique plutôt que dérive. Ce tutoriel signale où cela se produit.
-
La caractérisation elle-même coûte du temps QPU (environ 70 secondes pour la suite complète sur un processeur Heron r2), ce qui est le prix d'une information à jour.
Le flux de travail suit les quatre étapes d'un motif Qiskit :
-
Étape 1 : Associer les entrées classiques à un problème quantique. Choisis l'appareil et l'ensemble de propriétés à mesurer.
-
Étape 2 : Optimiser le problème pour l'exécution sur matériel quantique. L'utilitaire construit les circuits d'expérience directement dans les portes natives de l'appareil et les parallélise sur la puce.
-
Étape 3 : Exécuter à l'aide des primitives Qiskit. Les expériences s'exécutent en tant que jobs Sampler dans un batch.
-
Étape 4 : Post-traiter et retourner le résultat au format classique souhaité. Ajuste les données de mesure en cartes d'erreur par qubit, actualise le backend, et compare les propriétés mesurées avec celles rapportées.
Prérequis techniques
Avant de commencer ce tutoriel, assure-toi d'avoir installé les éléments suivants :
-
Qiskit SDK v2.0 ou ultérieur, avec la prise en charge de visualization
-
Qiskit Runtime v0.40 ou ultérieur (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, qui installe également Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Configuration
Importe les bibliothèques requises.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
La suite de caractérisation construit plusieurs expériences, soumet plusieurs jobs, et ajuste les résultats, ce qui peut prendre au total quelques minutes. Active la journalisation de niveau INFO afin que chaque étape affiche sa progression au fur et à mesure.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Exemple à petite échelle avec simulateur
Ce tutoriel n'inclut pas d'exemple de simulateur. Le flux de travail mesure les imperfections physiques d'un appareil spécifique : la vitesse à laquelle ses qubits se relâchent et se déphasent, et la fréquence à laquelle ses portes et sa lecture échouent. Un simulateur idéal n'a aucune de ces imperfections, donc il n'y a rien à caractériser. Tu pourrais attacher un modèle de bruit synthétique à un faux backend, mais les expériences ne récupéreraient alors que les chiffres que tu as toi-même introduits. Pour cette raison, nous passons directement au matériel, découpé en quatre étapes d'un motif Qiskit.
Exemple à grande échelle sur matériel
Étape 1 : Associer les entrées classiques à un problème quantique
Dans ce flux de travail, le « problème » est l'appareil lui-même : les entrées classiques sont le QPU que tu veux caractériser et la liste des propriétés à mesurer, et les expériences quantiques sont les circuits de caractérisation générés à partir de celles-ci.
Tout d'abord, sélectionne un backend. Ce tutoriel utilise ibm_kingston, un processeur Heron r2 à 156 qubits ; tu peux substituer n'importe quel appareil IBM Quantum auquel tu as accès (ou en choisir un avec service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Ensuite, choisis quelles propriétés mesurer. Tu peux passer n'importe quel sous-ensemble des expériences suivantes :
-
readout: expérience SPAM (préparation et mesure d'état) -
rb_1q: benchmarking randomisé à un qubit isolé -
rb_2q: benchmarking randomisé à deux qubits simultané issu d'une expérience de fidélité de couche -
t2: expérience d'écho de Hahn (un seul écho par défaut) -
t1: expérience de relaxation
Exécute la suite complète pour obtenir une image complète de l'appareil ; supprime des entrées de la liste si tu ne t'intéresses qu'à certaines propriétés et souhaites économiser du temps QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Étape 2 : Optimiser le problème pour l'exécution sur matériel quantique
Dans la plupart des tutoriels, c'est ici que tu transpilerais tes circuits. Ici, BackendCharacterization s'en charge en interne. Il construit les circuits d'expérience directement dans les portes natives de l'appareil, exécute les expériences à un qubit sur tous les qubits en parallèle, et planifie le benchmarking à deux qubits sur des couches disjointes de la carte de couplage afin que l'appareil entier soit couvert avec une poignée de jobs. Grâce à cette parallélisation, la suite entière ne consomme qu'environ 70 secondes de temps QPU.
Initialise la classe qui gère le flux de travail :
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Étape 3 : Exécuter à l'aide des primitives Qiskit
La méthode run_experiments construit les circuits et les soumet en tant que jobs Sampler. Exécute-la dans un contexte Batch afin que les jobs soient planifiés ensemble sur le QPU, et la méthode retourne une fois que tous les jobs ont été soumis. (Tu peux aussi l'exécuter en dehors d'un batch, ou dans une Session.)
Tu pourrais voir un avertissement concernant un Backend transmis alors qu'un gestionnaire de contexte de session est ouvert. C'est normal et peut être ignoré sans risque.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
La méthode renvoie les jobs soumis sous forme de dictionnaire indexé par expérience, ce qui est utile pour les suivre sur le tableau de bord IBM Quantum Platform ou pour le débogage.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Étape 4 : post-traitement et renvoi du résultat au format classique souhaité
Analyser les résultats
La méthode analyze_results attend la fin des jobs et ajuste les données de mesure : décroissances exponentielles pour et , décroissances de probabilité de survie pour les expériences RB, et matrices d'affectation pour la lecture. Elle renvoie un dictionnaire de cartes d'erreur, une entrée par propriété mesurée, chacune associant un qubit (ou une paire de qubits) à sa valeur mesurée.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Les cartes couvrent l'erreur de lecture, les erreurs des portes x et sx à un qubit, les erreurs à deux qubits en couches (lf_error_map, issues de l'expérience de fidélité de couche), ainsi que les temps et en secondes.
Mettre à jour les propriétés du backend
La méthode update_backend écrit les valeurs mesurées dans les propriétés d'une copie du backend et la renvoie. L'objet backend d'origine conserve les données de calibration rapportées, afin que l'on puisse comparer les deux, comme montré ci-dessous. Rappelle-toi que cette mise à jour est purement locale à ta session Python ; elle ne change rien sur l'appareil ni pour les autres utilisateurs.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Comparer les propriétés mesurées aux propriétés rapportées
Enfin, trace les propriétés mesurées en temps réel par rapport aux valeurs rapportées par le backend. Dans chaque panneau, les qubits (ou paires de qubits) sont triés par valeur mesurée, de sorte que la courbe mesurée est lisse par construction et que la dispersion des valeurs rapportées autour d'elle montre où les deux divergent. Un seul graphique est affiché pour le RB à un qubit, car la même erreur mesurée par porte est attribuée aux portes x et sx. Les limites des axes sont choisies à partir du gros de la distribution afin que quelques valeurs aberrantes extrêmes ne compriment pas les graphiques ; tout point situé hors de la plage est comptabilisé dans une annotation sur le graphique (ou passe ylim pour remplacer les limites).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
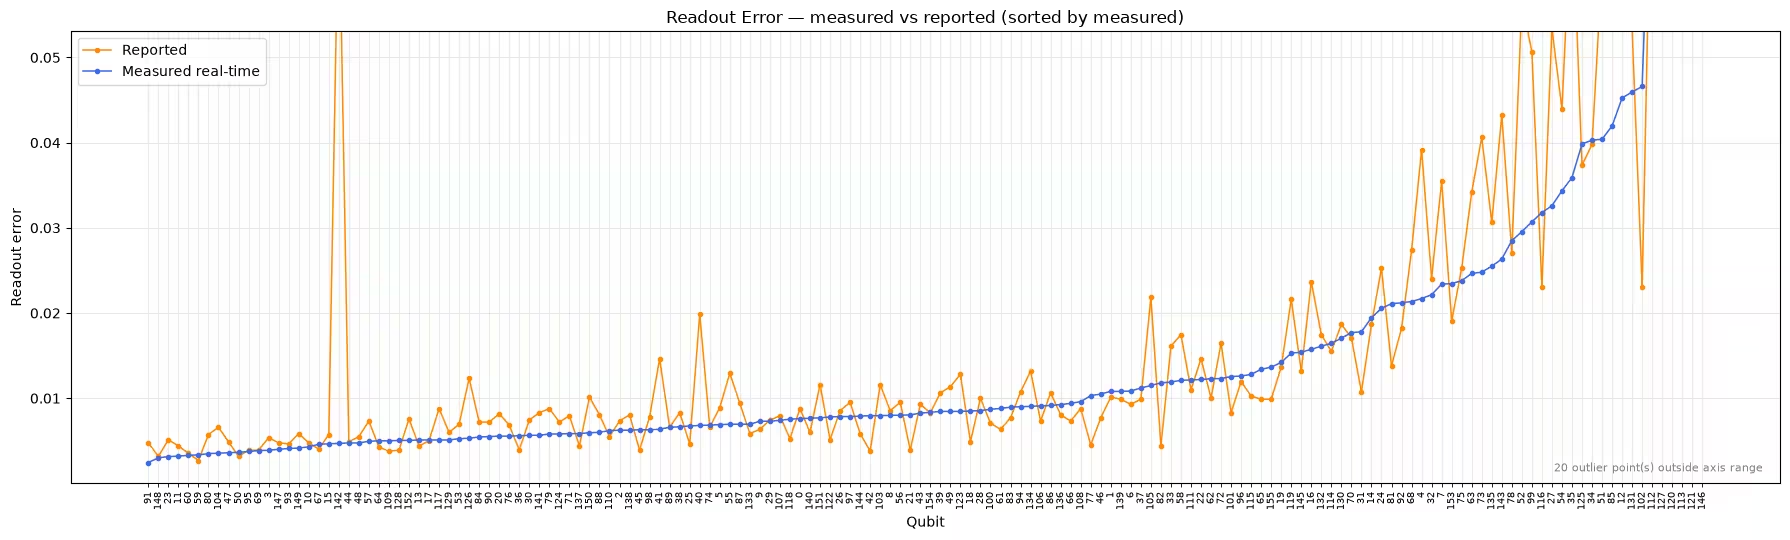
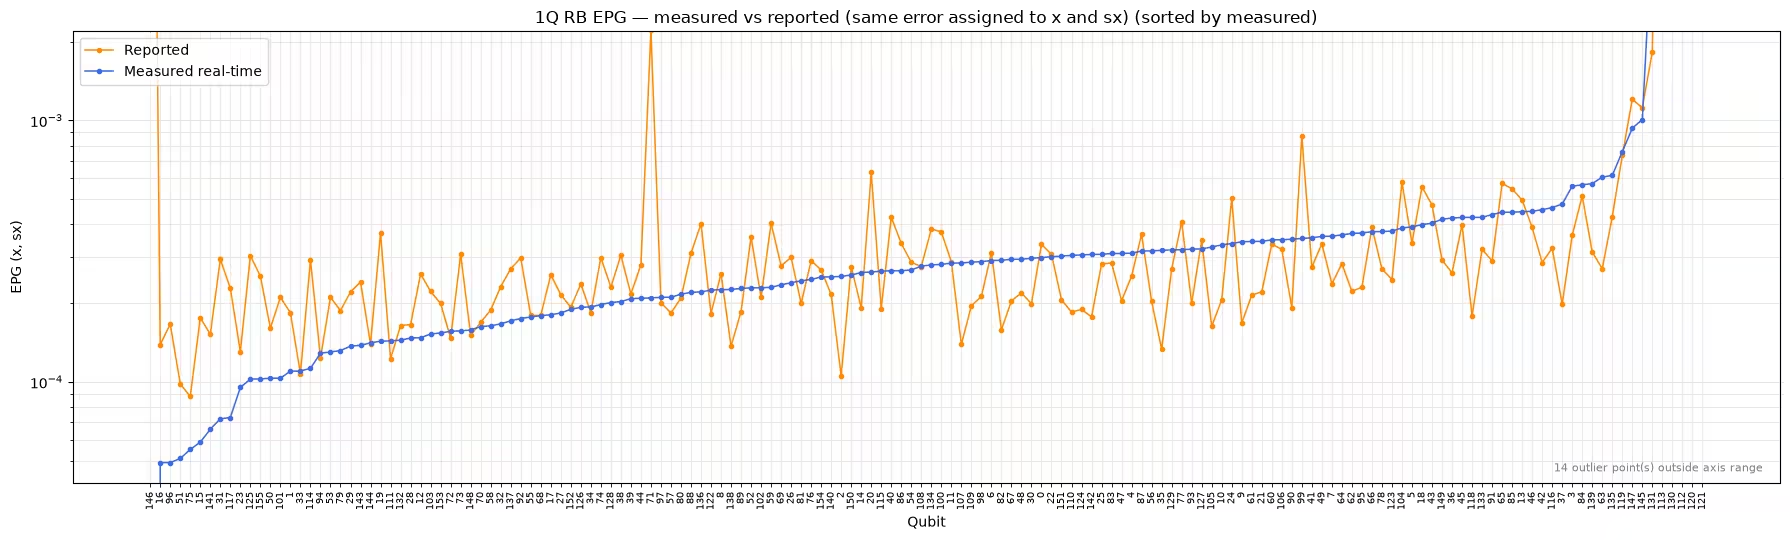
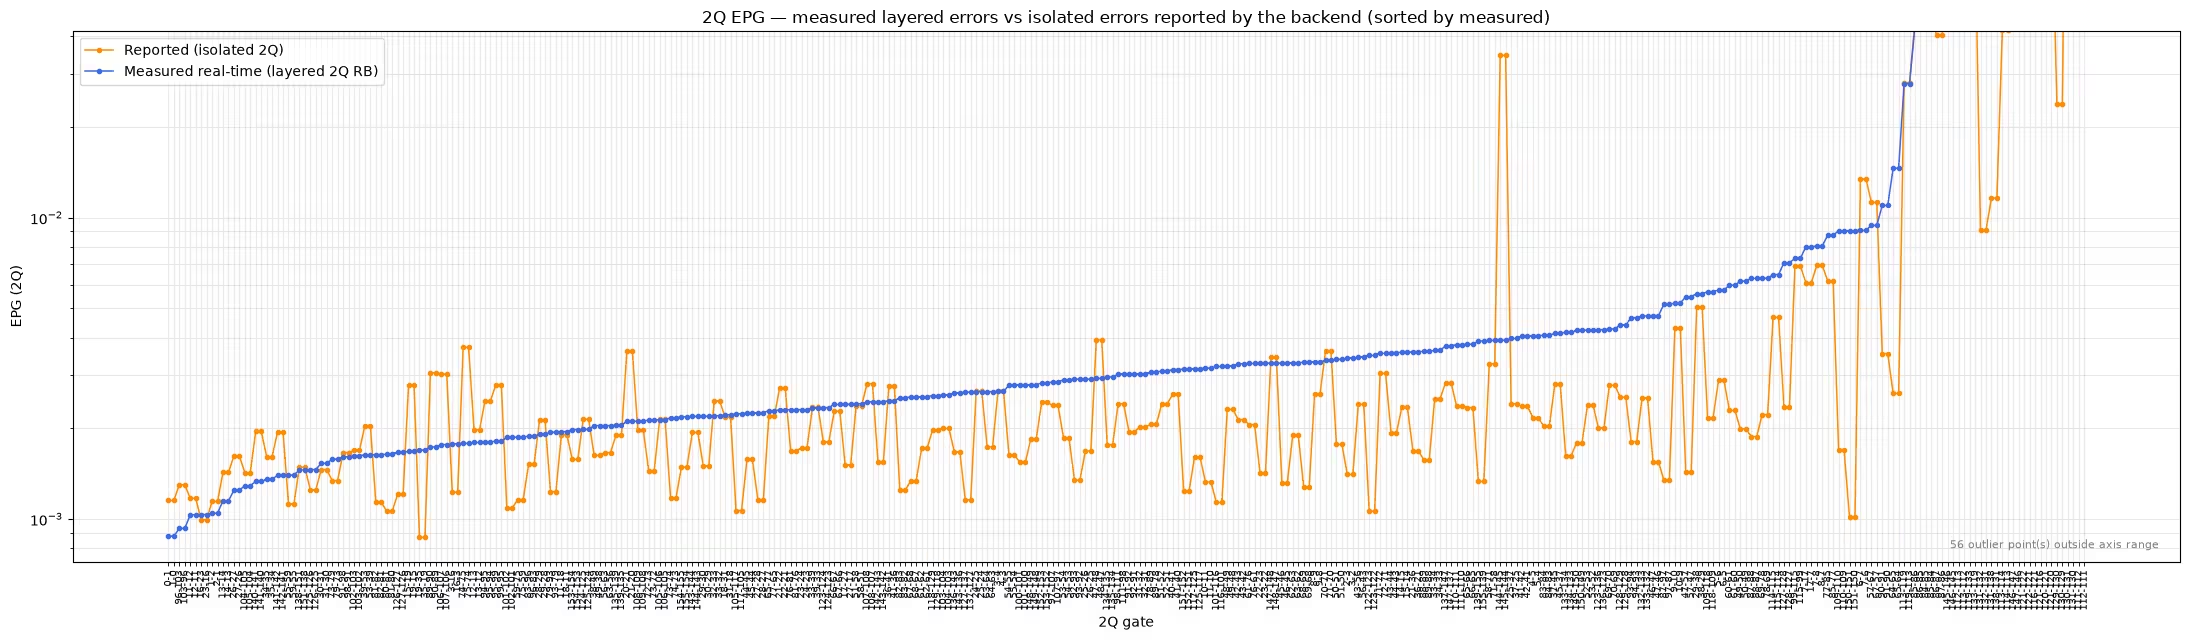
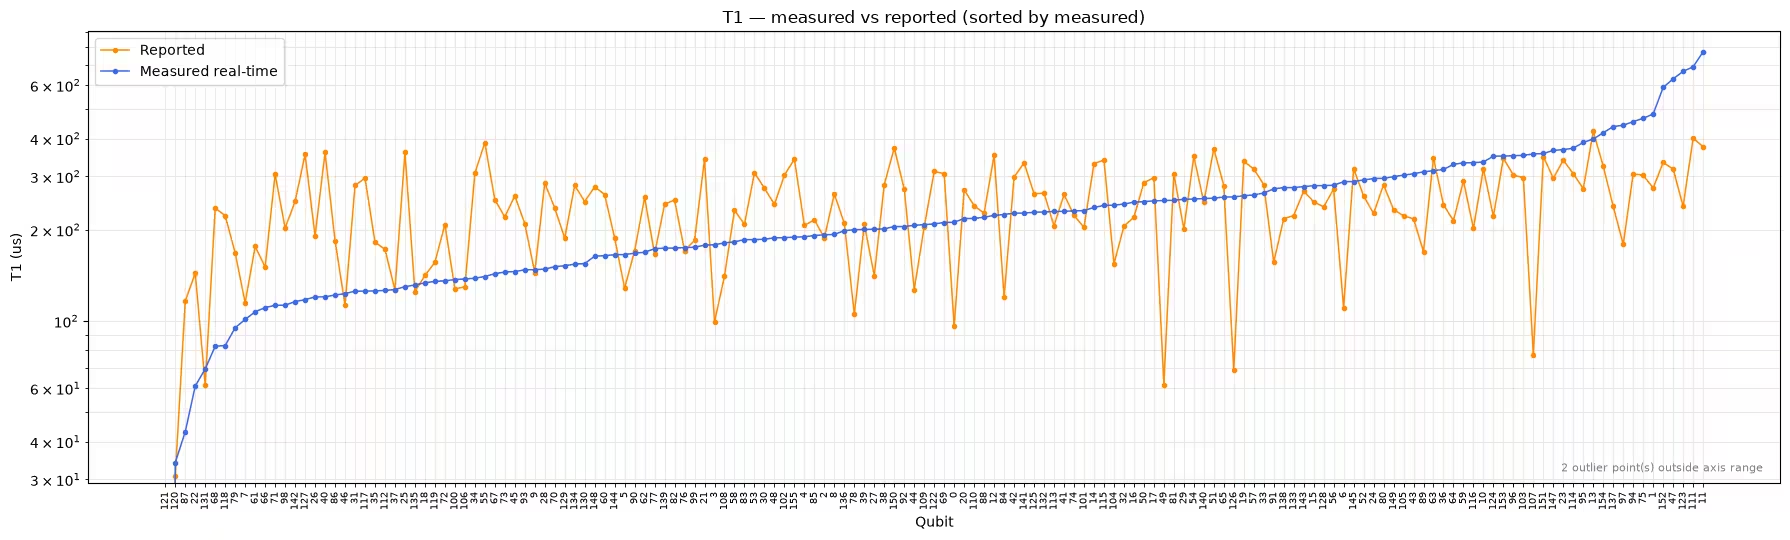
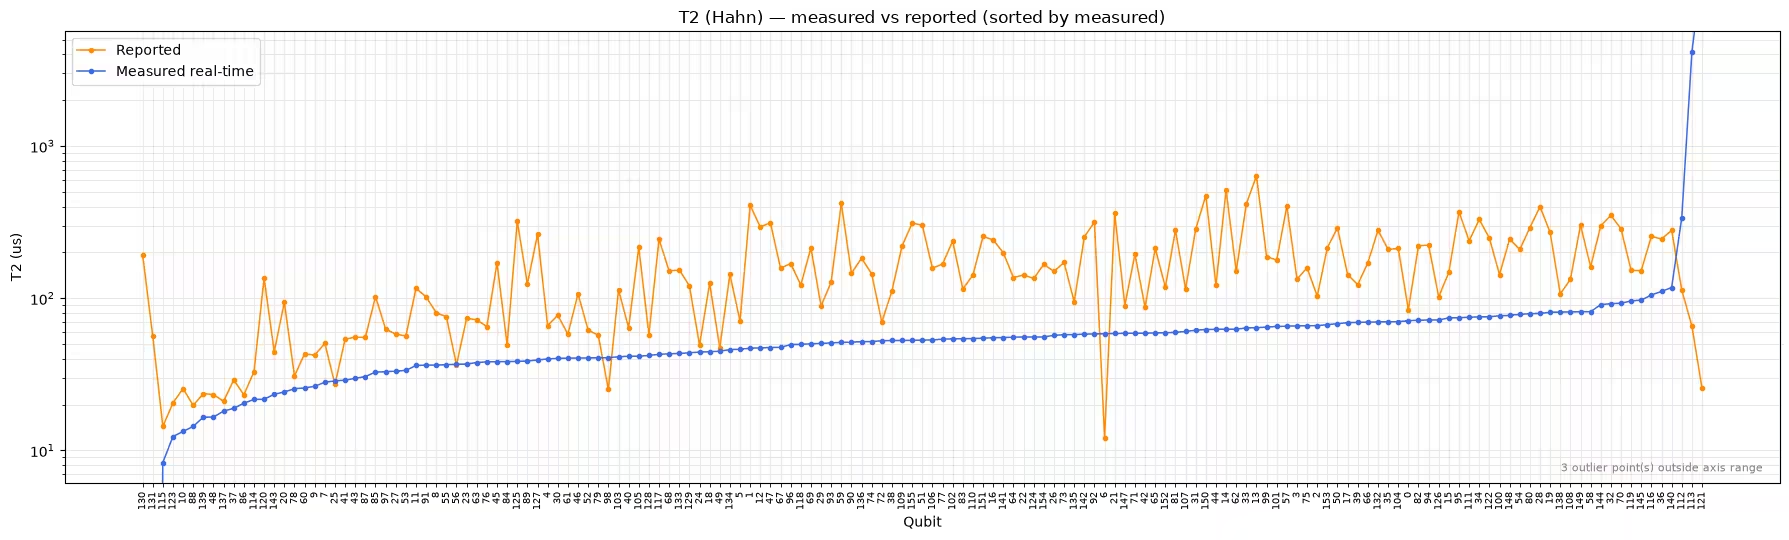
Ces graphiques nécessitent une lecture attentive, car tout écart entre les deux courbes ne signifie pas nécessairement que l'appareil a dérivé :
-
Lecture et erreurs à un qubit : les valeurs mesurées suivent les valeurs rapportées pour la plupart des qubits, tandis que la valeur rapportée pour une poignée de qubits est très éloignée de la courbe mesurée. Ces désaccords localisés constituent la dérive que ce flux de travail est conçu pour détecter.
-
: les deux jeux de données se dispersent l'un autour de l'autre sans décalage systématique, ce qui est cohérent avec une fluctuation naturelle de dans le temps.
-
Erreurs à deux qubits : les valeurs mesurées se situent systématiquement au-dessus des valeurs rapportées. C'est attendu, car les valeurs rapportées sont mesurées sur des portes isolées, tandis que l'expérience de fidélité de couche exécute de nombreuses portes simultanément et inclut donc la diaphonie. Les chiffres en couches sont plus pertinents pour les circuits profonds, mais ne sont pas directement comparables aux données de calibration rapportées.
-
: les valeurs mesurées se situent nettement en dessous des valeurs rapportées pour la plupart des qubits. Là encore, la méthodologie joue un rôle important, comme examiné dans la section suivante.
Inspecter les résultats d'expériences individuelles
Tu peux aussi inspecter les résultats bruts des expériences de caractérisation individuelles via la propriété experiment_data, qui renvoie les objets ExperimentData sous-jacents de Qiskit Experiments. Par exemple, ce qui suit affiche la courbe de décroissance mesurée d'un seul qubit, ce qui est utile pour vérifier la qualité d'un ajustement avant de faire confiance au nombre qu'il a produit.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Mesurer T2 avec un train de découplage dynamique
Par défaut, l'expérience applique un seul écho de Hahn et mesure tous les qubits en parallèle, ce qui, comme l'a montré le graphique de comparaison ci-dessus, peut donner des valeurs de nettement plus basses que celles rapportées par le backend. Une hypothèse est le nombre d'échos : les valeurs rapportées peuvent être calibrées avec un découplage dynamique, qui supprime le bruit basse fréquence. Pour tester cela, exécute une caractérisation seule avec t2_num_echoes fixé à une valeur plus élevée, ce qui applique un train d'impulsions d'écho de type CPMG. Les délais représentent le temps total d'évolution libre dans les deux cas, de sorte que les valeurs de ajustées sont directement comparables aux résultats à écho unique.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
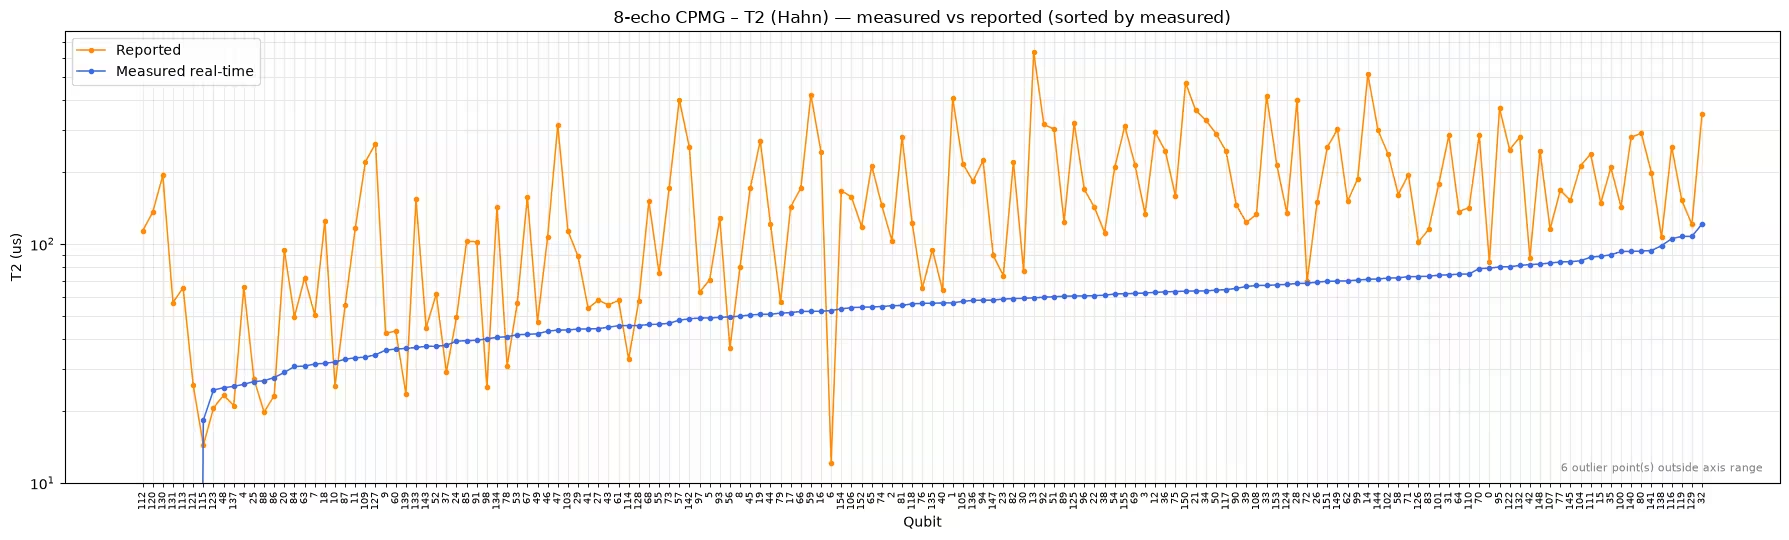
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
Dans cette exécution, les échos supplémentaires ont à peine changé le résultat : la médiane à 8 échos (56 µs) est proche de celle à écho unique (53 µs), et les deux restent bien en dessous de la médiane rapportée (142 µs). Le nombre d'échos seul n'explique pas cet écart ; d'autres différences méthodologiques entrent en jeu, comme les détails de la procédure de calibration, la mesure de tous les qubits en parallèle plutôt qu'isolément, et ainsi de suite.
La leçon pratique est de traiter les comparaisons de (et d'erreur à deux qubits en couches) entre méthodologies avec prudence. Les valeurs actualisées sont un instantané autocohérent pris dans des conditions proches d'une charge de travail réelle, ce qui les rend bien adaptées pour comparer les qubits entre eux ou suivre un appareil dans le temps. Un écart par rapport aux données de calibration rapportées, cependant, n'est pas automatiquement la preuve d'une dérive.
Étapes 1 à 4 condensées en un seul appel
Pour un usage quotidien, tu as rarement besoin des résultats intermédiaires. La méthode run_and_update enchaîne tout ce que tu as fait ci-dessus (construction, soumission, ajustement et mise à jour) en un seul appel qui renvoie le backend rafraîchi. Elle accepte la même liste experiments (et transmet des options comme t2_num_echoes), et peut de même être encapsulée dans un contexte Batch ou Session.
La cellule suivante ne se termine pas tant que tous les jobs et le post-traitement ne sont pas terminés.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
L'objet backend_updated actualisé est maintenant prêt à être utilisé partout où les propriétés du backend alimentent ton flux de travail. Essaie ce processus en combinaison avec le tutoriel Real-time benchmarking for qubit selection pour choisir les qubits les plus performants lors de la transpilation d'un circuit. Comme l'appareil continue de dériver, actualise les propriétés peu avant d'exécuter réellement ta charge de travail.
Prochaines étapes
Si tu as trouvé ce travail intéressant, voici quelques ressources supplémentaires qui pourraient t'intéresser :
- Utilise les propriétés actualisées pour choisir de meilleurs qubits dans le tutoriel Real-time benchmarking for qubit selection
- Découvre comment les données de calibration rapportées sont exposées dans le guide QPU information
- Explore les expériences de caractérisation individuelles dans la documentation Qiskit Experiments
- Parcours d'autres benchmarks au niveau de l'appareil dans le dépôt Qiskit Device Benchmarking