Borner la dimension du sous-espace
Dans ce tutoriel pas à pas, nous allons montrer l'effet de la dimension du sous-espace dans la technique de récupération de configurations auto-cohérente.
A priori, nous ne savons pas quelle est la dimension de sous-espace correcte pour atteindre un niveau de précision cible. Cependant, nous savons qu'augmenter la dimension du sous-espace augmente la précision de la méthode. Nous pouvons donc étudier la précision des prédictions en fonction de la dimension du sous-espace. Spécifie la molécule et ses propriétés.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit_addon_sqd": "qiskit-addon-sqd"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import pyscf
import pyscf.cc
import pyscf.mcscf

warnings.filterwarnings("ignore")

# Specify molecule properties
open_shell = False
spin_sq = 0

# Build N2 molecule
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="6-31g",
    symmetry="Dooh",
)

# Define active space
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
num_orbitals = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
num_elec_a = (n_electrons + mol.spin) // 2
num_elec_b = (n_electrons - mol.spin) // 2
cas = pyscf.mcscf.CASCI(scf, num_orbitals, (num_elec_a, num_elec_b))
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), num_orbitals)

# Compute exact energy
exact_energy = cas.run().e_tot
converged SCF energy = -108.835236570775
CASCI E = -109.046671778080  E(CI) = -32.8155692383188  S^2 = 0.0000000
Génère des chaînes de bits aléatoires pour simuler des échantillons de QPU.
import numpy as np
from qiskit_addon_sqd.counts import generate_bit_array_uniform

# Create a seed to control randomness throughout this workflow
rng = np.random.default_rng(24)

# Generate random samples
bit_array = generate_bit_array_uniform(
    10_000, num_orbitals * 2, rand_seed=rng
)
Appelle SQD avec des tailles de lot croissantes.
from qiskit_addon_sqd.fermion import diagonalize_fermionic_hamiltonian

list_samples_per_batch = [50, 200, 400, 600]

# SQD options
max_iterations = 5

# Eigenstate solver options
num_batches = 10
max_davidson_cycles = 200

energies = []
subspace_dimensions = []

for samples_per_batch in list_samples_per_batch:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        seed=rng,
    )
    energies.append(result.energy)
    subspace_dimensions.append(np.prod(result.sci_state.amplitudes.shape))
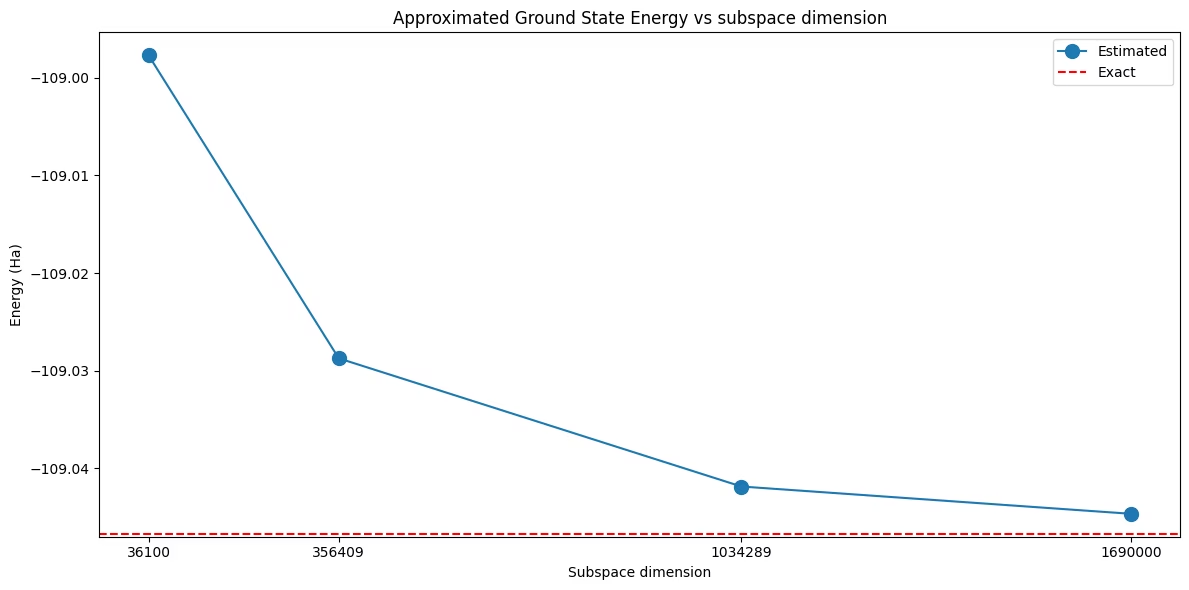
Ce graphique montre qu'augmenter la dimension du sous-espace conduit à des résultats plus précis.
import matplotlib.pyplot as plt

# Data for energies plot
x1 = subspace_dimensions
y1 = np.array(energies) + nuclear_repulsion_energy

fig, axs = plt.subplots(1, 1, figsize=(12, 6))

# Plot energies
axs.plot(x1, y1, marker=".", markersize=20, label="Estimated")
axs.set_xticks(x1)
axs.set_xticklabels(x1)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()
Définir une borne explicite avec max_dim
Dans le balayage ci-dessus, la dimension du sous-espace n'était contrôlée qu'indirectement. samples_per_batch définit le nombre de chaînes de bits tirées dans chaque lot, mais la dimension du sous-espace obtenu est déterminée par le nombre de chaînes distinctes de spin alpha et de spin bêta que contiennent ces chaînes de bits, et le pool de configurations disponibles pour le sous-échantillonnage s'agrandit d'une itération de récupération de configurations à la suivante. C'est pourquoi les dimensions de sous-espace sur l'axe horizontal ci-dessus sont des nombres irréguliers que nous n'avons pas choisis.
L'argument max_dim de diagonalize_fermionic_hamiltonian borne directement la dimension. Il limite le nombre de chaînes CI conservées dans chaque secteur de spin, et comme le sous-espace est engendré par le produit cartésien des deux secteurs, sa dimension est le produit des dimensions des deux secteurs :
-
max_dim=dlimite les deux secteurs àdchaînes, de sorte que la dimension du sous-espace est au plusd ** 2. -
max_dim=(d_a, d_b)limite séparément les secteurs de spin alpha et de spin bêta, de sorte que la dimension du sous-espace est au plusd_a * d_b. Lorsquesymmetrize_spin=True, les deux limites doivent être égales. -
max_dim=None, la valeur par défaut, n'impose aucune limite.
Lorsqu'un lot contient plus de chaînes que la limite ne le permet, les moins importantes sont écartées : les chaînes passées via include_configurations sont conservées en premier, suivies des chaînes reportées de l'itération précédente (voir carryover_threshold), et les emplacements restants sont remplis avec les chaînes échantillonnées, par ordre décroissant de fréquence d'échantillonnage.
Comme max_dim plafonne la taille de la plus grande diagonalisation que le solveur de vecteurs propres devra effectuer, c'est un moyen pratique de garder le solveur dans un budget de temps d'exécution et de mémoire : choisis samples_per_batch généreusement, et laisse max_dim décider jusqu'où le sous-espace peut croître.
Ci-dessous, nous répétons l'étude, cette fois en maintenant samples_per_batch fixe et en augmentant max_dim.
list_max_dim = [100, 200, 400, 800]

# Use a generous number of samples per batch, so that max_dim is what limits
# the dimension of the subspace
samples_per_batch = 600

energies_max_dim = []
subspace_dimensions_max_dim = []

for max_dim in list_max_dim:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        max_dim=max_dim,
        seed=rng,
    )
    energies_max_dim.append(result.energy)
    subspace_dimensions_max_dim.append(
        int(np.prod(result.sci_state.amplitudes.shape))
    )

print(f"max_dim:            {list_max_dim}")
print(f"subspace dimension: {subspace_dimensions_max_dim}")
max_dim:            [100, 200, 400, 800]
subspace dimension: [10000, 40000, 160000, 640000]
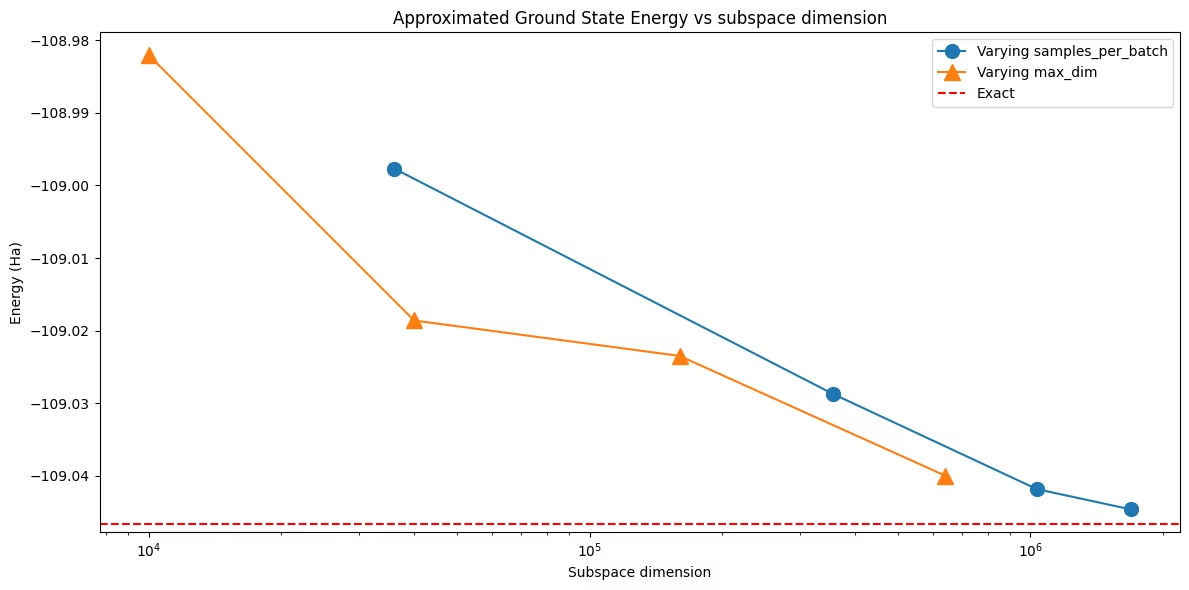
La dimension du sous-espace est maintenant exactement max_dim ** 2 dans chaque exécution : elle a été choisie plutôt que découverte. Tracer les deux balayages ensemble montre que la précision est gouvernée par la dimension du sous-espace elle-même, quel que soit l'argument utilisé pour y arriver. Les deux courbes ne coïncident pas nécessairement exactement, cependant. Les exécutions avec max_dim tirent 600 chaînes de bits par lot puis conservent les chaînes les plus fréquemment échantillonnées ; à dimension donnée, elles peuvent donc retenir un meilleur ensemble de configurations qu'une exécution qui a atteint cette dimension en échantillonnant d'emblée moins de chaînes de bits.
fig, axs = plt.subplots(1, 1, figsize=(12, 6))

axs.plot(
    subspace_dimensions,
    np.array(energies) + nuclear_repulsion_energy,
    marker=".",
    markersize=20,
    label="Varying samples_per_batch",
)
axs.plot(
    subspace_dimensions_max_dim,
    np.array(energies_max_dim) + nuclear_repulsion_energy,
    marker="^",
    markersize=12,
    label="Varying max_dim",
)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_xscale("log")
axs.ticklabel_format(axis="y", useOffset=False)
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()