Parity Twine Optimizer : une fonction Qiskit par ParityQC
Consulte la référence API
Les Qiskit Functions sont une fonctionnalité expérimentale disponible uniquement pour les utilisateurs des offres Premium, Flex et On-Prem (via l'API IBM Quantum Platform) d'IBM Quantum®. Elles sont en statut de version préliminaire et sont susceptibles d'être modifiées.
Aperçu
Le Parity Twine Optimizer permet aux utilisateurs de résoudre des problèmes d'optimisation avec des ordinateurs quantiques à l'aide de la méthode Parity Twine. Cette approche, construite sur la Parity Architecture, utilise le compilateur ParityQC pour minimiser le nombre de portes et la profondeur de circuit nécessaires à l'exécution d'un algorithme quantique, tout en tenant compte de la connectivité du dispositif.
Cette réduction des ressources permet de résoudre des problèmes d'optimisation pertinents pour l'industrie à des tailles irréalisables avec les méthodes de transpilation standard, riches en portes SWAP. Le Parity Twine Optimizer automatise les étapes de transpilation et peut être utilisé avec une intervention minimale de l'utilisateur.
L'approche Parity Twine surpasse toutes les autres méthodes de compilation en matière de réduction du nombre de portes et de la profondeur de circuit pour des algorithmes quantiques tels que l'algorithme d'optimisation approximative quantique (QAOA) et la transformée de Fourier quantique (QFT). En abstrayant l'information quantique des qubits physiques, les interactions non locales sont mises en œuvre sans portes SWAP. À la place, les chaînes Parity Twine (séquences de portes CNOT) distribuent systématiquement l'information de parité logique entre les qubits.
L'optimiseur utilise le QAOA pour minimiser l'énergie d'une fonction de coût donnée. Le QAOA est un algorithme variationnel hybride quantique-classique conçu pour résoudre des problèmes d'optimisation combinatoire en approximant l'état fondamental d'un hamiltonien de coût (). Un terme de mélange () entraîne des transitions entre états afin d'explorer l'espace des solutions. Une séquence alternée de ces termes, contrôlée par les paramètres et , définit l'unitaire , qui agit sur l'état initial.
L'encodage de l'unitaire du problème, exp(), nécessite l'encodage de tous les opérateurs de rotation logiques à corps (exp()). Cela peut être accompli à l'aide de générateurs à corps (Parity Twine Networks), qui réduisent la profondeur du circuit QAOA et le nombre de portes à deux qubits.
Description
L'entrée du Parity Twine Optimizer se compose d'un problème d'optimisation, du nom du matériel IBM Quantum choisi, et d'arguments optionnels supplémentaires pour adapter les paramètres de transpilation et d'exécution matérielle. La fonction d'optimisation transmet la définition du problème au Parity Twine Compiler. La figure 1 présente un résumé du flux de travail de la fonction.
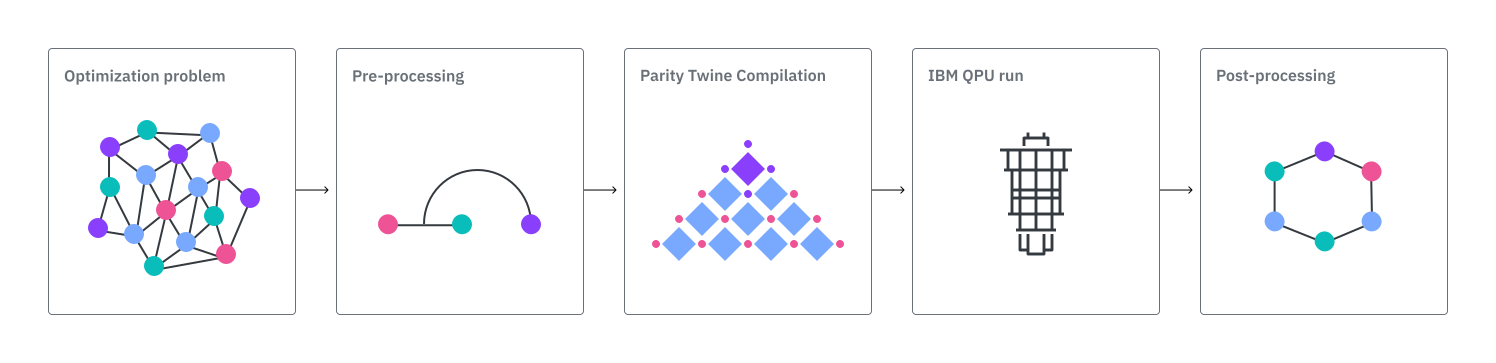
Le problème d'optimisation d'entrée est prétraité en un hamiltonien (normalisé). Le compilateur ParityQC construit ensuite un circuit ansatz Parity Twine paramétré, qui est transpilé en un ansatz logique correspondant au jeu de portes natif du matériel choisi.
Les paramètres du circuit QAOA sont optimisés de manière classique à l'aide de l'approche "efficient depth one" et assignés au circuit transpilé. Comme un seul tour de QAOA est utilisé, les paramètres optimaux et sont obtenus par recherche en grille (grid search) sur un CPU, sans nécessiter d'optimisation itérative coûteuse sur de nombreux appels de circuit. Cela minimise considérablement le temps d'exécution QPU requis par l'optimiseur. Le temps d'exécution par circuit est principalement déterminé par le surcoût constant lié à l'exécution d'un job sur le QPU. Une fois les paramètres du circuit définis, le job est soumis au QPU IBM® spécifié.
Les résultats bruts sont ensuite post-traités. Cette étape utilise une recherche gloutonne locale qui parcourt aléatoirement la chaîne de solution et inverse les valeurs de bits si cela réduit la valeur de la fonction de coût.
Benchmarks
La performance peut dépendre à la fois de l'instance du problème et des étapes de traitement ultérieures. Dans certains cas, les échantillons classiques et les échantillons générés par voie quantique peuvent atteindre une qualité de solution finale similaire après un post-traitement équivalent. L'évaluation doit donc prendre en compte le workflow d'optimisation complet.
Modèle de Sherrington-Kirkpatrick
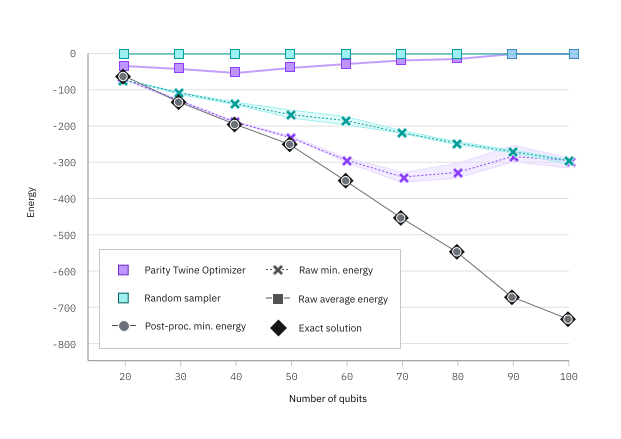
La figure 2 démontre l'efficacité du Parity Twine Optimizer. Elle compare les résultats obtenus avec l'optimiseur à un échantillonnage aléatoire pour le modèle de Sherrington-Kirkpatrick avec un nombre croissant de qubits.
Après post-traitement, les résultats aléatoires comme ceux de l'optimiseur aboutissent à des états fondamentaux exacts, mais la sortie brute d'énergie minimale du QAOA Twine est toujours meilleure que les valeurs aléatoires. Pour les plus grands nombres de qubits considérés (90 et 100), le bruit du matériel dégrade le résultat de l'optimiseur, qui revient alors à des valeurs brutes correspondant à l'échantillonnage aléatoire.
Consulte ce tutoriel pour une introduction au modèle de Sherrington-Kirkpatrick et des détails sur la façon de le résoudre avec le Parity Twine Optimizer.
Problème Market Split
Le tableau 1 présente des métriques de performance spécifiques pour le Parity Twine Optimizer appliqué à diverses instances du problème Market Split (MS). Celles-ci ont été obtenues à partir de la QOBLIB - Quantum Optimization Benchmarking Library et correspondent à des soumissions faites à la bibliothèque à l'aide du Parity Twine Optimizer.
La violation MS est une métrique de précision qui mesure à quel point la solution est éloignée de la satisfaction de toutes les contraintes, définie comme . Des valeurs plus faibles de cette métrique indiquent des solutions plus précises.
Le tableau 1 présente les valeurs moyennées pour cinq exécutions de chaque instance à l'aide du Parity Twine Optimizer avec le dispositif ibm_boston comme backend et 100 000 shots.
La violation MS minimale obtenue parmi les exécutions de chaque instance est indiquée.
| Instance | Qubits | Portes à deux qubits | Profondeur à deux qubits | Violation MS | Temps de mapping (s) | Temps d'exécution QPU (s) | Temps de post-traitement (s) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
Tableau 1 : métriques de performance pour différentes instances du problème Market Split. Les noms d'instances correspondent aux exemples de la bibliothèque de problèmes QOBLIB. Comme mentionné précédemment dans la section Description, le temps QPU est minimal et presque constant, car un seul tour de QAOA est utilisé avec des paramètres de circuit optimaux obtenus sur un CPU.
Consulte ce tutoriel pour une introduction au problème Market Split et des détails sur la façon de le résoudre avec le Parity Twine Optimizer.
Problème du Maximum Independent Set
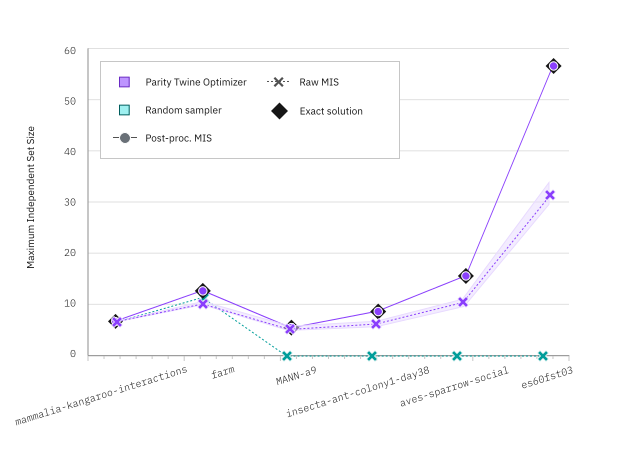
La figure 3 compare les résultats obtenus avec l'optimiseur Parity Twine à un échantillonnage aléatoire pour le problème du maximum independent set, pour des instances sélectionnées provenant de la QOBLIB - Quantum Optimization Benchmarking Library. Celles-ci vont de 18 (mammalia-kangaroo-interactions) à 114 (es60fst03) qubits.
Pour les petites instances, les résultats bruts de taille du Maximum Independent Set issus de l'optimiseur et de l'échantillonnage aléatoire sont similaires, mais pour les instances plus grandes, l'optimiseur donne des résultats bien meilleurs. Le post-traitement des résultats issus de l'échantillonnage aléatoire et de l'optimiseur conduit à nouveau à des tailles d'ensembles en accord avec les valeurs exactes.
Prise en main
Authentifie-toi à l'aide de ton jeton API IBM Quantum Platform et sélectionne la fonction Qiskit comme suit :
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
Exemple
Le Parity Twine Optimizer peut être appliqué à un exemple QUBO simple comme suit. Le problème est d'abord défini à l'aide d'un dictionnaire :
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
Ensuite, le type de variable doit être défini comme binary ou spin :
variable_type = "spin"
Cela définit la fonction objectif où .
Choisis un backend. Par exemple :
backend_name = "ibm_phoenix"
Utilise catalog.backends() pour voir la liste des backends disponibles pour le compte/l'instance utilisateur.
Si aucun backend n'est spécifié, le backend le moins occupé (celui ayant le moins de jobs en attente) est automatiquement sélectionné.
Une fois l'optimiseur chargé (voir précédemment), tu peux l'exécuter sur le problème en utilisant les options par défaut :
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
Vérifie le statut du job comme suit :
# Monitor the job status
function_job.status()
Récupère les résultats comme suit :
# Retrieve the job result if the status is DONE
result = function_job.result()

result
L'affichage des résultats donne ce qui suit :
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
Le dictionnaire solution correspond aux qubits définis dans le problème ( et ) et donne leurs valeurs de spin optimisées.
La valeur objective_value est le coût ou l'énergie du problème d'optimisation. Elle quantifie la qualité de la solution.
metadata fournit des informations sur la transpilation (nombre/profondeur de portes à deux qubits, portes utilisées, qubits actifs) ainsi que divers temps d'exécution, tant pour le calcul quantique que classique.
De plus, metadata donne un aperçu du fonctionnement interne de l'algorithme. Tu peux voir les paramètres variationnels optimisés (beta et gamma) et examiner comment la distribution des bitstrings mesurés s'est améliorée après l'application du post-traitement classique aux résultats quantiques bruts.
Tous les bitstrings de la sortie de résultat peuvent être associés aux variables du problème à l'aide de variable_mapping.
Par exemple, tu peux associer 'solution_bitstring': '100' avec 'variable_mapping': {'0': 0, '1': 1, '2': 2} à la solution binaire : {'0': 1, '1': 0, '2': 0}.
Comme tu résous le problème en termes de variables de spin, tu dois appliquer la transformation binaire vers spin (0 -> 1, 1 -> -1).
Tu arrives alors à la solution finale 'solution': {'0': -1, '1': 1, '2': 1}.
Consulte la référence API pour tous les détails sur les entrées et sorties de la fonction Parity Twine Optimizer.
Journal des modifications
[1.0.2] - 2026-09-15
Notes
Cette version marque la première version stable de production de la fonction Qiskit Parity Twine Optimizer. Les prochaines versions devraient introduire les éléments suivants :
- la compilation de problèmes d'ordre supérieur,
- des algorithmes d'optimisation supplémentaires, et
- des améliorations du pré- et post-traitement.
Fonctionnalités
- Résous des problèmes QUBO creux et denses avec le Parity Twine Compiler efficace.
Documentation
- Guide utilisateur de prise en main.
- Tutoriels avec des exemples pour les problèmes Market Split et Sherrington-Kirkpatrick.
- Documentation API.
Obtenir de l'aide
Contacte ParityQC pour toute question ou tout problème.
Prochaines étapes
- Demande l'accès à la fonction en remplissant ce formulaire.
- Consulte la référence API pour cette fonction Qiskit.
- Essaie le tutoriel pour appliquer le Parity Twine Optimizer au problème Market Split.
- Essaie le tutoriel pour appliquer le Parity Twine Optimizer au modèle de Sherrington-Kirkpatrick.
- Consulte le préprint ArXiv Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025).