Rimay Quantum Feature Extraction - une Qiskit Function de Kipu Quantum
Consulte la référence de l'API.
Les Qiskit Functions sont une fonctionnalité expérimentale disponible uniquement pour les utilisateurs des offres IBM Quantum® Premium Plan, Flex Plan et On-Prem (via l'API IBM Quantum Platform). Elles sont en préversion et susceptibles de changer.
Vue d'ensemble
Rimay enrichit les pipelines classiques de machine learning avec des caractéristiques générées sur du matériel quantique. La fonction prend des données tabulaires classiques et renvoie un ensemble de caractéristiques transformées par le quantique. Lorsqu'un système quantique traite les données, il génère des caractéristiques riches qui capturent les relations non linéaires entre les entrées. Tu peux utiliser les caractéristiques générées seules, ou combinées à tes caractéristiques d'origine, pour entraîner n'importe quel modèle classique. Sur des jeux de données de petite et moyenne taille, les caractéristiques transformées par le quantique peuvent améliorer la qualité des prédictions par rapport à des références purement classiques.
Cette fonction est conçue pour les utilisateurs suivants :
-
Les équipes de data science disposant d'un pipeline de machine learning existant sur des jeux de données tabulaires de petite et moyenne taille, dont la qualité de prédiction a atteint un plateau. Tu ajoutes Rimay comme une étape de prétraitement supplémentaire, sans construire toi-même de circuits quantiques.
-
Les chercheurs qui explorent les méthodes quantiques pour des tâches de machine learning.
Description
L'algorithme d'extraction de caractéristiques quantiques [1] combine deux principes du machine learning quantique. Le premier est celui des feature maps quantiques, qui plongent les données dans un espace de Hilbert de grande dimension et produisent donc des représentations plus expressives. Le second est le reservoir computing quantique, qui utilise la dynamique d'un système quantique à plusieurs corps comme transformation non linéaire de l'entrée.
Rimay encode les valeurs des caractéristiques et l'information mutuelle entre les caractéristiques dans les champs locaux et les coefficients de couplage d'un hamiltonien de verre de spin. Une dynamique quantique contre-diabatique fait évoluer le système vers ses états de basse énergie, qui contiennent des mélanges non linéaires des corrélations des données d'entrée. Rimay extrait ces corrélations en mesurant des valeurs moyennes à un et deux corps. Ces valeurs moyennes sont les caractéristiques transformées par le quantique que tu fournis à ton modèle de machine learning.
Workflow
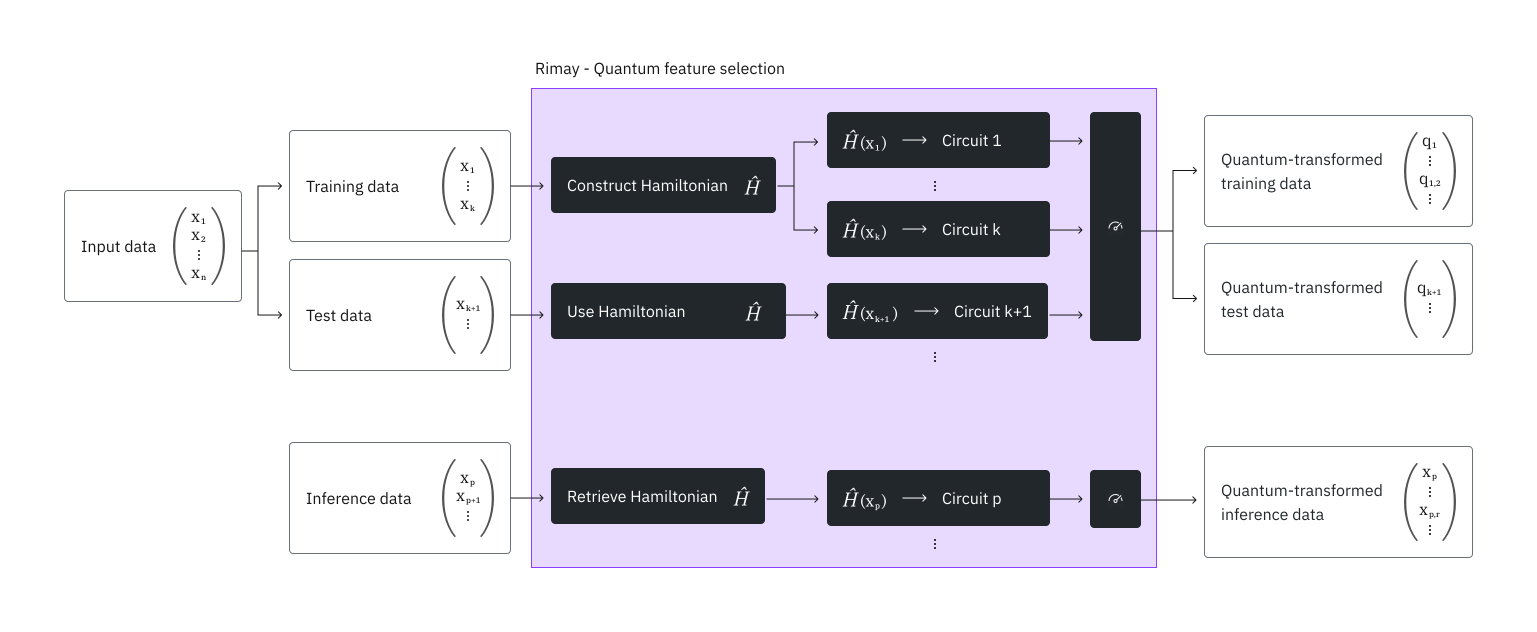
-
Prétraite tes données tabulaires comme pour du machine learning classique. Rimay a besoin de caractéristiques numériques : convertis donc les caractéristiques catégorielles en caractéristiques numériques, par exemple avec
OneHotEncoderde scikit-learn. -
Sépare les données en un jeu d'entraînement et un jeu de test, puis téléverse les deux vers la fonction, comme indiqué dans la section Exemple.
-
Rimay utilise les données d'entraînement pour construire l'hamiltonien qui représente les données. Chaque caractéristique correspond à un qubit, et l'ensemble du jeu d'entraînement détermine quelles caractéristiques, et donc quels qubits, interagissent. Rimay conserve cette structure afin de projeter les données de test et les données d'inférence ultérieures avec le même hamiltonien.
-
Pour chaque échantillon, les valeurs des caractéristiques fixent les champs locaux de l'hamiltonien, et l'information mutuelle entre les caractéristiques fixe les coefficients de couplage de la structure de l'étape 3. Rimay numérise l'évolution contre-diabatique de cet hamiltonien en un circuit, et exécute les circuits sur le QPU.
-
Rimay mesure les chaînes de bits obtenues, puis calcule les valeurs moyennes à un corps et les valeurs moyennes à deux corps des qubits physiquement couplés.
-
Tu télécharges les valeurs moyennes sous une forme que tu peux fournir directement à ton modèle, ou combiner avec tes caractéristiques d'origine.
À cause de cette structure, le nombre de qubits dont une exécution a besoin est égal au nombre de caractéristiques, et le nombre de circuits qu'elle soumet est égal au nombre d'échantillons.
Après avoir ajusté un mapping, tu peux y projeter de nouvelles données, par exemple pour l'inférence. Rimay récupère alors l'hamiltonien qu'il a créé pendant l'ajustement et construit à partir de lui les circuits pour les nouveaux échantillons.
Intégrer Rimay dans ton pipeline de machine learning
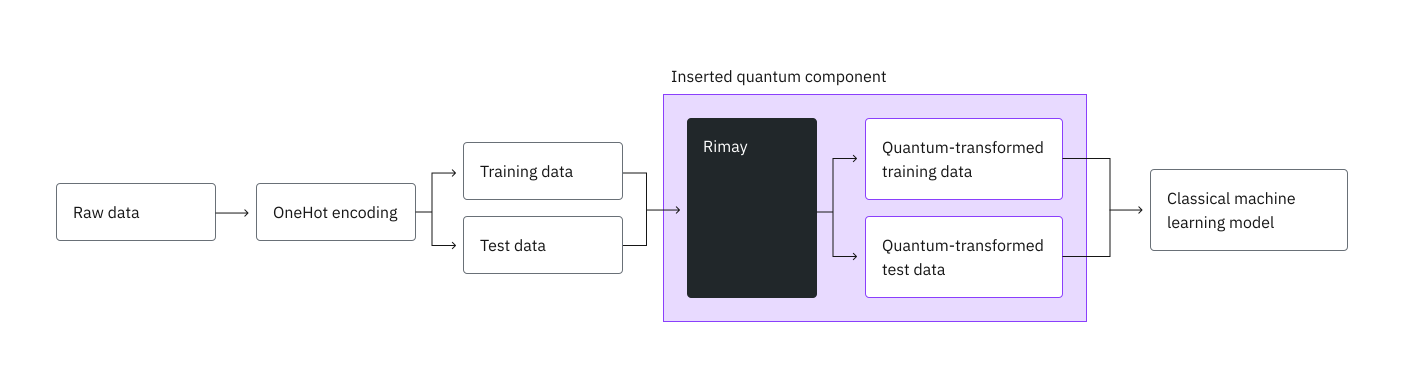
Comme dans un pipeline classique, tu commences par prétraiter les données brutes, par exemple en encodant en one-hot les caractéristiques catégorielles, puis tu les sépares en un jeu d'entraînement et un jeu de test. Au lieu de fournir directement les deux jeux à ton modèle, tu les fournis d'abord à Rimay, puis tu entraînes ton modèle sur les caractéristiques transformées par le quantique.
Benchmarks
Kipu Quantum a évalué Rimay sur le jeu de données German credit d'OpenML [2], qui classe 1000 demandeurs de crédit comme bons ou mauvais risques de crédit. Il comporte 13 attributs catégoriels et sept attributs numériques. L'encodage one-hot des attributs catégoriels donne 48 caractéristiques numériques. Le benchmark met de côté 20 % des échantillons comme jeu de test.
Comme référence, plusieurs modèles classiques ont été entraînés sur les caractéristiques classiques. Avec Rimay, une forêt aléatoire a été entraînée de deux façons : sur les caractéristiques transformées par le quantique seules (Random forest Q), et sur les caractéristiques transformées par le quantique combinées aux caractéristiques classiques (Random forest H, pour hybride). Le tableau ne présente que la forêt aléatoire, car c'est elle qui a obtenu les meilleurs résultats sur les caractéristiques transformées par le quantique.
| Modèle | Caractéristiques | Exactitude | AUC | Score F1 | Précision | Rappel |
|---|---|---|---|---|---|---|
| CatBoost | Classiques | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Classiques | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Classiques | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Classiques | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Quantiques | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hybrides | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Les caractéristiques hybrides améliorent toutes les métriques de la forêt aléatoire, sauf la précision, et la forêt aléatoire hybride atteint une AUC, un score F1 et un rappel supérieurs à ceux de CatBoost sur les caractéristiques classiques. L'effet le plus important concerne le rappel, qui passe de 0.921 à 0.957. Les caractéristiques transformées par le quantique seules n'atteignent pas la précision des modèles classiques.
Le jeu de test ne contient que 200 échantillons, donc prédire correctement un échantillon de plus fait varier l'exactitude de 0.005. Interprète les différences comme une tendance qui doit être vérifiée davantage, et non comme un effet significatif. La précision des prédictions peut aussi dépendre du bruit induit par le matériel dans les caractéristiques extraites. Utilise donc suffisamment de shots pour que le bruit de shot ne limite pas le résultat.
Le benchmark a utilisé les ressources suivantes :
| Exemple | Nombre de qubits | Nombre d'échantillons | Nombre de shots | Temps total (min) | Utilisation du QPU (min) | Processeur |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Le nombre d'échantillons, qui est le nombre de circuits, détermine le temps de QPU. Utilise le type de processeur Nighthawk r2, car il réduit fortement le temps de QPU nécessaire.
Entrées
Le mode détermine les paramètres dont une exécution a besoin. Pour une description de chaque paramètre d'entrée, consulte la référence de l'API.
Fichiers d'entrée
-
Téléverse chaque fichier avec
catalog.file_upload()avant d'exécuter la fonction. -
Un téléversement remplace tout fichier précédent du même nom, même pour un job que tu as soumis mais qui n'a pas encore démarré. Pour exécuter plusieurs jobs en même temps, donne à chaque job ses propres noms de fichiers, par exemple
run1_x_train.csvetrun2_x_train.csv. -
Chaque fichier est un fichier CSV avec une ligne d'en-tête. Chaque colonne d'un fichier de caractéristiques est une caractéristique, et chaque valeur doit être numérique.
-
y_traincontient exactement une colonne numérique, avec une étiquette par ligne dex_train. Associe les étiquettes catégorielles à des nombres, par exemple bon et mauvais à 1 et 0. -
x_testetx_inferencedoivent avoir les mêmes colonnes quex_train, dans le même ordre.
Le mapping_id est le seul moyen d'accéder au mapping que ton ajustement a produit, et il ne peut ni être consulté ni être récupéré. Il autorise l'utilisation de ce mapping : traite-le donc comme un identifiant secret et ne le partage pas. Si tu le perds, tu dois ajuster un nouveau mapping, ce qui coûte une nouvelle exécution sur du matériel quantique. Note aussi le backend_name de l'ajustement, car le mapping ne s'exécute que sur ce processeur.
Limites
-
Chaque caractéristique est associée à un qubit, donc le processeur doit avoir au moins autant de qubits que tes données ont de caractéristiques. Si tu as plus de caractéristiques, réduis-les d'abord avec une technique de sélection de caractéristiques.
-
Chaque échantillon devient un circuit, et une exécution compte ensemble les échantillons d'entraînement et de test. Une exécution peut contenir au plus 15 000 échantillons.
-
Un seul job peut demander au plus 10 millions d'exécutions, donc le nombre d'échantillons multiplié par
shotsne doit pas dépasser 10 millions. -
Un job doit se terminer en 24 heures, y compris le temps que ses circuits attendent dans la file d'attente du processeur. Un job qui dure plus longtemps est arrêté sans résultat. Sur un processeur très sollicité, garde les grands jeux de données bien en dessous de ces limites.
Sorties
job.result() renvoie un dictionnaire. Les caractéristiques transformées par le quantique elles-mêmes sont écrites dans des fichiers CSV que tu télécharges avec catalog.file_download(). Pour une description de chaque clé du dictionnaire, consulte la référence de l'API. Pour la durée de chaque phase d'exécution, consulte Métadonnées d'exécution.
Chaque fichier de sortie contient une ligne par ligne d'entrée, dans l'ordre du fichier d'entrée, et une colonne par caractéristique transformée par le quantique. Les colonnes dont le nom commence par corr_ sont les valeurs moyennes à deux corps. Les fichiers ne contiennent aucune colonne d'étiquettes. Les étiquettes de tes données d'entraînement restent dans ton fichier y_train.
Métadonnées d'exécution
resource_usage contient une entrée pour chaque phase d'exécution que l'exécution a traversée : "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" et, sur un QPU, généralement "RUNNING: WAITING_FOR_QPU". Chaque entrée contient CPU_TIME, le temps réel de la phase en secondes, et QPU_TIME, le temps de QPU en secondes. Sur un QPU, le temps de QPU facturé par IBM est enregistré sous "RUNNING: MAPPING", la phase pendant laquelle les circuits se sont exécutés.
"RUNNING: WAITING_FOR_QPU" est le temps que tes jobs ont attendu dans la file d'attente d'IBM. L'exécution tire ce temps des horodatages des jobs IBM et ne le compte pas dans "RUNNING: MAPPING". Si IBM ne fournit pas ces horodatages pour chaque job, l'entrée est absente et l'attente fait partie de "RUNNING: MAPPING".
IBM® termine son calcul d'utilisation un certain temps après la fin d'un job. L'exécution l'attend jusqu'à environ une minute. L'utilisation encore en cours de calcul après ce délai n'est pas incluse dans QPU_TIME, et l'utilisation finale est affichée sur IBM Quantum Platform. Si l'exécution ne peut pas lire l'utilisation depuis IBM, QPU_TIME vaut None.
Par exemple :
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Premiers pas
Authentifie-toi avec ta clé d'API IBM Quantum Platform, puis sélectionne la Qiskit Function comme suit :
Le code suivant suppose que tu as enregistré tes identifiants. Sinon, suis les instructions de Installer le client Qiskit Functions Catalog pour enregistrer ton compte avec ta clé d'API.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Tailles de fonction
Chaque job s'exécute à une seule taille : S, M ou L. Si la taille spécifiée est trop petite, le job est rejeté. Si la taille est plus grande que nécessaire, il s'exécute sur un profil de calcul plus grand que ce dont le travail a besoin.
La taille d'un job Rimay dépend du nombre d'échantillons qu'il projette : les lignes de x_train et x_test pour fit-transform, et les lignes de x_inference pour transform. Les étiquettes de y_train ne comptent pas, et une exécution delete ne projette aucun échantillon.
| Taille | Échantillons par job | Profil de calcul | vCPU | RAM |
|---|---|---|---|---|
S | Jusqu'à 2 999 | 8x32 | 8 | 32 Go |
M | 3 000 à 9 999 | 8x32 | 8 | 32 Go |
L | 10 000 à 15 000 | 16x128 | 16 | 128 Go |
Le nombre d'échantillons est le seul critère. Une taille ne change rien d'autre que le profil de calcul : les limites sur les caractéristiques, les échantillons et les shots sont les mêmes pour toutes les tailles. S et M s'exécutent sur le même profil de calcul et diffèrent par le nombre d'échantillons que chacune couvre.
La valeur par défaut est M, utilisée quand un job ne demande pas de taille. Un job de plus de 9 999 échantillons doit donc demander L.
Tu peux aussi lire la correspondance directement depuis la fonction avec rimay.sizes_map, et la taille à laquelle un job s'exécute quand il n'en demande pas avec rimay.default_size.
Calculer la taille avant la soumission
Exécute ceci sur tes propres entrées. Il les lit et ne fait rien d'autre : aucun job n'est soumis et rien n'est réservé, donc tu peux l'appeler aussi souvent que tu le souhaites.
Passe les jeux de données eux-mêmes, et non leurs noms de fichiers, dans le même ordre que input_file, avec le mode de l'exécution. L'étape 2 de l'exemple montre l'appel.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Si la taille est trop petite, le job échoue avec l'erreur 4600 et le message indique la taille à utiliser à la place. Si elle est plus grande que nécessaire, le job s'exécute normalement et enregistre un événement d'avertissement 4601.
Exemple
Cet exemple montre comment téléverser des données, exécuter la fonction et récupérer les caractéristiques transformées par le quantique. Pour un exemple de bout en bout qui inclut le prétraitement et l'entraînement du modèle classique, consulte le tutoriel.
1. Téléverser les données
Cet exemple utilise un petit jeu de données synthétique avec quatre caractéristiques numériques et une étiquette binaire, de sorte qu'une exécution n'a besoin que de quatre qubits et se termine rapidement. La cellule suivante l'écrit dans quatre fichiers CSV : les caractéristiques d'entraînement, les étiquettes d'entraînement, les caractéristiques de test et les caractéristiques pour l'étape 4 de cet exemple. Pour utiliser tes propres données, écris plutôt tes jeux d'entraînement et de test prétraités dans des fichiers ayant la même disposition.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Téléverse les fichiers d'entraînement et de test. Tu téléverses x_inference.csv à l'étape 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Exécuter la fonction
Calcule la taille de l'exécution à partir des données que tu as téléversées, avec le calculateur de Tailles de fonction.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Sélectionne un processeur ayant au moins autant de qubits que tes données ont de caractéristiques, et exécute la fonction en mode fit-transform avec cette taille. Les données d'exemple ont quatre caractéristiques, donc n'importe quel processeur IBM Quantum peut l'exécuter.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Vérifie le statut de la charge de travail ou renvoie les résultats comme suit :
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Récupérer les résultats
Télécharge les caractéristiques transformées par le quantique. Passe target_name pour que chaque fichier soit enregistré sous son propre nom.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Projeter de nouvelles données
Après avoir entraîné ton modèle, projette de nouvelles données avec le mapping ajusté, par exemple pour exécuter une inférence. Cet exemple projette x_inference.csv, que la première cellule de cet exemple a écrit. Passe le mapping_id renvoyé par l'ajustement, afin que les nouvelles lignes soient projetées avec le même mapping au lieu d'un nouveau.
Un mapping est construit pour la disposition des qubits d'un seul processeur, donc passe le même backend_name que pour l'ajustement, que l'ajustement a renvoyé dans result["backend_name"]. N'utilise pas least_busy() pour choisir le processeur, car il pourrait en renvoyer un autre. Rimay rejette tout autre processeur avant de soumettre quoi que ce soit. Le nombre de shots provient lui aussi de l'ajustement.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Supprimer un mapping
Quand tu n'as plus besoin d'un mapping ajusté, supprime-le. Une exécution delete ne fait aucun travail quantique : elle n'a donc besoin ni de processeur, ni de shots, ni de taille de fonction. Tu ne peux pas annuler une suppression. Après la suppression, le mapping_id ne désigne plus rien, et une exécution transform avec lui échoue.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Récupérer les messages d'erreur
Si le statut de ta charge de travail est ERROR, utilise job.error_message() pour récupérer le message d'erreur, comme suit :
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Chaque erreur que Rimay signale comporte un code issu des codes d'erreur IBM Quantum, un message et une solution qui nomme la valeur que tu as passée et la valeur autorisée. Le tableau suivant liste les erreurs les plus courantes :
| Code | Cause |
|---|---|
1221 | Un paramètre est manquant ou de mauvais type, mode n'est pas valide, un fichier nommé dans input_file n'a pas été téléversé, les fichiers ne correspondent pas entre eux, une caractéristique n'est pas numérique, ou le mapping_id ne correspond à aucun mapping stocké. |
1221 | Une exécution "transform" nomme un backend_name différent de celui de l'ajustement qui a produit son mapping. |
1216 | Ton instance n'a aucun processeur avec le backend_name que tu as passé. La solution liste les processeurs qu'elle possède. |
1200 | Ta clé d'API n'a pas accès à l'instance sous laquelle le job s'exécute. |
3200 | backend_name ne commence pas par ibm_. |
4500 | Les données ont plus de caractéristiques que le processeur n'a de qubits. |
6000 | Le nombre d'échantillons multiplié par shots dépasse 10 millions d'exécutions. |
6001 | shots est inférieur à 1. |
6002 | Les données ont plus d'échantillons qu'une exécution n'en autorise. |
Cas d'usage
En classification tabulaire sur des jeux de données de petite et moyenne taille, Kipu Quantum a appliqué l'extraction de caractéristiques quantiques aux cas suivants :
Au-delà des données tabulaires, des réseaux de neurones gelés peuvent transformer des images en caractéristiques numériques, que l'extraction de caractéristiques quantiques projette ensuite en caractéristiques transformées par le quantique :
Obtenir de l'aide
Pour obtenir de l'aide, contacte support@kipu-quantum.com.
Étapes suivantes
-
Consulte la référence de l'API de cette Qiskit Function.
-
Essaie le tutoriel Classifier le risque de crédit avec l'extraction de caractéristiques quantiques Rimay de Kipu Quantum.
Références
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Informations complémentaires
Rimay est un mot quechua qui signifie « expliquer ».