Résoudre un problème d'ensemble indépendant maximum avec plus de variables que de qubits grâce au SQOA Solver de JIJ
Les Qiskit Functions sont une fonctionnalité expérimentale disponible uniquement pour les utilisateurs des offres IBM Quantum® Premium Plan, Flex Plan et On-Prem (via l'API IBM Quantum Platform). Elles sont en préversion et susceptibles de changer.
Estimation d'utilisation : 10 secondes sur un processeur Heron r2. (REMARQUE : il s'agit uniquement d'une estimation. Ta durée d'exécution peut varier.)
Contexte
Ce tutoriel montre comment utiliser SQOA Solver, une Qiskit Function de JIJ, pour résoudre un problème d'ensemble indépendant maximum (MIS) avec plus de variables binaires que le QPU choisi n'a de qubits. Les étapes de base consistent à charger une instance MIS depuis la Quantum Optimization Benchmarking Library (QOBLIB) [1], à la formuler sous forme d'optimisation binaire quadratique sans contrainte (QUBO) avec qiskit-addon-opt-mapper, à la soumettre à SQOA Solver pour exécution sur un QPU IBM®, puis à valider la solution renvoyée.
Le problème de l'ensemble indépendant maximum
Un ensemble indépendant est un sous-ensemble de nœuds d'un graphe tel que deux nœuds sélectionnés ne partagent jamais d'arête. Un ensemble indépendant maximum (MIS) est un ensemble indépendant ayant le plus grand nombre possible de nœuds. Les applications du MIS incluent l'ordonnancement, l'allocation de ressources et la conception de réseaux.
Le MIS est NP-difficile. Dans une recherche exhaustive, chaque nœud supplémentaire double le nombre de sous-ensembles à considérer, cette approche est donc impraticable même pour des graphes de taille modérée. QOBLIB inclut le MIS parmi ses dix classes de problèmes, c'est donc un benchmark utile pour évaluer des workflows d'optimisation quantique sur du matériel réel.
Formulation mathématique
Étant donné un graphe non orienté , associe une variable binaire à chaque nœud :
-
si le nœud est sélectionné.
-
otherwise.
La formulation linéaire binaire maximise le nombre de nœuds sélectionnés tout en empêchant que les deux extrémités d'une arête soient sélectionnées :
L'objectif compte les nœuds sélectionnés. Ensemble, les contraintes d'arête garantissent que les nœuds sélectionnés forment un ensemble indépendant.
Ce tutoriel utilise la formulation binaire sans contrainte de QOBLIB, qui remplace les contraintes d'arête par des pénalités quadratiques :
Chaque fois que les deux extrémités d'une arête sont sélectionnées, le second terme retranche deux à l'objectif. Cette pénalité rend une sélection conflictuelle moins favorable que le fait de ne garder qu'une des deux extrémités. L'objectif obtenu est un QUBO, qui est le format d'entrée accepté par SQOA Solver.
Pourquoi utiliser SQOA Solver ?
De nombreuses approches d'optimisation quantique associent un qubit à chaque variable binaire, de sorte que la capacité du matériel quantique peut limiter directement la taille du problème. SQOA Solver combine plusieurs techniques de réduction et de calcul hybride pour atténuer cette restriction :
-
Il peut traiter des problèmes ayant plus de variables binaires que le QPU n'a de qubits. Le presolve applique des règles de réduction qui peuvent fixer des variables et simplifier le QUBO restant tout en préservant au moins une solution optimale. Empiriquement, le presolve peut aussi rendre le QUBO restant plus creux, ce qui aide l'encodage basé sur QRAC qui le suit.
Le solveur utilise ensuite un encodage basé sur QRAC dérivé de la Quantum Random Access Optimization (QRAO) [3] pour représenter plusieurs variables (jusqu'à trois) sans interaction QUBO directe sur le même qubit.
Les réductions dues au presolve et à l'encodage dépendent de la structure du problème. Par exemple, dans ce tutoriel, un problème à 200 variables n'utilise que 67 qubits.
-
Il peut être moins sensible au bruit matériel. La diagonalisation quantique basée sur l'échantillonnage [4], [5] utilise le QPU pour échantillonner des bitstrings mais effectue la diagonalisation de façon classique. Cela évite des évaluations répétées sur le QPU pour les mises à jour des paramètres variationnels et peut réduire l'impact du bruit sur le workflow d'optimisation.
-
Il automatise le workflow du presolve jusqu'au post-traitement. Tu fournis une instance QUBO correctement formatée et tu sélectionnes un Backend. SQOA Solver exécute ensuite automatiquement tout le workflow. Il applique le presolve, associe les variables classiques à un problème quantique relaxé, construit et transpile les circuits d'échantillonnage, effectue l'échantillonnage quantique et la diagonalisation classique, arrondit et affine l'affectation, puis reconstruit et évalue la solution classique.
Prérequis
Avant de commencer ce tutoriel, assure-toi d'avoir installé les paquets suivants :
-
Client du catalogue Qiskit Functions (
pip install qiskit-ibm-catalog). -
Qiskit addon optimization mapper, utilisé pour formuler le problème (
pip install qiskit-addon-opt-mapper). -
NetworkX et Matplotlib, utilisés pour manipuler et tracer le graphe (
pip install networkx matplotlib).
Tu as aussi besoin d'un accès à SQOA Solver depuis le catalogue Qiskit Functions. Remplis le formulaire pour demander l'accès à la fonction.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "networkx": "networkx", "ommx": "ommx", "ommx_quantum_benchmarks": "ommx-quantum-benchmarks", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# %pip install qiskit-ibm-catalog qiskit-addon-opt-mapper networkx matplotlib
Configuration
Commence par importer les paquets et outils nécessaires.
import urllib.request

import matplotlib.pyplot as plt
import networkx as nx
from qiskit_addon_opt_mapper import OptimizationProblem
from qiskit_addon_opt_mapper.converters import OptimizationProblemToQubo
from qiskit_ibm_catalog import QiskitFunctionsCatalog
SQOA Solver accepte un problème QUBO sous forme de dictionnaire de coefficients au format tuple-chaîne utilisé par les fonctions d'optimisation IBM®. Définis une fonction utilitaire qui convertit le QUBO renvoyé par OptimizationProblemToQubo dans ce format.
Le convertisseur renvoie toujours un problème de minimisation, ce qui correspond à la façon dont SQOA Solver traite un problème de type dictionnaire. Les clés utilisent les indices de variables du QUBO, et chaque variable reçoit une entrée linéaire, même avec un coefficient nul, afin que la solution renvoyée couvre toutes les variables.
def to_problem_dict(qubo: OptimizationProblem) -> dict[str, float]:
    """Convert a QUBO from OptimizationProblemToQubo to the SQOA Solver dictionary format."""
    objective = qubo.objective
    payload = {"()": objective.constant}
    # Keep every variable in the problem, even with a zero linear coefficient.
    payload.update({f"({i},)": 0.0 for i in range(qubo.get_num_vars())})
    for i, coefficient in objective.linear.to_dict().items():
        payload[f"({i},)"] += coefficient
    for (i, j), coefficient in objective.quadratic.to_dict().items():
        # Fold a binary diagonal term x_i * x_i = x_i into the linear term.
        key = f"({i},)" if i == j else f"({i}, {j})"
        payload[key] = payload.get(key, 0.0) + coefficient
    return {key: float(value) for key, value in payload.items()}
Étape 1 : associer les entrées classiques à un problème quantique
SQOA Solver accepte un problème QUBO et effectue l'association quantique à l'intérieur de la fonction. Dans ce tutoriel, tu télécharges une instance MIS depuis QOBLIB et tu la formules comme un QUBO avec qiskit-addon-opt-mapper. Cette étape couvre les points suivants :
-
Se connecter à SQOA Solver.
-
Comprendre le framework SQOA.
-
Charger l'instance du problème.
-
Formuler le QUBO et le convertir pour la soumission.
Se connecter à SQOA Solver
Connecte-toi au catalogue Qiskit Functions avec tes identifiants IBM Quantum Platform, puis charge SQOA Solver. Le code suivant suppose que tu as déjà enregistré ton compte dans ton environnement local.
Si la connexion échoue, vérifie que l'administrateur de ton compte IBM Quantum Platform a accordé à l'instance de service sélectionnée l'accès à SQOA Solver.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
solver = catalog.load("jij/sqoa-solver")
Comprendre le framework SQOA
L'algorithme d'optimisation quantique basé sur l'échantillonnage avec relaxation quantique (SQOA-QR) [2] combine la Quantum Random Access Optimization (QRAO) avec la diagonalisation quantique basée sur l'échantillonnage :
-
Relaxation et encodage quantiques : SQOA Solver convertit le QUBO en un objectif d'Ising de minimisation de la forme , où . La QRAO [3] associe ensuite chaque variable de spin à une observable de Pauli. Pour l'encodage -QRAC utilisé ici, l'hamiltonien relaxé est
où est l'opérateur identité, affecte la variable à un qubit et à l'un des opérateurs , ou , et est le nombre de variables associées au même qubit que . Lorsque les deux qubits concernés contiennent trois variables, les facteurs d'échelle linéaire et quadratique deviennent respectivement et .
Les variables qui partagent un qubit reçoivent des observables de Pauli non commutantes différentes. Les variables qui interagissent dans le QUBO sont placées sur des qubits différents, tandis que les variables sans interaction QUBO directe peuvent partager un qubit. La réduction du nombre de qubits dépend donc de la structure du problème.
-
Échantillonnage quantique : un processeur quantique échantillonne des bitstrings à partir de circuits conçus pour explorer les états de basse énergie de l'hamiltonien relaxé.
-
Diagonalisation basée sur l'échantillonnage : le solveur projette l'hamiltonien relaxé sur le sous-espace engendré par les états de base obtenus à partir des bitstrings échantillonnés et diagonalise classiquement l'hamiltonien projeté [4], [5]. Pour un ensemble fixé de bitstrings échantillonnés, soit le sous-espace engendré par états de base distincts, de sorte que . Son énergie estimée de l'état fondamental est :
où est l'énergie de l'état fondamental de l'hamiltonien relaxé complet. Par conséquent, un sous-espace conservé plus grand ne peut pas augmenter l'énergie estimée de l'état fondamental.
Cet ordre suppose le même résultat d'échantillonnage et concerne l'énergie de l'hamiltonien relaxé avant arrondi. Il ne garantit pas théoriquement une meilleure solution classique renvoyée. Cependant, dans la QRAO, on s'attend heuristiquement à ce qu'un état de plus basse énergie fournisse une meilleure solution classique.
-
Arrondi : l'état relaxé obtenu à partir de la diagonalisation est converti en une affectation binaire classique.
SQOA Solver entoure ce framework d'un traitement classique. Avant l'association quantique, le presolve applique des règles de réduction qui peuvent fixer des variables et simplifier le QUBO restant tout en préservant au moins une solution optimale. Après la diagonalisation et l'arrondi, une recherche locale classique affine l'affectation, et OMMX reconstruit et évalue la solution complète.
Charger l'instance
QOBLIB distribue chaque instance MIS sous forme de graphe au format DIMACS .gph, un format orienté lignes dans lequel la ligne commençant par p donne le nombre de nœuds et d'arêtes et chaque ligne commençant par e définit une arête.
QOBLIB publie aussi une solution de référence optimale ou la meilleure connue pour chaque instance. Les fonctions suivantes téléchargent les deux depuis le dépôt QOBLIB. DIMACS numérote les nœuds à partir de 1, donc le graphe est renuméroté pour commencer à 0.
Si tu préfères partir de ton propre graphe, saute le téléchargement et formule le problème à partir de ton graphe NetworkX de la même manière.
QOBLIB_URL = "https://raw.githubusercontent.com/ZIB-AOPT/QOBLIB/refs/heads/main/07-independentset"

def fetch_qoblib_graph(name: str) -> nx.Graph:
    """Download a QOBLIB independent-set instance as a NetworkX graph."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/instances/{name}.gph"
    ) as response:
        lines = response.read().decode().splitlines()
    graph = nx.Graph()
    for fields in map(str.split, lines):
        if fields and fields[0] == "p":
            # Header: p edge <number of nodes> <number of edges>
            graph.add_nodes_from(range(int(fields[2])))
        elif fields and fields[0] == "e":
            # DIMACS labels nodes from 1; relabel them to start from 0.
            graph.add_edge(int(fields[1]) - 1, int(fields[2]) - 1)
    return graph

def fetch_reference_objective(name: str) -> float:
    """Read the objective value of the QOBLIB reference solution."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/solutions/{name}.opt.sol"
    ) as response:
        for line in response.read().decode().splitlines():
            if line.startswith("# Objective value"):
                return float(line.split("=")[1])
    raise ValueError(f"No objective value found for {name}.")

INSTANCE_NAME = "gen200_p0-9_44"
G = fetch_qoblib_graph(INSTANCE_NAME)
reference_objective = fetch_reference_objective(INSTANCE_NAME)
Tu utilises plus tard la valeur objectif de la solution de référence pour évaluer le résultat de SQOA Solver. Ce tutoriel résout ce problème sur un appareil de 156 qubits.
print(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
print(f"Reference objective: {reference_objective:g}")
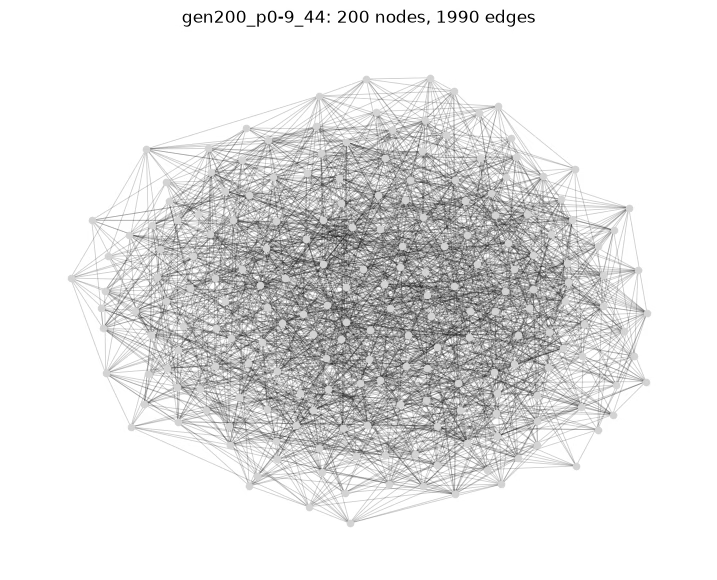
gen200_p0-9_44: 200 nodes, 1990 edges
Reference objective: 44
Visualise le graphe. Plus tard, tu l'utilises aussi pour vérifier que les nœuds renvoyés par SQOA Solver forment un ensemble indépendant.
layout = nx.forceatlas2_layout(
    G, max_iter=500, scaling_ratio=3.0, gravity=1.0, seed=7
)
node_size = max(8, min(60, 4000 / max(G.number_of_nodes(), 1)))

fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G, layout, node_size=node_size, node_color="lightgray", ax=ax
)
ax.set_title(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
ax.set_axis_off()
plt.show()
Formuler le QUBO
Construis la formulation linéaire binaire de la section Contexte sous forme d'OptimizationProblem avec une variable binaire par nœud, un objectif qui compte les nœuds sélectionnés et une contrainte par arête. Convertis-la ensuite avec OptimizationProblemToQubo.
Avec un poids de pénalité de 2, le convertisseur remplace chaque contrainte d'arête par le terme de pénalité et transforme la maximisation en minimisation, de sorte que le problème converti est la formulation binaire sans contrainte de QOBLIB avec son signe inversé. Les indices de variables du QUBO sont les étiquettes de nœuds du graphe. La classe d'application IndependentSet de qiskit_addon_opt_mapper.applications construit le même modèle contraint avec IndependentSet(G).to_optimization_problem().
Enfin, convertis le QUBO au format dictionnaire avec to_problem_dict(). Comme le problème est un QUBO binaire, la requête de l'étape 2 déclare son domaine de variables comme "binary". La fonction effectue le presolve, l'association quantique et la construction des circuits après la soumission.
mis = OptimizationProblem(INSTANCE_NAME)
mis.binary_var_list(G.number_of_nodes(), name="x")
mis.maximize(linear={v: 1 for v in G.nodes})
for u, v in G.edges:
    mis.linear_constraint({u: 1, v: 1}, "<=", 1)

converter = OptimizationProblemToQubo(penalty=2)
qubo = converter.convert(mis)
problem_dict = to_problem_dict(qubo)

print(f"QUBO variables: {qubo.get_num_vars()}")
print(f"Dictionary entries: {len(problem_dict)}")
QUBO variables: 200
Dictionary entries: 2191
Étape 2 : optimiser le problème pour l'exécution sur matériel quantique
SQOA Solver effectue l'association quantique et la préparation matérielle à l'intérieur de la fonction. Il applique d'abord le presolve au QUBO, puis associe les variables restantes à un hamiltonien relaxé à l'aide d'un encodage basé sur QRAC.
Pour l'échantillonnage quantique, il construit des circuits basés sur l'hamiltonien relaxé et les transpile pour le Backend sélectionné. Les réductions de taille du problème et du nombre de qubits dues au presolve et à l'encodage dépendent du problème, donc configure le solveur sans supposer un facteur de réduction fixe.
Configurer les entrées du solveur
SQOA Solver requiert deux entrées :
-
problem, le dictionnaire de l'étape 1. -
variable_type, qui vaut"binary"pour ce QUBO.
Il accepte aussi deux entrées facultatives :
-
backend_namesélectionne le QPU. Lorsqu'il est omis ou vautNone, la fonction sélectionne le QPU opérationnel le moins occupé accessible à ton instance. -
optionsest un dictionnaire qui contrôle le budget d'échantillonnage (shots), la graine classique (seed), l'utilisation de Session (session), la recherche locale classique (postprocessing_level) et les étiquettes de job (job_tags). Si tu augmentesshots, les statistiques d'échantillonnage peuvent s'améliorer.
Pour toutes les entrées, leurs valeurs par défaut et les règles de validation, consulte la référence de l'API.
Ce tutoriel nomme explicitement le Backend, utilise les valeurs par défaut de shots, session et postprocessing_level, et fixe la graine classique. Rassemble les entrées dans un dictionnaire afin de pouvoir les passer à solver.run() à l'étape 3.
# ibm_fez has 156 qubits
backend_name = (
    "ibm_fez"  # Omit this key or pass None for automatic selection.
)

sqoa_input = {
    "problem": problem_dict,
    "variable_type": "binary",
    "backend_name": backend_name,
}
sqoa_input["options"] = {
    "shots": 4096,
    "seed": 42,
    "session": False,
    "postprocessing_level": 1,
}
Étape 3 : exécuter avec les primitives
Soumets le job avec la connexion à SQOA Solver créée à l'étape 1. La fonction exécute la primitive IBM Quantum Sampler sur le Backend sélectionné, collecte les bitstrings mesurés, puis poursuit avec la diagonalisation classique et le post-traitement. Tu n'interagis qu'avec un seul job de fonction.
job = solver.run(**sqoa_input)
print(f"Job ID: {job.job_id}")
Job ID: dcee8e26-b8ac-4dd7-a76e-5adb5bc388e5
Pour vérifier l'état de la charge de travail, consulte Vérifier l'état d'un job. En interne, la fonction passe par les phases d'association, d'optimisation matérielle, d'attente en file, d'exécution sur QPU et de post-traitement.
job.status()
'INITIALIZING'
job.result() bloque jusqu'à la fin du job et renvoie un dictionnaire contenant la solution, sa valeur objectif et sa faisabilité, ainsi que des métadonnées qui contiennent les informations du solveur et l'utilisation des ressources. Pour la définition complète des entrées et des sorties, consulte la référence de l'API.
result = job.result()
Étape 4 : post-traiter le résultat et le convertir dans un format classique
Inspecte la sortie complète de la fonction, associe l'affectation renvoyée au graphe, vérifie les nœuds sélectionnés et visualise le résultat.
Inspecter le résultat
Le dictionnaire de résultat contient quatre champs de premier niveau :
-
solutionest l'affectation complète des variables, indexée parx_i, où i est l'indice de la variable (par exemple,x_17). Dans ce tutoriel, l'indice de la variable est l'étiquette du nœud. -
objective_valueest l'objectif de cette affectation évalué sur le dictionnaire soumis, c'est-à-dire sur le QUBO de minimisation. -
feasiblene concerne que le domaine des variables, car le dictionnaire n'a pas de contraintes. -
metadatacontientsolver_infoetresource_usage.solver_infoenregistre laseedeffective de l'exécution. Si la recherche locale classique a été exécutée,solver_infoenregistre aussi l'affectation arrondie d'avant cet affinage danssolution_before_postprocessing.
solver_info = result["metadata"]["solver_info"]

print(f"Result fields: {list(result)}")
print(f"Solution entries: {len(result['solution'])}")
print(f"First entries: {dict(list(result['solution'].items())[:3])}")
print(f"Objective value: {result['objective_value']}")
print(f"Feasible: {result['feasible']}")
print(f"Solver-info fields: {list(solver_info)}")
print(f"Effective seed: {solver_info['seed']}")
print(f"Resource-usage phases: {list(result['metadata']['resource_usage'])}")
Result fields: ['solution', 'objective_value', 'feasible', 'metadata']
Solution entries: 200
First entries: {'x_0': 0.0, 'x_1': 0.0, 'x_2': 1.0}
Objective value: -35.0
Feasible: True
Solver-info fields: ['seed', 'solution_before_postprocessing']
Effective seed: 42
Resource-usage phases: ['RUNNING: MAPPING', 'RUNNING: OPTIMIZING_FOR_HARDWARE', 'RUNNING: WAITING_FOR_QPU', 'RUNNING: EXECUTING_QPU', 'RUNNING: POST_PROCESSING']
Associer la solution au graphe
Rassemble les valeurs renvoyées dans l'ordre des indices de variables, puis réassocie-les aux variables du problème d'origine avec interpret(). Les nœuds sélectionnés sont les variables de valeur 1, et is_feasible() vérifie l'affectation par rapport aux contraintes d'arête du problème d'origine.
x_qubo = [result["solution"][f"x_{i}"] for i in range(qubo.get_num_vars())]
x = converter.interpret(x_qubo)
selected_nodes = [node for node, value in enumerate(x) if value > 0.5]

print(f"Selected nodes: {len(selected_nodes)}")
print(f"Satisfies every edge constraint: {mis.is_feasible(x)}")
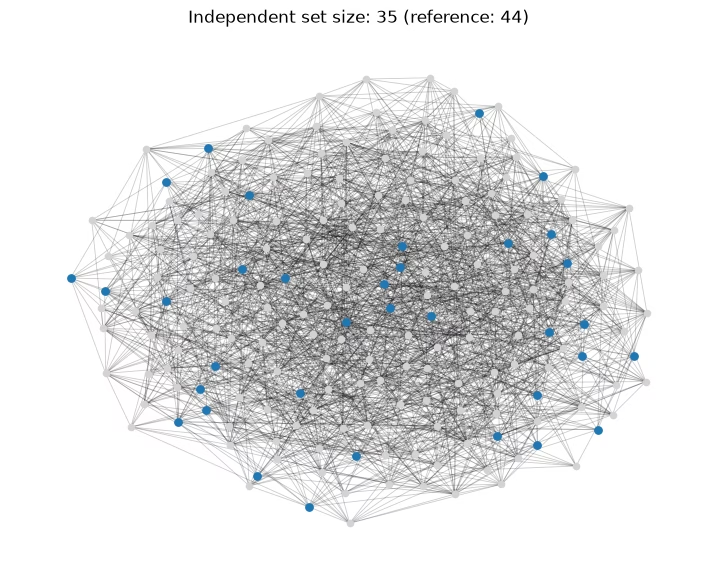
Selected nodes: 35
Satisfies every edge constraint: True
Comparer avec la solution avant le post-traitement
Comme postprocessing_level vaut 1, solver_info enregistre aussi l'affectation arrondie d'avant la recherche locale classique dans solution_before_postprocessing. Elle utilise les mêmes clés que solution.
Évalue-la sur le QUBO pour voir de combien l'affinage a amélioré le résultat. Les deux valeurs sont des objectifs du QUBO de minimisation soumis, donc une valeur plus basse est meilleure. Le champ est omis lorsque la recherche locale ne s'exécute pas, par exemple lorsque le presolve fixe toutes les variables.
before = solver_info.get("solution_before_postprocessing")
if before is None:
    print("The classical local search did not run for this problem.")
else:
    x_before = [before[f"x_{i}"] for i in range(qubo.get_num_vars())]
    changed = sum(
        before[key] != value for key, value in result["solution"].items()
    )
    print(
        f"Objective before local search: {qubo.objective.evaluate(x_before)}"
    )
    print(f"Objective after local search: {result['objective_value']}")
    print(f"Variables changed by local search: {changed}")
Objective before local search: -12.0
Objective after local search: -35.0
Variables changed by local search: 19
Vérifier la contrainte d'indépendance
Comme le QUBO représente l'adjacence par des termes de pénalité plutôt que par des contraintes explicites, un résultat heuristique peut quand même sélectionner des nœuds adjacents. Vérifie directement les nœuds renvoyés par rapport au graphe. Pour la comparaison et la visualisation dans les sections suivantes, copie l'ensemble renvoyé et retire de façon gloutonne une extrémité de chaque conflit détecté.
returned_set = set(selected_nodes)
conflicts = [
    (u, v) for u, v in G.edges if u in returned_set and v in returned_set
]
print(f"Conflicting edges in the returned set: {len(conflicts)}")

independent_set = returned_set.copy()
for u, v in conflicts:
    if u in independent_set and v in independent_set:
        # Drop the endpoint that has more selected neighbors.
        drop = max(
            (u, v),
            key=lambda node: sum(nb in independent_set for nb in G[node]),
        )
        independent_set.remove(drop)

assert all(
    not (u in independent_set and v in independent_set) for u, v in G.edges
)
print(f"Independent set size after repair: {len(independent_set)}")
Conflicting edges in the returned set: 0
Independent set size after repair: 35
Comparer avec la solution de référence
À l'étape 1, tu as téléchargé la valeur objectif de la solution de référence QOBLIB. Les solutions de référence de QOBLIB peuvent être optimales ou les meilleures connues, donc compare avec l'objectif de référence sans supposer qu'il s'agit toujours d'un optimum certifié.
Pour ce problème de maximisation, un ratio de 1,0 signifie que le résultat réparé correspond à l'objectif de référence.
ratio_to_reference = len(independent_set) / reference_objective

print(f"Reference objective: {reference_objective:g}")
print(f"Ratio to reference: {ratio_to_reference:.3f}")
Reference objective: 44
Ratio to reference: 0.795
Visualiser le résultat
Trace à nouveau le graphe en mettant en évidence l'ensemble indépendant réparé. Deux nœuds mis en évidence ne partagent jamais d'arête.
fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=[v for v in G if v not in independent_set],
    node_size=node_size,
    node_color="lightgray",
    ax=ax,
)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=sorted(independent_set),
    node_size=node_size * 1.4,
    node_color="tab:blue",
    ax=ax,
)
ax.set_title(
    f"Independent set size: {len(independent_set)} "
    f"(reference: {reference_objective:g})"
)
ax.set_axis_off()
plt.show()
Lire l'utilisation des ressources
Les métadonnées du résultat indiquent CPU_TIME pour les phases autres que RUNNING: EXECUTING_QPU, lorsqu'il est disponible. La phase RUNNING: EXECUTING_QPU peut indiquer QPU_TIME, l'utilisation de la QPU renvoyée par Quantum Compute, si l'utilisation finale est disponible pour chaque job Quantum Compute.
usage = result["metadata"]["resource_usage"]

for phase, metrics in usage.items():
    line = f"{phase:36s}"
    if "CPU_TIME" in metrics:
        line += f" CPU {metrics['CPU_TIME']:8.1f} s"
    if "QPU_TIME" in metrics:
        line += f" QPU {metrics['QPU_TIME']:8.1f} s"
    print(line)
RUNNING: MAPPING                     CPU     11.8 s
RUNNING: OPTIMIZING_FOR_HARDWARE     CPU     15.4 s
RUNNING: WAITING_FOR_QPU             CPU     16.5 s
RUNNING: EXECUTING_QPU               QPU      3.0 s
RUNNING: POST_PROCESSING             CPU     55.8 s
Conclusion
Dans ce tutoriel, tu as téléchargé une instance MIS depuis QOBLIB, tu l'as formulée comme un QUBO avec qiskit-addon-opt-mapper, tu t'es connecté à SQOA Solver, tu as configuré et soumis la charge de travail, tu as reporté l'affectation renvoyée sur le graphe et tu as vérifié les nœuds sélectionnés par rapport au graphe d'origine.
Tu as également comparé le résultat avec la solution de référence de QOBLIB, examiné la contribution du post-traitement classique et inspecté l'utilisation des ressources de chaque phase d'exécution.
SQOA Solver combine le presolve, le QRAO avec un encodage basé sur QRAC, la construction de circuits d'échantillonnage, la transpilation adaptée au matériel, la diagonalisation basée sur des échantillons, l'arrondi et le raffinement classique. Ce workflow peut représenter plus de variables binaires qu'un encodage à une variable par qubit ne le permettrait. L'ampleur de la réduction obtenue par le presolve et l'encodage dépend de la structure du problème, et la qualité de la solution dépend des échantillons obtenus.
Les paramètres shots et postprocessing_level contrôlent respectivement le budget d'échantillonnage quantique et le raffinement classique, sans modifier le workflow de soumission.
Annexe : soumettre le problème comme instance OMMX
SQOA Solver accepte aussi une ommx.v1.Instance issue du SDK OMMX. Le paquet OMMX Quantum Benchmarks distribue les problèmes QOBLIB sous forme d'instances OMMX avec leurs solutions de référence, ce qui te permet de charger le même QUBO sans le formuler toi-même.
Avec une entrée OMMX, objective_value est évalué au sens de l'instance, et le résultat contient aussi la ommx.v1.Solution canonique. Installe le paquet, ce qui installe aussi le SDK OMMX :
# %pip install ommx-quantum-benchmarks
Charge le modèle binary_unconstrained de la même instance. Le chargeur du jeu de données affiche des messages de progression, donc le code les capture pour garder la sortie compacte.
%%capture
from ommx_quantum_benchmarks.qoblib import IndependentSet

ommx_instance, _ = IndependentSet()("binary_unconstrained", INSTANCE_NAME)
SQOA Solver reçoit une instance OMMX sous forme de chaîne Base64 standard avec remplissage et renvoie la solution canonique dans le même format. Définis deux fonctions utilitaires pour cette conversion :
-
to_problem_payload()sérialise uneommx.v1.Instanceen la chaîne que tu passes commeproblem. -
to_ommx_solution()décode laommx.v1.Solutioncanonique à partir du résultat.
import base64

from ommx.v1 import Instance, Solution

def to_problem_payload(instance: Instance) -> str:
    """Serialize an OMMX instance into the `problem` string for SQOA Solver."""
    return base64.b64encode(instance.to_bytes()).decode()

def to_ommx_solution(result: dict) -> Solution:
    """Decode the canonical OMMX solution from a SQOA Solver result."""
    payload = result["metadata"]["solver_info"]["ommx_solution"]
    return Solution.from_bytes(base64.b64decode(payload, validate=True))
Soumets l'instance avec les mêmes entrées qu'avant, en remplaçant uniquement problem. Décode ensuite la solution canonique et lis les nœuds sélectionnés par nom de variable.
ommx_job = solver.run(
    **{**sqoa_input, "problem": to_problem_payload(ommx_instance)}
)
ommx_result = ommx_job.result()

ommx_solution = to_ommx_solution(ommx_result)
x_values = ommx_solution.extract_decision_variables("x")
ommx_nodes = sorted(
    node for (node,), value in x_values.items() if value > 0.5
)

print(f"Objective value: {ommx_result['objective_value']}")
print(f"Selected nodes: {len(ommx_nodes)}")
Objective value: 35.0
Selected nodes: 35
Étapes suivantes
- Applique le workflow à tes propres problèmes QUBO. Construis un
OptimizationProblemcomme indiqué dans le guide de SQOA Solver. Les étapes de conversion et de soumission restent les mêmes, mais adapte la validation à la structure de ton problème. - Soumets le problème comme instance OMMX, comme indiqué dans l'annexe. Consulte la référence de l'API pour les formats de problème acceptés et les champs renvoyés.
- Explore d'autres instances d'ensemble indépendant dans le dépôt QOBLIB ou via OMMX Quantum Benchmarks.
- Apprends-en plus sur la modélisation avec qiskit-addon-opt-mapper ou JijModeling et sur l'échange de problèmes avec OMMX.
Références
[1] Koch, T., Bernal Neira, D. E., Chen, Y., Cortiana, G., Egger, D. J., Heese, R., Hegade, N. N., Gomez Cadavid, A., Huang, R., Itoko, T., et al. (2026). Quantum optimization benchmarking library: The intractable decathlon. Nature Computational Science, 6, 653–671. DOI, arXiv:2504.03832
[2] Matsuyama, H., & Yamashiro, Y. (2025). Sampling-based quantum optimization algorithm with quantum relaxation. 2025 IEEE International Conference on Quantum Computing and Engineering (QCE), 1, 2323–2333. DOI, arXiv:2504.12629
[3] Fuller, B., Hadfield, C., Glick, J. R., Imamichi, T., Itoko, T., Thompson, R. J., Jiao, Y., Kagele, M. M., Blom-Schieber, A. W., Raymond, R., et al. (2024). Approximate solutions of combinatorial problems via quantum relaxations. IEEE Transactions on Quantum Engineering, 5, 1–15. DOI, arXiv:2111.03167
[4] Kanno, K., Kohda, M., Imai, R., Koh, S., Mitarai, K., Mizukami, W., & Nakagawa, Y. O. (2026). Quantum-selected configuration interaction: Classical diagonalization of Hamiltonians in subspaces selected by quantum computers. Physical Review Research, 8(2), 023268. DOI, arXiv:2302.11320
[5] Robledo-Moreno, J., Motta, M., Haas, H., Javadi-Abhari, A., Jurcevic, P., Kirby, W., et al. (2025). Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer. Science Advances, 11(25), eadu9991. DOI, arXiv:2405.05068