Classifier le risque de crédit avec la Quantum Feature Extraction Rimay de Kipu Quantum
Les Qiskit Functions sont une fonctionnalité expérimentale disponible uniquement pour les utilisateurs des offres IBM Quantum® Premium Plan, Flex Plan et On-Prem (via l'API IBM Quantum Platform). Elles sont en version préliminaire (preview) et susceptibles de changer.
Estimation d'utilisation : 2 minutes sur un processeur Nighthawk r2. (REMARQUE : il s'agit uniquement d'une estimation. Ton temps d'exécution peut varier.)
Objectifs d'apprentissage
-
Prépare des données tabulaires avec des colonnes catégorielles et numériques pour la Qiskit Function Rimay.
-
Ajuste une correspondance quantique de caractéristiques sur les données d'entraînement et applique-la aux données de test dans la même exécution.
-
Entraîne des modèles classiques sur les caractéristiques transformées quantiquement, seules et combinées avec les caractéristiques d'origine.
-
Compare les résultats à une référence purement classique.
Prérequis
Avant de commencer ce tutoriel, tu dois être familier avec les sujets suivants :
-
Classification supervisée avec scikit-learn
Contexte
De nombreux problèmes d'apprentissage automatique dans l'industrie portent sur des jeux de données tabulaires de petite ou moyenne taille, où ajouter des données n'est pas possible et où la précision du modèle plafonne. Le scoring du risque de crédit en est un exemple typique. Un prêteur utilise quelques dizaines d'attributs pour décider si le demandeur est susceptible de rembourser le crédit.
Rimay, une Qiskit Function de Kipu Quantum, ajoute une étape de prétraitement quantique à un tel pipeline. Elle implémente l'algorithme d'extraction quantique de caractéristiques contre-diabatique numérisé [1]. Chaque caractéristique d'entrée est associée à un qubit. Les valeurs des caractéristiques et l'information mutuelle entre elles fixent les champs locaux et les couplages d'un hamiltonien de verre de spin. La dynamique contre-diabatique fait ensuite évoluer le système quantique vers ses états de basse énergie, et les valeurs moyennes à un et deux corps mesurées à la fin deviennent les nouvelles caractéristiques transformées quantiquement. Ces caractéristiques capturent des corrélations non linéaires entre les entrées, et tu peux les fournir à n'importe quel modèle classique.
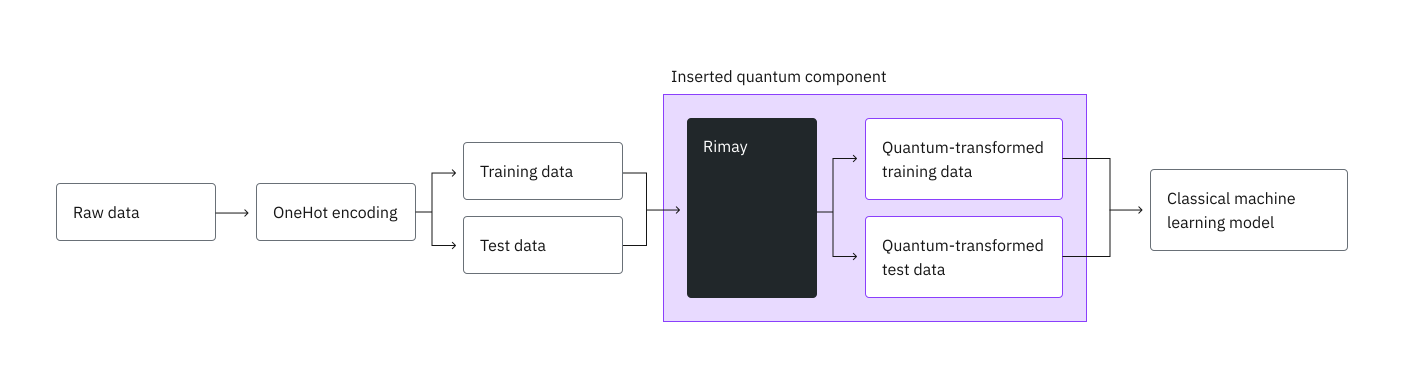
Ce tutoriel utilise le jeu de données German credit d'OpenML [2], avec 1000 demandeurs et 20 attributs, pour entraîner un classifieur par forêt aléatoire. Tu établis d'abord une référence classique, puis tu envoies les données à Rimay, et enfin tu entraînes le même type de modèle sur les caractéristiques transformées quantiquement, seules et combinées avec les caractéristiques d'origine.
Exigences
Avant de commencer ce tutoriel, assure-toi d'avoir installé les paquets suivants :
-
Client IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Tu as également besoin d'un accès à la fonction Rimay du catalogue Qiskit Functions.
Configuration
Importe les paquets et définis deux fonctions utilitaires : l'une qui entraîne une forêt aléatoire, et l'autre qui calcule les métriques utilisées tout au long du tutoriel.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Configurer les identifiants IBM Quantum
Authentifie-toi avec ta clé API IBM Quantum Platform, charge la fonction Rimay et sélectionne le processeur quantique le moins occupé disponible pour ton instance.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Étape 1 : Associer les entrées classiques à un problème quantique
Rimay associe chaque caractéristique d'entrée numérique à un qubit, donc la première étape consiste à transformer le tableau brut en caractéristiques numériques.
Charger le jeu de données
Charge le jeu de données German credit directement depuis OpenML. La colonne class contient l'étiquette : good pour les demandeurs qui ont remboursé leur crédit et bad pour ceux qui ne l'ont pas fait.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Encoder les caractéristiques
Convertis l'étiquette en valeur binaire et applique un encodage one-hot aux 13 colonnes catégorielles. Le code supprime la première catégorie de chaque colonne pour éviter les caractéristiques redondantes, ce qui donne 48 caractéristiques numériques.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Séparer en ensembles d'entraînement et de test
Mets de côté 20 % des demandeurs comme ensemble de test. Une séparation stratifiée conserve la même proportion de bons et de mauvais crédits dans les deux ensembles.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Établir une référence classique
Entraîne une forêt aléatoire sur les caractéristiques classiques. À l'étape 4, tu compares les caractéristiques transformées quantiquement à ses métriques.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Téléverser les données vers Rimay
Rimay lit ses entrées à partir de fichiers CSV que tu téléverses vers la fonction. Les caractéristiques et les étiquettes vont dans des fichiers séparés. Tu téléverses aussi l'ensemble de test, afin que Rimay l'associe avec la même correspondance que celle ajustée sur l'ensemble d'entraînement.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Étape 2 : Optimiser le problème pour l'exécution sur matériel quantique
Rimay construit et transpile les circuits pour le processeur que tu sélectionnes, il n'y a donc aucun circuit à optimiser à la main. Indique le nombre de shots par circuit, en respectant les contraintes suivantes :
-
Chaque caractéristique nécessite un qubit, donc le processeur doit avoir au moins autant de qubits que le jeu de données a de caractéristiques.
-
Rimay exécute un circuit par ligne, lignes d'entraînement et de test confondues. Un seul job peut demander au plus 10 millions d'exécutions, donc le nombre de lignes multiplié par
shotsdoit rester dans ce budget.
Vérifie les deux limites avant de soumettre le job.
Un job doit aussi se terminer en 24 heures, temps d'attente de ses circuits dans la file compris, sinon il est arrêté sans résultat.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Calculer la taille de la fonction
Chaque job s'exécute à une taille de fonction, S, M ou L, qui sélectionne les ressources de calcul utilisées. Pour Rimay, la taille dépend du nombre de lignes qu'un job traite, lignes d'entraînement et de test confondues. Si tu demandes une taille trop petite, le job échoue avec l'erreur 4600. Pour les tailles et leurs limites, consulte Function sizes dans le guide Rimay.
La cellule suivante définit le calculateur de taille. Il s'exécute sur ta machine, ne lit que les données que tu lui passes et ne soumet rien.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Passe les jeux de données dans le même ordre que les fichiers de input_file, avec le mode de l'exécution :
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Étape 3 : Exécuter avec les primitives Qiskit
Exécute Rimay en mode fit-transform. Il ajuste une correspondance quantique de caractéristiques sur x_train.csv et y_train.csv, et l'applique aux ensembles d'entraînement et de test. L'ordre des fichiers dans input_file compte. Indique d'abord les caractéristiques d'entraînement, puis les étiquettes d'entraînement, puis les caractéristiques de test facultatives. Passe la taille que tu as calculée comme function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Surveiller le job
Vérifie l'état du job pendant son exécution. job.result() bloque jusqu'à la fin du job.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
Le résultat contient un mapping_id, qui identifie la correspondance ajustée par cette exécution. Tu n'en as pas besoin dans ce tutoriel, car l'ensemble de test a été traité dans la même exécution. Note cet ID si tu veux appliquer plus tard la correspondance à de nouvelles lignes avec mode="transform". C'est le seul moyen d'accéder à la correspondance ajustée, et sans lui, tu dois en ajuster une nouvelle et la payer. La correspondance est construite pour la disposition des qubits de ce processeur, donc une exécution transform ultérieure doit passer le même backend_name.
mapping_id = result["mapping_id"]
Étape 4 : Post-traiter et renvoyer le résultat dans le format classique souhaité
Télécharger les caractéristiques transformées quantiquement
Télécharge les fichiers écrits par le job, en utilisant les noms de output_files. Chaque nom commence par l'ID du job, donc les fichiers de cette exécution restent disponibles après les exécutions suivantes. Passe target_name pour que chaque fichier soit enregistré sous son propre nom.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Entraîner sur les caractéristiques transformées quantiquement
Entraîne une forêt aléatoire sur les seules caractéristiques transformées quantiquement.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Entraîner sur les caractéristiques classiques et quantiques combinées
Empile les caractéristiques d'origine et les caractéristiques transformées quantiquement, puis entraîne le même modèle sur la combinaison.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Comparer les résultats
Compare les trois modèles sur l'ensemble de test.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

L'AUC mesure dans quelle mesure un modèle classe les bons crédits au-dessus des mauvais, indépendamment d'un seuil de décision, ce qui en fait la métrique la plus informative sur ce jeu de données déséquilibré (70 % de bons crédits). Dans les benchmarks de Kipu Quantum, les caractéristiques transformées quantiquement seules ont atteint une AUC similaire à la référence classique, et le modèle hybride, qui combine les deux, a atteint la plus haute AUC et le meilleur score F1. Les caractéristiques transformées quantiquement apportent donc une information que les caractéristiques classiques ne fournissent pas seules.
Nettoyage (facultatif)
Une correspondance ajustée reste disponible jusqu'à ce que tu la supprimes. Si tu ne veux pas l'utiliser pour traiter d'autres données, supprime-la. Une suppression n'effectue aucun calcul quantique, n'utilise aucun temps de QPU et est irréversible.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Conclusion
Ce que tu as accompli
Dans ce tutoriel, tu as accompli les étapes suivantes :
-
Préparé un jeu de données réel de risque de crédit avec des attributs catégoriels et numériques pour l'extraction quantique de caractéristiques.
-
Établi une référence avec une forêt aléatoire classique.
-
Utilisé Rimay pour ajuster une correspondance quantique de caractéristiques sur du matériel quantique et traiter les ensembles d'entraînement et de test en une seule exécution.
-
Entraîné le même modèle sur les caractéristiques transformées quantiquement et sur les caractéristiques combinées, et comparé les résultats à la référence.
Points clés à retenir
-
Rimay s'intègre dans un pipeline d'apprentissage automatique existant comme une étape de prétraitement supplémentaire. Tu conserves ta préparation des données et ton modèle classique.
-
Le nombre de qubits borne le nombre de caractéristiques d'entrée, et le nombre de lignes multiplié par
shotsborne la taille d'un seul job. -
Utilise par défaut les caractéristiques transformées quantiquement combinées avec les caractéristiques d'origine, car le modèle peut exploiter les deux.
Étapes suivantes
- Lis le guide Rimay pour découvrir toutes les entrées, appliquer la correspondance à de nouvelles données avec
mode="transform"et voir d'autres benchmarks. - Lis comment l'extraction quantique de caractéristiques a été appliquée à la classification d'images satellites [3].
Références
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.